Por qué se rechaza un registro DNS por zone ID inválido
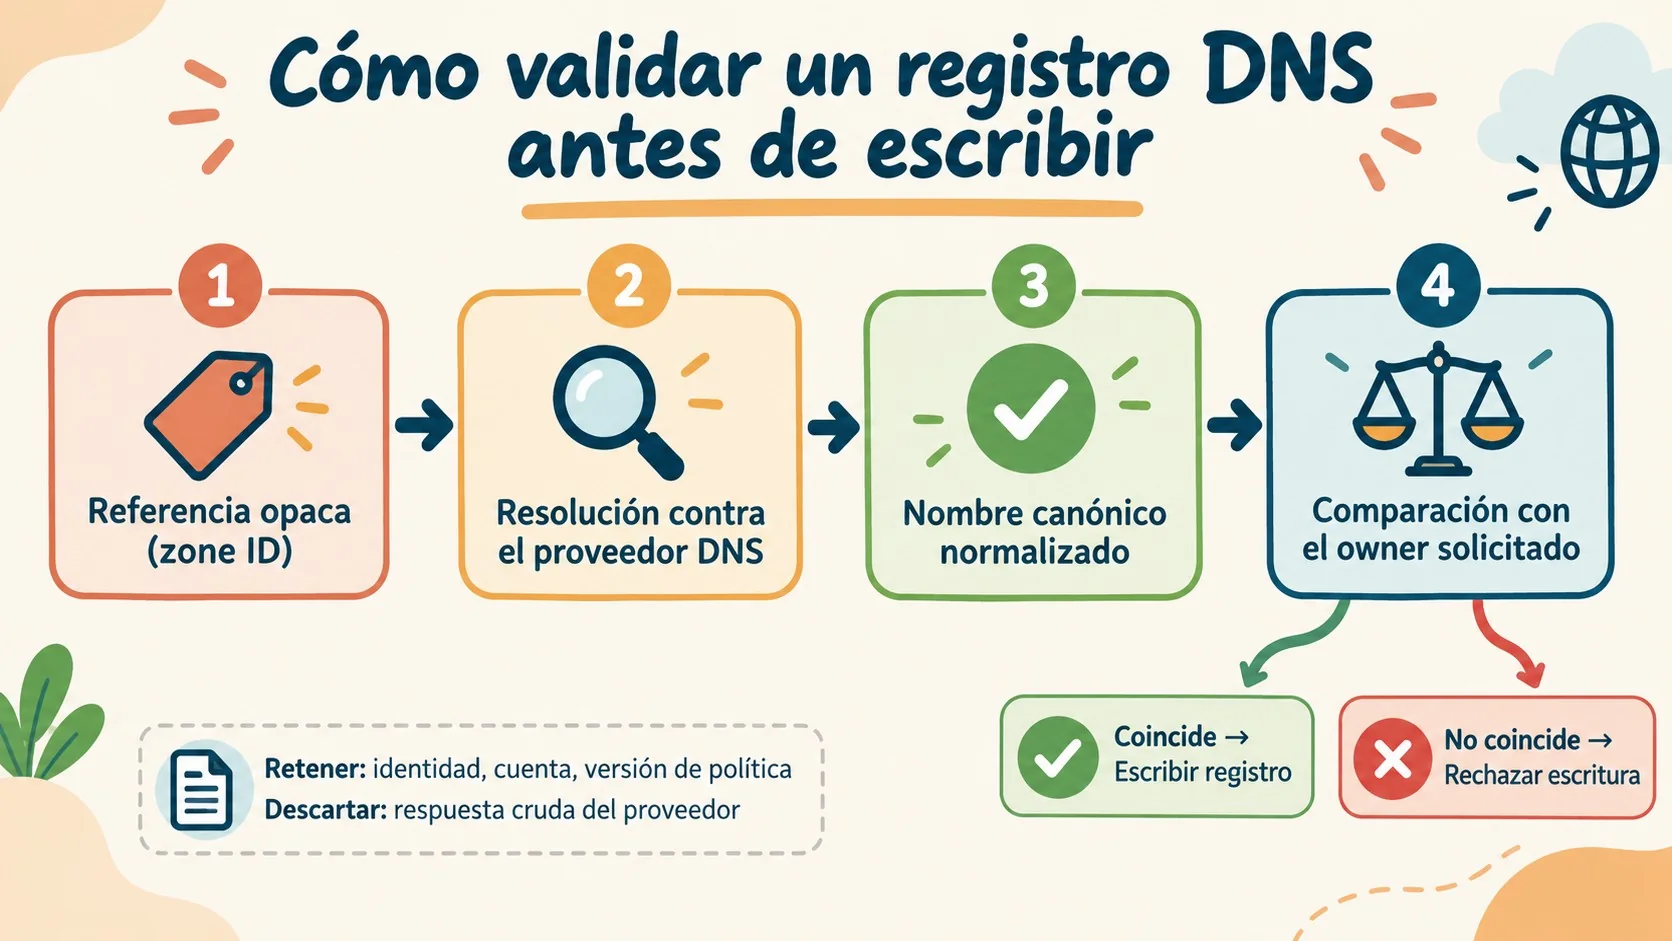
En pocas palabras: El rechazo pasa porque el sistema compara una referencia opaca del proveedor (tipo z_7f31) contra el nombre canónico (example.dev) sin resolverla antes. La corrección tiene tres pasos fijos: resolver la referencia, canonicalizar el nombre según RFC 1034 y recién ahí comparar contra el owner antes de escribir el registro.
En este artículo:
- En 30 segundos
- ¿Qué significa el error “zone ID is not domain name”?
- Ejemplo hipotético: cómo se ve el flujo completo
- ¿Por qué el owner puede quedar fuera de la autoridad resuelta?
- ¿Cómo evitar que una condición de carrera invalide la verificación?
- Criterios para decidir qué evidencia retener
- ¿Cómo se diferencia la autorización entre dominios de clientes y dominios de la plataforma?
- ¿Cómo testear esta validación sin acumular un dataset enorme?
- Errores comunes al validar zone ID contra dominio
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El zone ID es una referencia opaca del proveedor; el nombre de dominio es el valor canónico que devuelve el plano de control DNS. No son intercambiables aunque a veces el código los trate como si lo fueran.
- Según RFC 1034, los nombres DNS son case-insensitive y el punto final es solo de presentación, pero el límite de 63 octetos por etiqueta sí es una regla dura de validación.
- Una condición de carrera entre resolución y escritura (delete-and-recreate) puede invalidar la verificación si no se usa un token de concurrencia o versión.
- Conviene retener identidad normalizada, IDs de correlación y versión de política — no cada payload crudo del proveedor.
- Una matriz chica de seis casos de prueba (mayúsculas, punto final, apex, subdominio delegado, referencia desconocida, cuenta ajena) cubre el flujo sin acumular un dataset enorme.
Si administrás DNS para varios clientes desde una misma plataforma —el escenario típico de un hosting o un SaaS con dominios personalizados— tarde o temprano te vas a topar con este rechazo. Vale la pena entender qué lo dispara y, sobre todo, qué conviene guardar de esa verificación una vez que el registro ya quedó escrito, porque ahí es donde la mayoría de los sistemas se pasan de rosca en un sentido o en el otro.
¿Qué significa el error “zone ID is not domain name”?
Que el sistema recibió un identificador opaco del proveedor y lo trató como si ya fuera un nombre de dominio, sin pasar por el paso intermedio de resolución. El caso que ilustra esto, descrito en este análisis de debugging, es un cliente que manda z_7f31 mientras el control plane de DNS devuelve example.dev. Son dos valores que identifican cosas distintas, y si el código los compara directo, el write se rompe o —peor todavía— pasa cuando no debería.
El zone ID es un puntero interno del proveedor; no tiene por qué parecerse al dominio ni seguir ninguna convención legible. Convertirlo en nombre canónico es un paso obligatorio antes de cualquier comparación de autorización, no un detalle opcional que se salta cuando hay apuro por entregar la feature.
Ejemplo hipotético: cómo se ve el flujo completo
El siguiente caso es ilustrativo, no corresponde a ningún sistema real ni a datos verificados; sirve para mostrar cómo se aplican los criterios anteriores en un flujo de onboarding.
Supongamos una plataforma de hosting compartido donde un cliente conecta su dominio propio para recibir correo con DKIM. El formulario de onboarding guarda internamente la referencia ref_9c2a —un ID que el proveedor DNS le asignó a esa zona en su base interna— y el cliente escribe midominio.com.ar como el dominio que quiere validar. Antes de escribir el registro TXT de verificación, el flujo debería hacer tres cosas en este orden:
- Resolver
ref_9c2acontra el proveedor y obtener el nombre real de la zona (supongamos que devuelvemidominio.com.ar.). - Canonicalizar ese nombre según RFC 1034: sacarle el punto final, pasarlo a minúsculas.
- Comparar el resultado contra lo que escribió el cliente. Si coinciden, se autoriza el write; si el cliente hubiera puesto
midominio.com(sin el.ar) oapi.otrodominio.com, el sistema debería rechazar antes de tocar el registro.
Lo que falla en la práctica no suele ser el paso 3, sino saltarse el 1: comparar ref_9c2a directo contra midominio.com.ar porque “en el fondo son lo mismo dominio”. No lo son hasta que alguien los resuelve.
¿Por qué el owner puede quedar fuera de la autoridad resuelta?
Porque las reglas de comparación de nombres DNS no son arbitrarias, y si tu validación no las respeta, un nombre que en la práctica es idéntico termina rechazado —o al revés, uno que debería rechazarse pasa sin problema. RFC 1034 fija dos cosas puntuales: los nombres son case-insensitive, y el punto final al fondo del nombre es cuestión de presentación. Example.Dev y example.dev. tienen que compararse como el mismo nombre.
Acá está el matiz que se pisa seguido: esa normalización aplica al nombre del owner, no al contenido del registro. Si estás validando un TXT record, no le bajes las mayúsculas al valor solo porque normalizaste el nombre que lo posee —son campos con reglas distintas, y mezclarlos rompe la semántica del dato que después alguien va a tener que leer.
Hay una regla dura, en cambio, que sí bloquea escrituras legítimamente: ninguna etiqueta puede superar los 63 octetos según RFC 1034. Esa validación va junto al chequeo de identidad, no en un paso aparte que se ejecuta después.
La traza que sirve para debuggear esto tiene tres valores, ni uno más: la referencia enviada, el nombre canónico resuelto, y el owner normalizado. Con esos tres detectás un label de display que se coló en un campo de identificador, un mapeo viejo después de una transferencia de dominio, o un owner como api.otro.dev que cae fuera de la autoridad resuelta. Una resolución puede salir perfecta y el write seguir siendo inválido, porque las reglas de presentación de RFC 1034 no vuelven intercambiables un identificador opaco y un nombre DNS.
¿Cómo evitar que una condición de carrera invalide la verificación?
Compartiendo un mismo contexto de autorización entre el resolver y el writer, en lugar de tratarlos como dos pasos independientes separados en el tiempo. Si un delete-and-recreate puede cambiar el target entre la resolución y el commit, el preflight check terminó probando un objeto que ya no es el mismo que recibe la escritura.
La salida es llevar un token de versión o concurrencia que viaje junto con la decisión de autorización: resolvés, verificás, y esa verificación queda “sellada” con una versión. Si al momento de escribir la versión cambió, el sistema vuelve a resolver, no confía en el resultado viejo. ¿Y si no implementás esto? El preflight check te da una falsa sensación de seguridad mientras el write real termina apuntando a otro lado, y ese tipo de bug suele aparecer justo cuando menos lo esperás: en medio de una migración o una transferencia de dominio con tráfico en producción.
Criterios para decidir qué evidencia retener
No hay una respuesta única para “cuánto guardar” de cada verificación; depende de qué necesites poder reconstruir después. Estos criterios ayudan a decidir sin caer en los dos extremos problemáticos —guardar todo o guardar casi nada—:
- ¿Hay una obligación regulatoria de conservar copias inmutables? Si sí, usá un archivo append-only con controles de acceso explícitos y aceptá el costo extra de storage. Si no, la evidencia estructurada alcanza.
- ¿Necesitás replay byte a byte en algún escenario de auditoría? Un hash o request ID permite correlacionar, pero no reemplaza el payload original si alguien va a necesitar reconstruir la respuesta exacta del proveedor.
- ¿Tu flujo tiene reintentos? Si guardás una respuesta por cada intento, estás multiplicando la retención sin sumar confianza. Acotá los reintentos y hacé que la decisión sea idempotente: sobrescribir observaciones equivalentes en vez de apilarlas.
- ¿Guardás el mismo dato en dos lugares? Una fila de “estado actual” y un event stream que copian la misma respuesta completa duplican el payload antes de contar backups, réplicas y shipping de logs. Separá: estado actual chico con identidad canónica y versión de política, evento con solo la transición y un hash de correlación.
El punto de fondo, más allá de la checklist: el término que más pesa en el costo de retención suele ser la evidencia repetida, no los bytes del registro en sí. La regla práctica de corte es guardar lo estructurado necesario para explicar la decisión de onboarding, expirar las observaciones crudas en un plazo documentado, y hacer que los reintentos converjan en un solo resultado.
¿Cómo se diferencia la autorización entre dominios de clientes y dominios de la plataforma?
Cada boundary necesita un tipo de evidencia distinto, y convertir implícitamente una en otra es de los errores de seguridad más comunes en onboarding multi-tenant. Un dominio propiedad del cliente necesita evidencia que siga siendo válida después de que ese cliente transfiera su cuenta o su dominio: nombre canónico, cuenta al momento de la verificación, resultado de delegación, última resolución exitosa. Un dominio que pertenece a la plataforma traslada el control del ciclo de vida a la plataforma misma, pero la referencia interna sola no alcanza para explicar qué cliente estaba autorizado a usarlo.
| Boundary | Qué se escribe | Qué se retiene | Qué falla si no se detecta |
|---|---|---|---|
| Dominio del cliente | Referencia resuelta del cliente | Nombre, cuenta, delegación, versión de política | Cuenta incorrecta o delegación que cambió sin aviso |
| Dominio de la plataforma | Referencia interna de la plataforma | Mapeo de tenant y resultado de autorización | Referencia de un cliente usada en scope de plataforma |
Una referencia de cliente que por casualidad se parece a un token interno de plataforma sigue siendo el principal equivocado. Conviene que el modo de ownership sea un campo explícito de máquina de estados, y que cualquier cambio de modo dispare una decisión de autorización nueva —no heredada del estado anterior.
¿Cómo testear esta validación sin acumular un dataset enorme?
Con fixtures orientados a fallos, no con volumen. Seis casos alcanzan para cubrir los caminos reales de rechazo: nombre en mayúscula, punto final al fondo, un owner apex, un subdominio delegado, una referencia desconocida y una autoridad que pertenece a otra cuenta. Bajo control de versiones, esa matriz chica es mucho más fácil de auditar que un corpus generado sin límite que nadie termina revisando a mano.
- Assertion de contrato: la función de escritura nunca debería ejecutarse si la resolución o la autorización fallaron. Esto conviene testearlo explícito, no asumirlo.
- Métricas separadas por motivo: agrupar todo bajo un código HTTP genérico esconde que un owner fuera de autoridad, una referencia desconocida y un cambio de delegación tienen remediaciones completamente distintas.
- Un solo correlation ID: que se propague por lookup, normalización, autorización y commit, para poder seguir el rastro completo cuando algo falla en producción.
Errores comunes al validar zone ID contra dominio
- Comparar el identificador opaco directo contra el nombre: saltarse la resolución y comparar
z_7f31contraexample.devliteralmente. Nunca van a matchear porque son de naturalezas distintas. - Normalizar el record data igual que el owner: bajarle las mayúsculas a un TXT record porque el nombre del owner se normalizó. El contenido del registro no sigue las mismas reglas de presentación que el nombre.
- Duplicar el payload entre estado y evento: guardar la respuesta completa del proveedor tanto en la fila de “estado actual” como en el stream de eventos, multiplicando el costo de storage sin ganar trazabilidad real.
- Resolver y escribir en pasos desacoplados: hacer el preflight check en un momento y el commit en otro sin token de versión, dejando la puerta abierta a que un delete-and-recreate cambie el target en el medio.
Preguntas Frecuentes
¿Por qué se rechaza la escritura de un registro DNS por zone ID?
Porque el sistema comparó una referencia opaca del proveedor (el zone ID) contra un nombre de dominio sin resolverla primero a su forma canónica. Ambos identifican entidades distintas y no son intercambiables en la lógica de autorización.
¿Cuál es la diferencia entre un zone ID y un nombre de dominio?
El zone ID es un identificador interno y opaco que asigna el proveedor de DNS (por ejemplo z_7f31), mientras que el nombre de dominio es el valor canónico y legible que devuelve el plano de control (como example.dev). Uno requiere resolución para convertirse en el otro.
¿Cómo se valida la propiedad de un dominio antes de escribir en DNS?
Resolviendo la referencia opaca a su nombre canónico, normalizando ese nombre según las reglas de case-insensitivity y punto final de RFC 1034, y comparándolo contra el owner solicitado dentro del mismo contexto de autorización que después ejecuta el commit.
¿Qué datos conviene guardar al verificar un dominio de un cliente?
El nombre canónico, la cuenta al momento de la verificación, el resultado de delegación, la versión de política aplicada y un ID de correlación. El contenido crudo de la respuesta del proveedor puede expirarse después de la ventana de decisión, salvo que una regulación exija retención inmutable.
¿Qué dice RFC 1034 sobre la normalización de nombres DNS?
RFC 1034 establece que los nombres DNS son case-insensitive y que el punto final al fondo del nombre es una cuestión de presentación, no de identidad. También fija el límite de 63 octetos por etiqueta, una regla que sí bloquea la validación si se supera.
Conclusión
El error de “zone ID is not domain name” no es un bug raro: es la consecuencia directa de tratar dos identificadores distintos como si fueran uno solo. La corrección pasa por resolver, canonicalizar y comparar en ese orden, siempre dentro del mismo contexto de autorización que después ejecuta el write. Si administrás infraestructura DNS para clientes, especialmente en esquemas multi-tenant, vale la pena auditar si tu pipeline de onboarding retiene evidencia de más —payloads completos duplicados entre estado y evento— o de menos —solo un booleano sin trazabilidad. Ninguno de los dos extremos te deja bien parado cuando aparece una disputa o un incidente después de la ventana de expiración.