Por qué un rollout Kubernetes Deployment no arranca solo
En pocas palabras: Un rollout de Deployment en Kubernetes solo arranca si cambia el pod template (imagen, comando o labels); escalar réplicas no lo dispara. Con Azure, az sshkey create guarda la clave privada una única vez en un archivo local (no id_rsa): si se pierde, no hay forma de recuperarla.
Un rollout de Kubernetes Deployment arranca únicamente cuando cambia el pod template, nunca cuando escalás réplicas. Así lo repasa el día 51 de la serie KodeKloud Engineer, que también documenta cómo Azure entrega la clave privada SSH una sola vez, guardada en un archivo local con un nombre que no es id_rsa.
Un Deployment de Kubernetes es un objeto que gestiona ReplicaSets y Pods de forma declarativa: vos describís el estado deseado (imagen, réplicas, labels) y el controlador de Deployment ajusta el estado real hasta que coincida. Según la documentación oficial de Kubernetes, el rollout se dispara si y solo si cambia .spec.template, nunca por cambios de escala. Es una regla que parece obvia leída en frío, pero en la práctica es la fuente más común de “apliqué el cambio y no pasó nada”.
En este artículo:
- En 30 segundos
- ¿Qué cambio dispara realmente un rollout en Kubernetes?
- ¿Cómo actualizar la imagen de un Deployment sin downtime?
- ¿Qué significan maxUnavailable y maxSurge en RollingUpdate?
- ¿Por qué Kubernetes conserva el ReplicaSet anterior?
- ¿Cómo creás un par de claves SSH para VMs en Azure?
- ¿Qué pasa si perdés la clave privada SSH de Azure?
- AWS vs Azure: ¿cómo se entrega la clave privada al crear un key pair?
- Errores comunes al trabajar con rollouts y claves SSH
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un rollout de Deployment se dispara solo si cambia el pod template (imagen, comando, labels), no por escalar réplicas.
kubectl set imageusa el nombre del container, no el del Deployment: si no matchea, no pasa nada.- Con
maxUnavailableymaxSurgeen 25% por defecto, hasta un Deployment de una sola réplica actualiza sin downtime. - El ReplicaSet anterior queda en el clúster (hasta 10 por default) para habilitar
kubectl rollout undo. - Azure guarda la clave privada SSH una única vez en un archivo local; ninguna API la devuelve si la perdés.
¿Qué cambio dispara realmente un rollout en Kubernetes?
Solo un cambio en .spec.template dispara un nuevo rollout. Cambiar la cantidad de réplicas, agregar anotaciones sueltas o tocar campos fuera del pod template no arranca nada nuevo, el Deployment simplemente escala el ReplicaSet existente.
Esto genera confusión constante. Ponele que escalás de 3 a 10 réplicas esperando que Kubernetes reparta la nueva versión de tu app: no va a pasar, porque escalar no toca el template, solo el contador. El rollout necesita que cambie algo dentro de spec.template, típicamente la imagen del container, el comando, las variables de entorno o las labels del pod.
¿Por qué importa esta distinción? Porque si tenés un script de CI/CD que asume que “aplicar cualquier cambio” dispara un despliegue, te vas a encontrar con pipelines que terminan en verde sin haber actualizado un solo pod. Y ese es un fallo silencioso: no hay error, no hay warning, el comando devuelve éxito porque técnicamente hizo lo que se le pidió (escalar). El problema no está en Kubernetes, está en el supuesto equivocado de quien escribió el pipeline.
Ejemplo hipotético, solo para ilustrar la mecánica: imaginemos un equipo que tiene un Deployment con 3 réplicas de una API interna y decide subir a 6 réplicas para absorber más tráfico en un pico de demanda. Después de correr el escalado, alguien revisa kubectl get pods y ve 6 pods corriendo, todos con la misma imagen que tenían antes. Si ese equipo esperaba que el escalado también “renovara” los pods a la última build publicada en el registry, se va a encontrar con que no ocurrió: los 6 pods corren exactamente el mismo spec.template que los 3 originales, porque escalar no lo tocó. Para que la nueva imagen entre en juego, hace falta un kubectl set image (o un apply con el manifiesto actualizado) además del escalado, no en lugar de él.
¿Cómo actualizar la imagen de un Deployment sin downtime?
El camino más directo es kubectl set image deployment/nginx-deployment nginx-container=nginx:1.17, seguido de kubectl rollout status deployment/nginx-deployment para esperar el resultado. Antes conviene correr kubectl describe deployment nginx-deployment para confirmar el nombre exacto del container. Complementá con las diferencias entre Microsoft y GitHub.
Ese detalle del nombre del container es el error más común. set image toma el nombre del container definido en el pod template, no el nombre del Deployment. Si escribís mal ese nombre, kubectl no tira error visible: simplemente no hay tal container, y nada se actualiza (spoiler: te enterás recién cuando revisás que la imagen sigue vieja).
Hay tres formas de hacer este cambio: kubectl set image, kubectl edit deployment, o editar el manifiesto YAML y correr kubectl apply -f. Las tres disparan el mismo rollout, pero el estado que dejan en el clúster no es el mismo. Las primeras dos modifican el objeto vivo en el clúster sin tocar el archivo en disco, entonces la próxima vez que alguien aplique ese manifiesto desactualizado, pisa la imagen nueva con la vieja sin darse cuenta. Solo la ruta de apply mantiene el archivo como fuente de verdad real.
Un criterio simple para elegir entre las tres: si el manifiesto vive en un repo versionado y hay CI/CD de por medio, apply es la única opción defendible, porque cualquier otra deja el repo mintiendo sobre lo que corre en el clúster. set image tiene sentido para un cambio puntual y urgente, del tipo “necesito rollback ya” o “estoy debuggeando en un entorno descartable”, siempre que después alguien actualice el manifiesto a mano. kubectl edit es la opción más frágil de las tres: abre el objeto entero en un editor y es fácil tocar algo que no querías tocar, así que conviene reservarla para inspección rápida más que para cambios de rutina.
kubectl rollout status devuelve código de salida 0 si el rollout terminó bien y 1 si el Deployment superó su progressDeadlineSeconds, según documenta Kubernetes. Ese código de salida es lo que va en un script de CI, en vez de un sleep adivinado.
¿Qué significan maxUnavailable y maxSurge en RollingUpdate?
maxUnavailable define cuánto por debajo del número deseado de réplicas puede caer el Deployment durante la actualización, redondeando hacia abajo. maxSurge define cuánto por arriba puede subir, redondeando hacia arriba. Ambos valen 25% por defecto en la estrategia RollingUpdate.
Esa dirección del redondeo es lo que hace posible actualizar sin gap incluso con una sola réplica. Con un pod, 25% de maxUnavailable redondea a cero (no podés bajar de 1 a algo negativo), y 25% de maxSurge redondea hacia arriba a uno. El resultado: Kubernetes primero crea el pod nuevo, después borra el viejo. Ni un segundo sin pod respondiendo. Sobre eso hablamos en conectarte por SSH a tu VM.
Con 4 réplicas y los defaults, el Deployment garantiza al menos 3 pods disponibles y como máximo 5 en total durante la transición, según el ejemplo de la documentación de Kubernetes. El tema es que estos números son ajustables por Deployment, y ahí conviene pensar en función del tipo de carga: si tu app tolera perfectamente que falte un pod por unos segundos (una API idempotente detrás de un balanceador con retries), subir maxUnavailable acelera el rollout sin costo real. Si en cambio cada pod perdido implica trabajo en curso que se pierde o conexiones largas que se cortan, tiene más sentido bajar maxUnavailable a cero y dejar que maxSurge haga todo el trabajo, aunque el rollout tarde más.
¿Por qué Kubernetes conserva el ReplicaSet anterior?
Kubernetes no modifica el ReplicaSet existente cuando actualizás la imagen: crea uno nuevo. El ReplicaSet nuevo escala hacia arriba, el viejo escala a cero, y ese viejo se conserva en el clúster en vez de borrarse.
Por default se guardan hasta 10 ReplicaSets históricos por Deployment. Ese ReplicaSet retenido, con réplicas en cero pero presente, es exactamente lo que kubectl rollout undo usa para volver atrás sin tener que reconstruir nada desde cero. Podés confirmarlo corriendo kubectl get replicasets después de un update: vas a ver el ReplicaSet activo con réplicas y el anterior con “0 0 0” en sus columnas de estado.
¿Cómo creás un par de claves SSH para VMs en Azure?
El comando az sshkey create --name "$KEY_NAME" --resource-group "$RG" crea un recurso Microsoft.Compute/sshPublicKeys, cuya única propiedad relevante es la clave pública. No hay lugar dentro de ese recurso donde viva una clave privada.
Lo que Microsoft documenta es que, además de crear el recurso en Azure, cada clave nueva se guarda en un archivo local, y la salida del comando te dice dónde: algo como Private key is saved to "/root/.ssh/1757564000_123456" y Public key is saved to "/root/.ssh/1757564000_123456.pub". Ese archivo es la única copia de la clave privada que va a existir jamás. Ninguna llamada a la API de Azure CLI te la devuelve después.
El nombre del archivo es la otra trampa. No es id_rsa, así que ssh no lo va a encontrar automáticamente. Cada login necesita -i con el path completo, o hay que renombrar el archivo a algo memorable apenas se crea.
¿Qué pasa si perdés la clave privada SSH de Azure?
Si perdés ese archivo, el par de claves queda inútil para login: no hay recuperación posible, hay que generar un par nuevo y resetear el acceso en cada VM que usaba la clave vieja. Ninguna API de Azure devuelve la clave privada después de creada. Relacionado: qué certificación de Azure conviene según tu rol.
Hay un error de sintaxis que aparece seguido al subir una clave existente con --public-key @~/.ssh/nautilus-key.pub. El símbolo @ le indica a la CLI que lea el valor desde un archivo, correcto hasta ahí. El problema es que bash solo expande el tilde (~) cuando está al inicio de una palabra, y después de @ ya no está al inicio, entonces el shell pasa el tilde tal cual, sin expandir, y el comando falla buscando un archivo literal llamado ~/.ssh/nautilus-key.pub. La forma que funciona es @$HOME/.ssh/nautilus-key.pub, porque $HOME se expande en cualquier posición de la palabra.
Ejemplo hipotético: supongamos que alguien automatiza la creación de VMs en un pipeline y guarda el comando az sshkey create --public-key @~/.ssh/deploy-key.pub ... en un script que corre bien en su terminal local (donde quizás el shell configurado sí expande el tilde en ese contexto, o el archivo simplemente existe con otro nombre por casualidad) pero falla apenas se ejecuta en un runner de CI con bash estricto. El error que devuelve la CLI no dice “tu tilde no se expandió”, dice que no encuentra el archivo, lo cual lleva a horas de debugging revisando permisos y rutas antes de notar que el problema es la posición del ~ respecto al @.
Un dato que rompe un mito bastante instalado: borrar el recurso de la clave SSH en Azure no bloquea a nadie de las VMs ya creadas con ella. La clave pública se copió dentro de cada VM en el momento de crearla, y la VM no mantiene un vínculo activo con el recurso. Ese recurso es una comodidad para el provisioning, no un punto de control de acceso. Vale la pena internalizar esto porque cambia el criterio de limpieza: borrar recursos sshPublicKeys viejos en Azure es seguro desde el punto de vista del acceso, no es un paso de “revocación” real.
AWS vs Azure: ¿cómo se entrega la clave privada al crear un key pair?
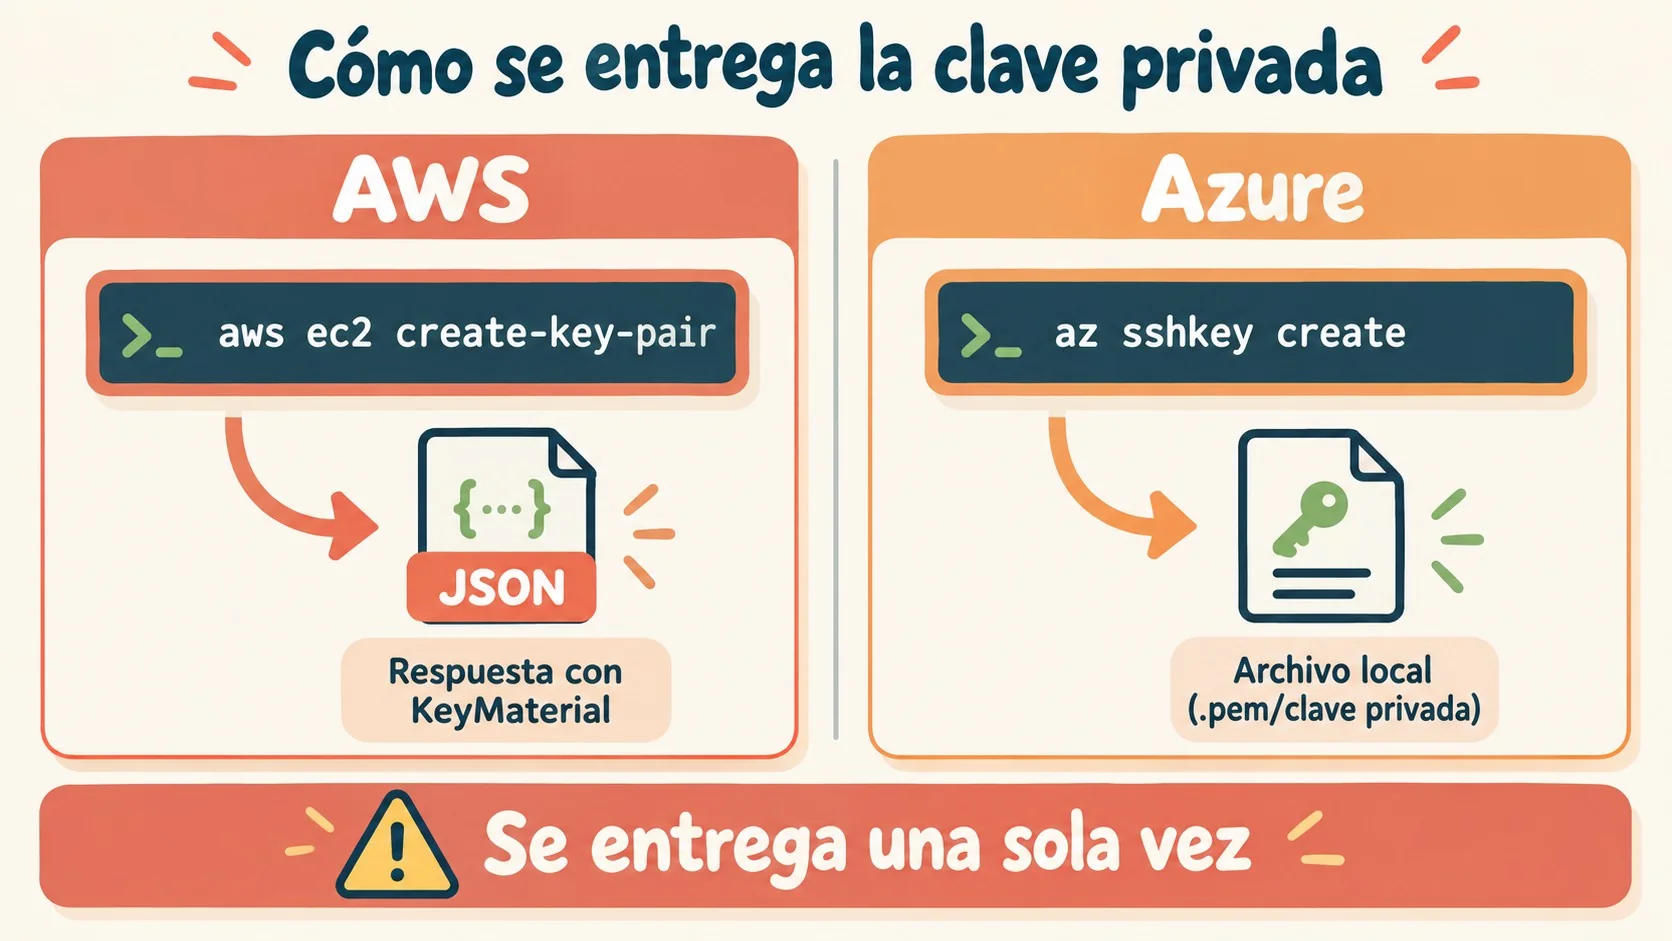
AWS devuelve la clave privada dentro del campo KeyMaterial de la respuesta JSON al ejecutar aws ec2 create-key-pair; Azure la escribe en un archivo local al ejecutar az sshkey create. En ambos casos es una entrega única: si no la capturás en ese momento, se fue.
La diferencia práctica es dónde falla la gente. Con AWS, olvidarte de capturar KeyMaterial significa que la clave scrollea por la terminal una sola vez y desaparece. Con Azure, el archivo queda guardado, más difícil de perder por completo, pero el nombre no estándar hace que la gente lo pierda de vista o no sepa dónde quedó.
| Aspecto | AWS | Azure |
|---|---|---|
| Comando | aws ec2 create-key-pair | az sshkey create |
| Entrega de clave privada | Devuelta en KeyMaterial dentro de la respuesta | Escrita en un archivo local |
| Alcance del recurso | Solo en la región donde se creó | Resource group más ubicación |
| Tipo por defecto | RSA | RSA |
Errores comunes al trabajar con rollouts y claves SSH
- Usar el nombre del Deployment en
set image. El comando necesita el nombre del container definido en el pod template, no el del Deployment. Si no matchea, no hay error visible, simplemente nada cambia. - Esperar un rollout después de escalar réplicas. Escalar no toca
spec.template, así que nunca dispara un nuevo rollout. Si necesitás que se actualicen los pods, tenés que cambiar algo dentro del template. - Editar el Deployment en vivo con
kubectl edity dejar el manifiesto YAML desactualizado. La próxima vez que alguien corrakubectl apply -fcon ese archivo viejo, pisa el cambio sin darse cuenta. - Subir una clave pública en Azure con ruta relativa a home usando tilde después del
@. Bash no expande~ahí, así que el comando falla. Usá$HOMEen su lugar. - Confiar en que borrar el recurso SSH de Azure revoca acceso a las VMs. No es así: la clave pública ya está copiada en cada VM y no depende del recurso original.
Preguntas Frecuentes
¿Por qué un rollout de Kubernetes no se dispara al escalar réplicas?
Porque un rollout se dispara únicamente cuando cambia .spec.template, el bloque que define imagen, comando y labels del pod. Escalar réplicas modifica .spec.replicas, un campo distinto que Kubernetes trata como una operación de escala, no de actualización. Esto se conecta con lo que analizamos en los repos de GitHub comprometidos con malware.
¿Dónde guarda Azure la clave privada al crear un SSH key pair?
Azure escribe la clave privada en un archivo local, con un nombre generado automáticamente que no es id_rsa. El comando az sshkey create muestra la ruta exacta en su salida, y esa es la única copia que va a existir.
¿Qué significan maxUnavailable y maxSurge en un Deployment?
maxUnavailable es cuánto puede bajar el número de pods disponibles durante una actualización, redondeando hacia abajo. maxSurge es cuánto puede subir por encima del total deseado, redondeando hacia arriba. Ambos valen 25% por defecto en la estrategia RollingUpdate.
¿Cómo hago rollback de un Deployment en Kubernetes?
Corriendo kubectl rollout undo deployment/nombre-del-deployment, que vuelve al ReplicaSet anterior retenido por el Deployment. Por default Kubernetes guarda hasta 10 ReplicaSets históricos, lo que permite volver atrás sin reconstruir nada.
¿Puedo recuperar la clave privada SSH si la borro en Azure?
No. Ninguna API de Azure devuelve la clave privada después de creada. Si la perdés, la única salida es generar un par nuevo y resetear el acceso SSH en cada VM que dependía de la clave anterior.
Conclusión
La regla de fondo es simple pero se olvida seguido: un rollout de Kubernetes Deployment depende del pod template, no de cuántas réplicas tengas corriendo. Si tu pipeline asume lo contrario, vas a tener despliegues que “terminan bien” sin haber actualizado un solo pod. Del lado de Azure, la lección es igual de directa: la clave privada SSH se entrega una sola vez, en un archivo con nombre no estándar, y nadie te la va a devolver después.
Un criterio práctico para no llevarte sorpresas: antes de dar por hecho que un despliegue se aplicó, corré kubectl get replicasets y confirmá que existe un ReplicaSet nuevo con la imagen esperada, en vez de confiar solo en que el comando no tiró error. Y con cualquier clave SSH que generes en la nube, copiá el archivo de la clave privada a un gestor de secretos apenas se crea, porque esa ventana de “te la muestro una vez” no vuelve.
Si estás armando infraestructura propia con VMs y necesitás dónde alojar los servicios que corren detrás de esos clústeres, donweb.com es una alternativa a tener en cuenta para hosting y dominios en Argentina.