Docker en producción: de 18 minutos a 45 segundos
En pocas palabras: Docker enterprise-grade significa cache remoto con BuildKit (baja builds de 18 minutos a 45 segundos), imágenes multi-arquitectura vía OCI Manifest Lists para ARM64 y AMD64, y tagging inmutable por Git SHA en vez de “:latest” para permitir rollbacks instantáneos sin reconstruir código.
Tres prácticas separan un docker build de laptop de un pipeline que sostiene 200 ingenieros mergeando código todos los días: cache remoto con BuildKit, imágenes multi-arquitectura y tagging inmutable por Git SHA. Un análisis técnico publicado en Dev.to describe estas tres prácticas en detalle; acá las repasamos con foco en cómo priorizarlas según el tamaño de tu equipo y qué significan si laburás sobre infraestructura en Latinoamérica.
Docker en producción es el conjunto de prácticas que convierten un contenedor que corre en tu máquina en un artefacto reproducible, versionado y portable entre arquitecturas, listo para correr en runners efímeros de CI/CD y en clusters de Kubernetes sin sorpresas. No es lo mismo que “levantar un contenedor”: implica cache compartido entre builds, compatibilidad de CPU y trazabilidad total de cada deploy.
En este artículo:
- En 30 segundos
- ¿Por qué un docker build básico no alcanza en equipos grandes?
- ¿Cómo funciona el cache remoto de BuildKit y por qué baja los tiempos de build de 18 minutos a 45 segundos?
- ¿Qué pasa si subo una imagen ARM64 a un servidor AMD64?
- ¿Qué es un OCI Manifest List y cómo soluciona el problema multi-arquitectura?
- ¿Por qué el tag :latest es peligroso en producción?
- ¿Cómo tagear imágenes con Git SHA para rollback instantáneo?
- Criterios de decisión: ¿por dónde empezar según tu equipo?
- Qué significa esto para equipos en Latinoamérica
- Errores comunes al llevar Docker a producción
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- BuildKit con cache remoto en ECR o JFrog Artifactory achica builds de 18 minutos a 45 segundos en pipelines con runners efímeros.
- Un binario ARM64 corriendo en un host AMD64 tira directamente
exec format error, sin ambigüedad. - Un OCI Manifest List agrupa capas ARM64 y AMD64 bajo un mismo tag, y el runtime elige sola la que corresponde.
- El tag
:latestes un puntero que cambia con cada build, no una versión fija, y complica identificar qué código está corriendo. - Tagear con el SHA de Git (ej:
checkout-api:sha-a8f3b91) permite rollback conkubectl rollout undoen segundos, sin recompilar nada. - Si tenés que elegir por dónde arrancar: el tagging por SHA es el cambio de menor costo y mayor impacto inmediato, independientemente del tamaño del equipo.
¿Por qué un docker build básico no alcanza en equipos grandes?
Porque los runners de CI/CD son efímeros: se crean en blanco, ejecutan el pipeline y se destruyen, sin memoria de builds anteriores. Si cada Pull Request dispara un docker build . sin cache, el runner tiene que bajar la imagen base de nuevo, reinstalar cientos de dependencias y recompilar todo desde cero.
Ejemplo hipotético: pensemos en un equipo de pagos, con un checkout service, donde alguien cambia una sola línea de código. Si ese build sin cache tarda 18 minutos y el equipo mergea 50 veces por día, ahí hay horas de productividad de ingenieros quemadas mirando una barra de progreso que no tendría por qué existir.
El tema es que esto no es un problema de “Docker es lento”. Es un problema de arquitectura de pipeline. Plataformas con cientos de ingenieros mergeando a diario (pensá en algo del volumen de Netflix o Uber) no pueden depender de que cada corrida empiece de cero. Ahí es donde entra docker en producción como disciplina, no como comando suelto.
¿Cómo funciona el cache remoto de BuildKit y por qué baja los tiempos de build de 18 minutos a 45 segundos?
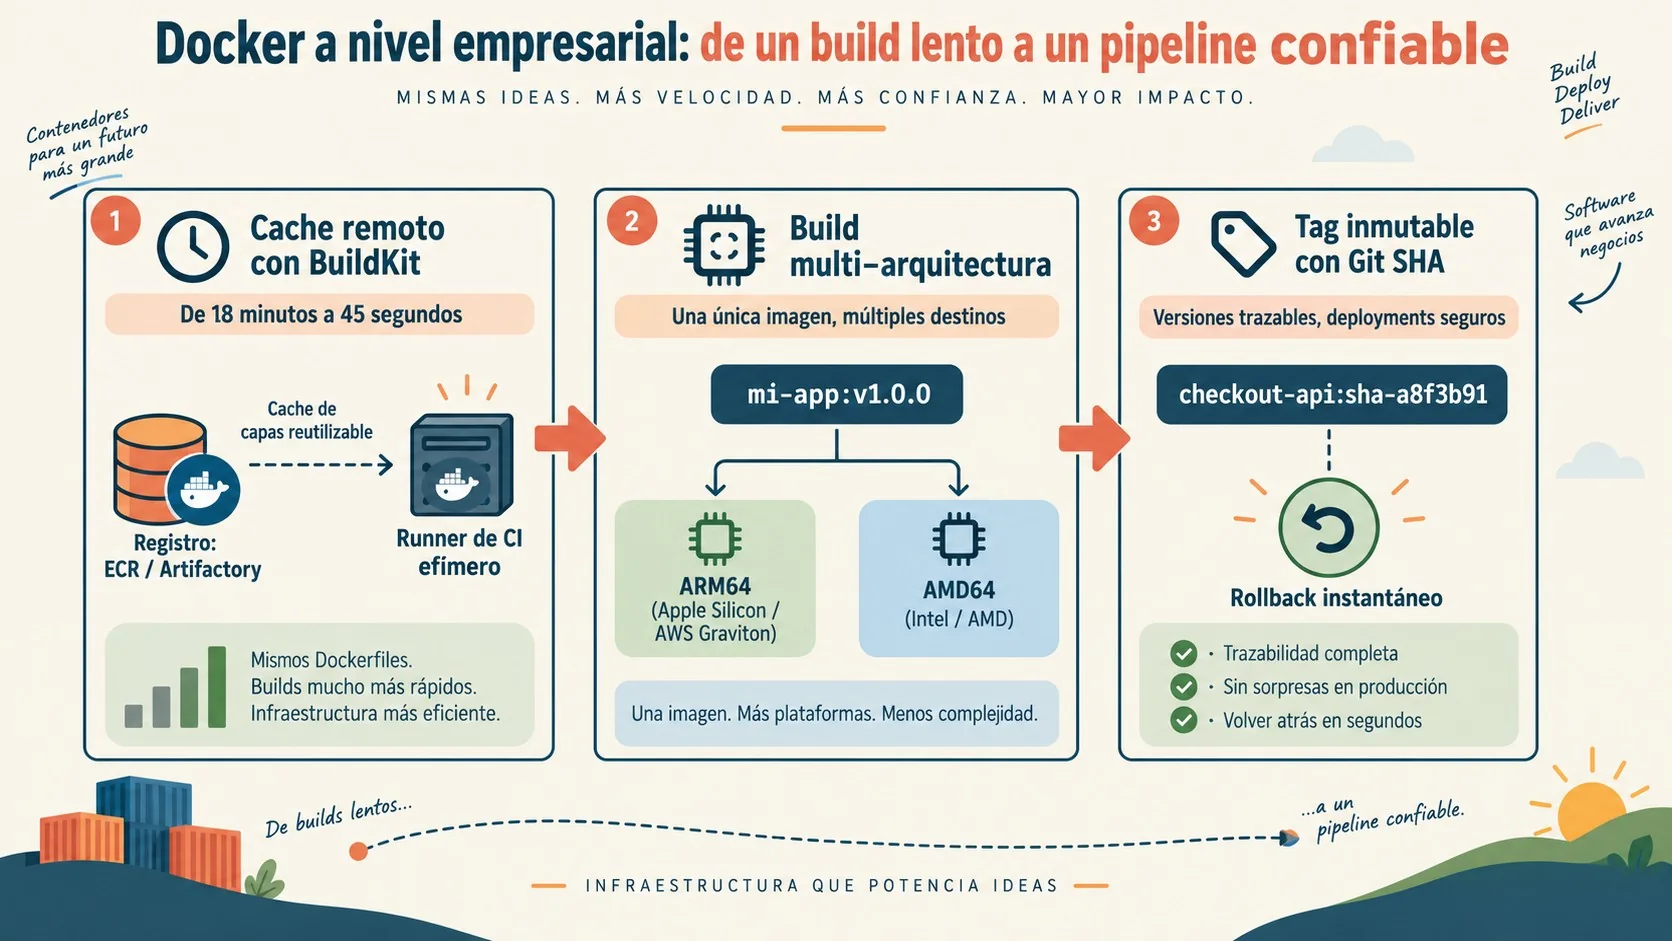
BuildKit, el motor de ejecución que trae Docker moderno, soporta backends de cache externos como Amazon ECR o JFrog Artifactory: en vez de guardar las capas en el disco de una sola máquina, las empuja al registry. Cuando un runner nuevo arranca, baja solo las capas que necesita en lugar de reconstruir todo. Sobre infraestructura de proxy y runners en producción, también puede servirte configurar Caddy como proxy en producción.
El comando típico se ve así:
docker buildx build --push --tag 123456789012.dkr.ecr.us-east-1.amazonaws.com/my-app:latest --cache-to type=registry,ref=.../my-app:cache,mode=max --cache-from type=registry,ref=.../my-app:cache .
Ahora bien, hay un malentendido bastante común: mucha gente piensa que Docker “descarga solo la capa que cambió”. No es así. Docker lee el Dockerfile de arriba hacia abajo: las instrucciones previas al cambio se recuperan del cache remoto, pero una vez que una capa se invalida (por ejemplo, un COPY . . después de modificar código), esa capa y todas las de abajo se ejecutan de nuevo en el runner. No se “descargan”, se ejecutan.
Ejemplo hipotético: supongamos un Dockerfile con cinco pasos: instalar el sistema base, instalar dependencias del lenguaje, copiar el código, compilar y correr tests. Si solo cambiás una línea en el código de la app, los primeros dos pasos (sistema base y dependencias) se recuperan del cache remoto tal cual estaban. Pero el paso de copiar código, y todo lo que viene después (compilar, testear), se vuelve a ejecutar desde cero en el runner, aunque el 90% del Dockerfile no haya cambiado.
- Evaluación top-to-bottom: cada instrucción del Dockerfile se procesa en orden secuencial.
- Invalidación downstream: un cambio en una línea invalida esa capa y todas las posteriores.
- mode=max en –cache-to: exporta capas intermedias de todos los stages en builds multi-stage, no solo la imagen final.
El caso descripto en el artículo de referencia reporta builds que pasan de 18 minutos a 45 segundos aplicando esto. Ese número depende del tamaño de la imagen y de cuánto cambie realmente el código en cada PR, así que conviene tomarlo como techo optimista, no como garantía para cualquier proyecto.
¿Qué pasa si subo una imagen ARM64 a un servidor AMD64?
Falla al toque con un error de kernel, exec format error, porque un binario compilado para ARM64 no corre sobre un set de instrucciones AMD64. No es un bug raro ni algo que se arregla reiniciando: es incompatibilidad de arquitectura, punto.
Esto pasa seguido porque el hardware de desarrollo casi nunca coincide con el de producción. Los developers suelen programar en Apple Silicon (ARM64), buena parte de la infraestructura legacy corre en Intel Xeon o AMD EPYC (AMD64), y la nube moderna empuja fuerte instancias ARM como AWS Graviton por una relación precio-rendimiento mejor. Mezclar todo eso sin un proceso de build que contemple ambas arquitecturas es jugar a la ruleta.
Manejar esto con tags manuales tipo app:v1.0-arm y app:v1.0-amd funciona en un README, pero en la práctica genera manifiestos de deploy frágiles y errores humanos apenas alguien se olvida de actualizar un pipeline.
¿Qué es un OCI Manifest List y cómo soluciona el problema multi-arquitectura?
Un OCI Manifest List (o Image Index) es un catálogo que agrupa, bajo un mismo tag, las capas compiladas para distintas arquitecturas, de forma que el runtime del host elige automáticamente la versión correcta al hacer docker pull. No hay un binario universal: hay un índice que apunta a la variante que corresponde. Si además estás endureciendo la seguridad de esos contenedores, puede interesarte sumar un WAF para proteger tus contenedores.
El build se arma con un solo comando:
docker buildx build --platform linux/amd64,linux/arm64 --tag .../my-app:v1.0.0 --push .
Cuando un servidor Intel hace pull de my-app:v1.0.0, baja las capas AMD64. Cuando un worker Graviton o un Mac M-series pide ese mismo tag, baja las capas ARM64. Un solo nombre de imagen, dos binarios distintos atrás. Es un golazo para equipos que mezclan infraestructura on-premise vieja con cloud nuevo.
¿Por qué el tag :latest es peligroso en producción?
:latest es un puntero flotante que se reasigna cada vez que se construye una imagen sin tag explícito, no una versión estable. Dos builds distintos pueden terminar con el mismo nombre apuntando a código completamente diferente.
Ejemplo hipotético (adaptado del caso descripto en la fuente): a la 1:55 AM alguien mergea un cambio que pushea checkout-api:latest. A las 2:00 AM saltan las alarmas de errores de pago. El ingeniero de guardia revisa los pods y ve image: checkout-api:latest.
¿Y ahí qué hace? Nada útil, porque ese tag no le dice qué commit está corriendo. Tiene que ponerse a bucear logs a mano para encontrar el cambio responsable, y ni siquiera un restart del pod garantiza volver a la versión anterior si el nodo ya tiene cacheada la imagen con ese mismo nombre “latest”. Es, literalmente, el peor momento para descubrir que nadie tagueó nada con sentido.
¿Cómo tagear imágenes con Git SHA para rollback instantáneo?
Tagueando cada imagen que sale de un build con el hash del commit que la generó, tipo checkout-api:sha-a8f3b91, en vez de con un nombre genérico. Esto da dos cosas que importan de verdad: trazabilidad determinística (si ese tag explota, buscás a8f3b91 en Git y ves exactamente qué cambió) y rollback sin rebuild.
El rollback, en Kubernetes, se reduce a un comando:
kubectl rollout undo deployment/checkout-api
Sin recompilar, sin esperar un pipeline nuevo, sin cruzar los dedos. Volvés al SHA anterior en segundos porque esa imagen ya existe, versionada, en el registry. De las tres prácticas de esta nota, esta es la que menos infraestructura nueva requiere: no necesitás configurar un backend de cache ni tocar tu Dockerfile para empezar a tagear por SHA mañana mismo.
Criterios de decisión: ¿por dónde empezar según tu equipo?
No todas las prácticas pesan igual según el contexto. Una forma razonable de priorizar, en base a la lógica de cada problema descripta arriba:
- Si recién estás arrancando o tenés pocos builds por día: empezá por tagging con Git SHA. Es un cambio de configuración de pipeline, no de infraestructura, y elimina de raíz el escenario del “rollback a ciegas” sin pedir nada más.
- Si tus builds tardan varios minutos y mergeás seguido (varias veces por día, varios devs): priorizá cache remoto con BuildKit. El tiempo ganado se multiplica por cada build diario, así que el retorno es proporcional al volumen de PRs del equipo.
- Si tu infraestructura es mixta (devs en Mac M-series, servidores Intel heredados, o estás migrando parte de la carga a instancias ARM tipo Graviton): priorizá el soporte multi-arquitectura antes de que aparezca el primer
exec format erroren un deploy, no después.
En la práctica, las tres prácticas no son excluyentes y terminan implementándose juntas, pero si los recursos de ingeniería son limitados, este orden reduce el riesgo de quedarte a mitad de camino en las tres a la vez.
Qué significa esto para equipos en Latinoamérica
Los problemas técnicos de arriba (cache, arquitectura, tagging) no cambian por estar en Argentina, Chile o México: un pipeline mal cacheado tarda lo mismo en minutos de más esté donde esté el runner. Lo que sí cambia es el costo relativo de no resolverlo, porque en equipos chicos hay menos gente para repartir el tiempo perdido esperando builds.
Si estás evaluando dónde correr tu registry privado o tus runners de CI en la región, estos son criterios concretos para comparar opciones (más allá del precio de lista, que conviene pedir cotizado a cada proveedor):
- Latencia entre el runner de CI y el registry: si el cache remoto vive lejos geográficamente del runner, parte de la ganancia de velocidad de BuildKit se pierde en transferencia de red.
- Costo de egress por pulls frecuentes: con cache remoto, cada build nuevo baja capas del registry; en pipelines con muchos builds diarios, ese tráfico repetido puede pesar en la factura según cómo cobre el proveedor el tráfico saliente.
- Disponibilidad de instancias ARM: si pensás aprovechar la relación precio-rendimiento de arquitecturas ARM (como se menciona arriba con Graviton), conviene chequear si el proveedor local las ofrece antes de diseñar el pipeline multi-arquitectura.
- Soporte técnico en español y huso horario: en un incidente a las 2 AM como el del ejemplo de
:latest, la diferencia entre resolver rápido o escalar un ticket en otro idioma y otro huso horario importa.
Errores comunes al llevar Docker a producción
- Usar :latest “solo por ahora”: ese “por ahora” se convierte en el tag de producción permanente porque nadie vuelve a cambiarlo después del primer deploy exitoso.
- Cachear solo el target final: sin
mode=max, las capas intermedias de builds multi-stage no se exportan, y el ahorro de tiempo es mucho menor al esperado. - Asumir que “funciona en mi Mac” implica que funciona en el servidor: si no armás la imagen con
--platform linux/amd64,linux/arm64, un Mac M-series puede generar una imagen que explota conexec format erroren un EC2 Intel. - Confundir restart con rollback: reiniciar un pod con un tag flotante no garantiza volver a una versión anterior, sobre todo si el nodo tiene esa imagen cacheada localmente.
Preguntas Frecuentes
¿Por qué mi build de Docker tarda tanto en el pipeline de CI/CD?
Porque el runner es efímero y no tiene cache local de builds anteriores, así que vuelve a descargar la imagen base y reinstalar dependencias desde cero en cada ejecución. Configurar cache remoto con BuildKit apuntando a un registry (ECR, JFrog Artifactory) resuelve esto directamente.
¿Qué es el cache remoto de BuildKit y cómo se configura?
Es un backend de cache externo al que BuildKit exporta e importa capas de build usando las flags --cache-to y --cache-from con type=registry. Usar mode=max asegura que se exporten también las capas intermedias de builds multi-stage, no solo la imagen final.
¿Por qué no se debe usar el tag :latest en producción?
Porque :latest es un puntero que se reasigna con cada build sin tag explícito, no una versión fija, lo que hace imposible saber qué código corre en un pod con solo mirar el nombre de la imagen. En un incidente, esto retrasa la identificación del commit responsable.
¿Cómo hago una imagen Docker que funcione en ARM64 y AMD64?
Usando docker buildx build --platform linux/amd64,linux/arm64 para generar ambas variantes bajo un mismo tag, empaquetadas en un OCI Manifest List. El runtime de destino detecta su propia arquitectura y descarga automáticamente las capas correspondientes.
¿Cómo hago rollback rápido de un contenedor en Kubernetes?
Si tagueaste tus imágenes con el SHA del commit (por ejemplo checkout-api:sha-a8f3b91), el comando kubectl rollout undo deployment/checkout-api vuelve al deploy anterior en segundos, sin necesidad de recompilar nada. Esto no funciona de forma confiable si venís usando :latest para todo.
Conclusión
Pasar de un docker build de desarrollo a docker en producción a escala enterprise no es aprender un comando nuevo: es rediseñar el pipeline con cache remoto, soporte multi-arquitectura y tagging inmutable. Son tres cambios concretos y medibles (builds de 18 minutos a 45 segundos en el caso de referencia) que no requieren reescribir la aplicación. Si tu equipo todavía despliega con :latest o recompila desde cero en cada PR, el primer paso realista —el de menor costo y mayor impacto inmediato— es dejar el tagging por SHA como norma y recién después meter cache remoto en el pipeline de CI.