Minions de Apple: la nube de GPU hecha con Macs ociosas
En pocas palabras: Minions es la nube de GPU virtual y distribuida de Apple que reúne las GPU ociosas de Macs con Apple Silicon para correr inferencia de machine learning. Según su paper del 9 de octubre de 2026, trabajos que esperaban más de diez horas ahora suelen empezar en minutos.
Minions agrega las GPU inactivas de dispositivos macOS con Apple Silicon para ejecutar inferencia de machine learning a gran escala. Está pensada para equipos que no consiguen GPU en la infraestructura centralizada, donde el costo es alto, la elasticidad es baja y las colas son largas. El paper lo firman Jianhua Li, Yun Xing, Girisha De Silva, Ryan Flint, Kai Yuan y Sean Suchter. Lo más interesante no es la potencia de las Macs sino la idea: atacar la espera con hardware que ya está comprado.
En este artículo:
- En 30 segundos
- ¿Por qué Apple usa Macs ociosas en lugar de comprar más GPU?
- ¿Cómo funciona Minions de Apple por dentro?
- ¿Qué resultados reporta Apple y cómo hay que leerlos?
- ¿Minions de Apple es un producto disponible o un sistema interno?
- ¿Qué límites tiene frente a un clúster de GPU tradicional?
- ¿Cómo decidir si vale la pena copiar la idea?
- ¿Qué está confirmado y qué no sobre Minions?
- Errores comunes al leer esta noticia
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Qué es: una nube de GPU virtual armada con Macs ociosas, descrita en el paper de arXiv 2610.12970 (enviado el 9/10/2026).
- Qué resultado reporta: colas de más de diez horas que pasan a minutos, según el propio paper de Apple.
- Qué corre: inferencia de machine learning. Las fuentes no mencionan entrenamiento.
- Disponibilidad: las fuentes no mencionan producto, precio ni acceso público.
¿Por qué Apple usa Macs ociosas en lugar de comprar más GPU?
Según la ficha oficial de Apple Machine Learning Research, la infraestructura de GPU centralizada tiene costo alto, poca elasticidad y esperas largas cuando los recursos escasean. Las GPU de las Macs, en cambio, quedan en gran parte sin uso en el día a día. Minions permite a los equipos aprovechar hardware existente sin comprar GPU adicionales.
Como contexto previo, en noviembre de 2025 Apple publicó un trabajo sobre cómo correr LLM en Mac con MLX y los aceleradores neuronales de la GPU del M5. Minions apunta a otra cosa: en lugar de exprimir una máquina, reparte la capacidad que ya hay entre muchas.
¿Cómo funciona Minions de Apple por dentro?
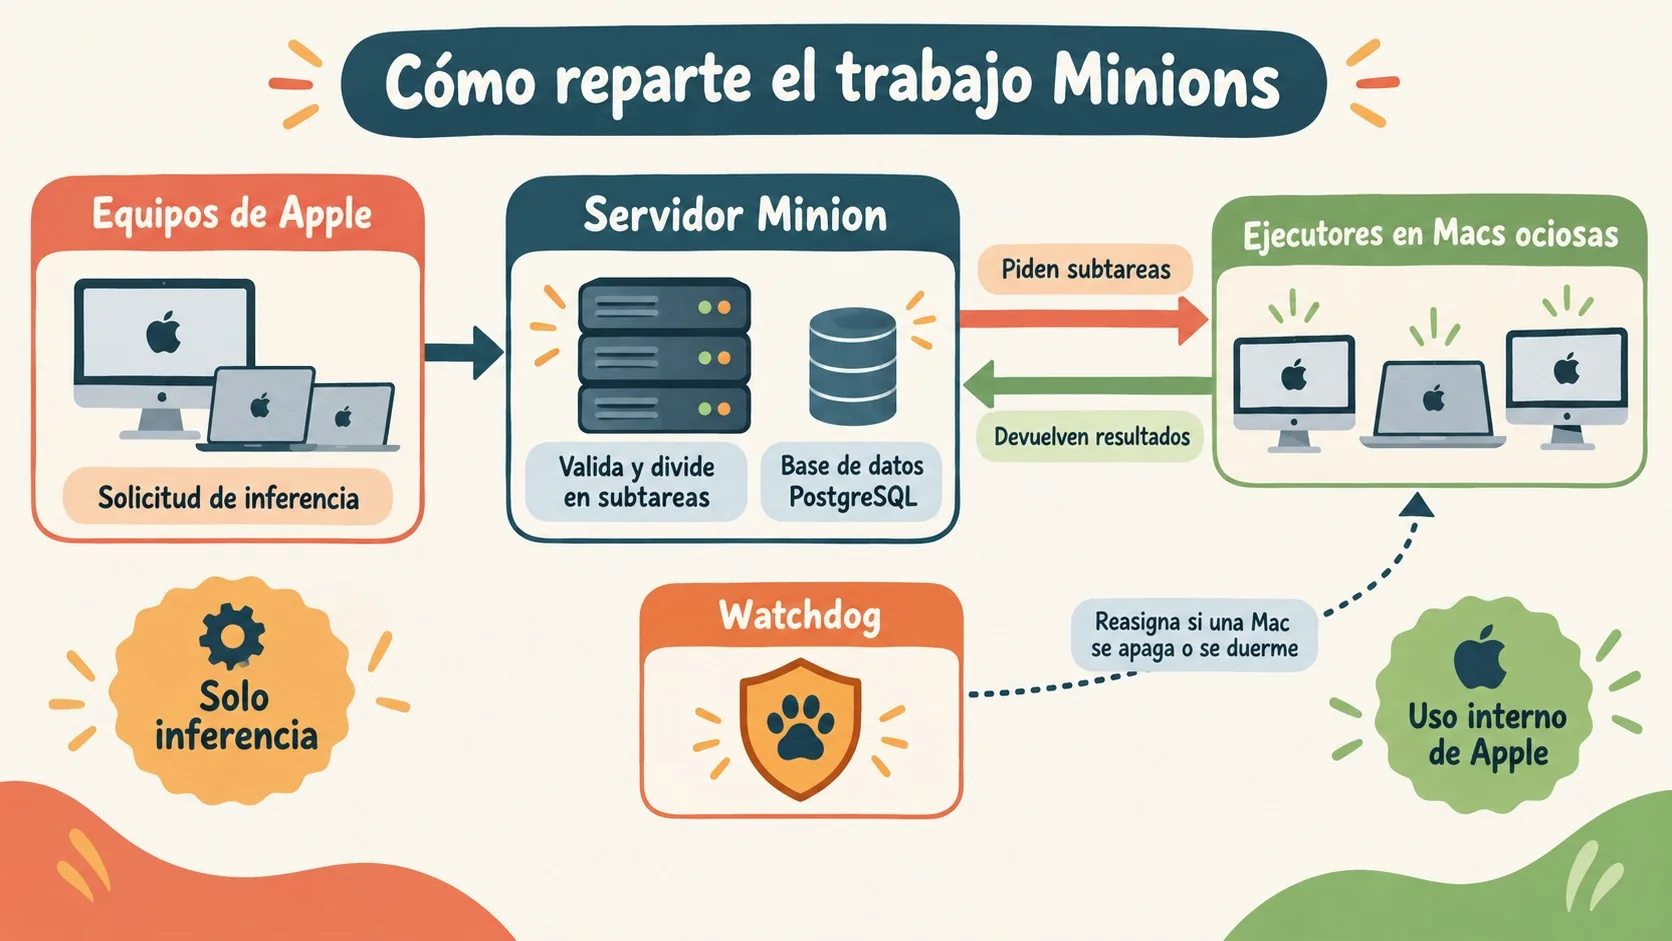
Minions tiene cuatro componentes: un servidor de coordinación, una base PostgreSQL de metadatos, un ejecutor que corre en cada Mac y un watchdog que detecta fallos. Así lo describe The Register, que cubrió el paper el 13 de octubre de 2026.
- Minion Server: recibe los pedidos de los usuarios y los deja disponibles como subtareas.
- PostgreSQL Metadata Store: guarda el estado y los metadatos de cada tarea.
- Minion Executor: corre la inferencia en la GPU de la Mac, sube los resultados a S3 y reporta el estado.
- Minion Watchdog: si una Mac deja de responder, reasigna la tarea.
Los estados de la base alimentan dashboards en Grafana con visibilidad en tiempo real.
¿Qué resultados reporta Apple y cómo hay que leerlos?
El resultado central es de espera. El paper dice que, antes de adoptar Minions, algunos trabajos de inferencia tenían colas de más de diez horas, y que ahora las tareas “a menudo” pueden empezar en minutos (traducción nuestra del texto citado por The Register).
Ojo con cómo se lee eso. Es tiempo hasta el arranque, no velocidad de cómputo. Las fuentes que revisamos no traen benchmarks de throughput ni de latencia, y todo es experiencia interna reportada por Apple, sin medición independiente. Por eso no armamos tablas con números: no los hay.
La distinción importa porque el tiempo hasta el resultado final suma varias cosas: espera en cola, ejecución y eventuales reintentos. Minions ataca sobre todo el primer término.
Ejemplo hipotético (las cifras son inventadas, solo para ilustrar la lógica): un equipo necesita generar embeddings de un corpus grande. En la GPU compartida esperaría 10 horas en cola y luego tardaría 2 horas en ejecutar, es decir 12 horas hasta tener todo. Repartido entre Macs ociosas, supongamos que empieza a los 20 minutos y cada Mac es más lenta, así que el lote entero tarda 4 horas, es decir unas 4 horas y 20 minutos en total. Con esos números la opción distribuida gana, aunque cada GPU sea más lenta. Si la cola fuera de 30 minutos, la cuenta se invertiría. Ese es el punto: la ventaja depende de cuánto esperás hoy, no de que las Macs sean rápidas.
¿Minions de Apple es un producto disponible o un sistema interno?
Hasta donde dicen las fuentes, Minions es una solución interna de Apple. No hay anuncio de producto, precio, fecha de lanzamiento ni acceso público. Según The Register, el objetivo es darle a los empleados de Apple mejor acceso a GPU para inferencia. Tampoco hay evidencia en las fuentes de que use Macs de terceros.
Según The Register (13/10/2026), las Mac mini y Mac Studio permiten clusterizar con RDMA sobre Thunderbolt 5, lo que permitiría, por ejemplo, cargar un modelo demasiado grande para una sola máquina. La fuente no nos permite precisar qué modelos ni de qué año. Ese dato aparece solo en la prensa, no en el resumen del paper, y no lo verificamos. Tomalo con pinzas.
¿Qué límites tiene frente a un clúster de GPU tradicional?
Minions prioriza disponibilidad y aprovechamiento del hardware, no throughput ni latencia máximos. The Register lo contrasta con un clúster Nvidia, que apunta a rendimiento y uso eficiente de la GPU con modelos grandes, y aclara que Minions no busca tanto correr modelos enormes como redistribuir recursos ociosos.
De ahí sale una lectura nuestra, que no es una medición del paper: un esquema así depende de que las Macs estén encendidas y despiertas. El watchdog mitiga el problema reasignando tareas, pero no lo elimina.
Escenario hipotético: subís un lote grande a media mañana y a la tarde la mitad de las Macs entra en reposo. El watchdog reasigna lo que puede, pero el tiempo total pasa a depender más de los horarios de la oficina que de la potencia de cada GPU.
¿Cómo decidir si vale la pena copiar la idea?
Minions no está disponible, así que lo que se puede replicar es el concepto. Lo que sigue es criterio editorial nuestro, apoyado en cómo describen el sistema las fuentes, y no una recomendación del paper.
- Medí la espera actual. Si tus trabajos de inferencia ya arrancan en minutos, no hay mucho que ganar. El caso de Apple parte de colas de horas.
- Medí la utilización fuera de horario. Si tus Macs con Apple Silicon están libres de noche o entre reuniones, hay capacidad para repartir. Si están ocupadas, el beneficio se achica.
- Revisá el tipo de carga. El esquema encaja con inferencia dividible en subtareas independientes. Para un modelo enorme que necesita memoria compartida, las fuentes lo ubican en otra categoría.
- Contá las piezas que tendrías que construir. Los cuatro componentes de Minions (coordinación, metadatos, ejecutor y watchdog) son una buena lista de control: sin algo que reasigne tareas cuando una máquina se cae, una flota de equipos de escritorio es poco confiable.
- Comparalo con alternativas. Si lo que falta es capacidad de servidor y no equipos para reciclar, el planteo cambia y conviene evaluar infraestructura externa, por ejemplo la que ofrece Donweb.
¿Qué está confirmado y qué no sobre Minions?
- Confirmado por el paper y Apple: existencia de Minions, agregación de GPU ociosas de dispositivos macOS con Apple Silicon, inferencia a gran escala, tolerancia a fallos, autores y fecha de envío (9/10/2026).
- Reportado por la prensa: colas de más de diez horas que pasan a minutos, los cuatro componentes y el uso de S3 y Grafana (The Register, 13/10/2026).
- Sin información: disponibilidad pública, precio, cantidad de Macs, benchmarks de throughput y latencia.
Errores comunes al leer esta noticia
- Creer que podés instalarlo: no hay producto ni acceso público. Es un sistema descrito en un paper.
- Leer “diez horas a minutos” como benchmark de velocidad: es tiempo de espera en cola, y es autoinformado.
- Asumir que sirve para entrenar o correr modelos gigantes: el foco es inferencia y disponibilidad, no rendimiento máximo.
- Copiar la idea sin medir: sin datos de uso real de tus equipos, no sabés si hay capacidad ociosa que valga la pena.
Preguntas Frecuentes
¿Qué es Minions de Apple?
Minions es una nube de GPU virtual, dinámica y distribuida, que Apple describe en un paper de arXiv del 9 de octubre de 2026. Junta GPU ociosas de dispositivos macOS con Apple Silicon para ejecutar inferencia de machine learning a gran escala.
¿Cómo aprovecha Apple las GPU ociosas de las Macs?
Un servidor reparte las tareas como subtareas y un ejecutor en cada Mac las corre en su GPU y sube los resultados a S3. Si una Mac deja de responder, el watchdog reasigna la tarea, según The Register.
¿Minions está disponible para el público?
No, las fuentes lo presentan como una solución interna de Apple y no mencionan producto, precio ni fecha de acceso. Tampoco hay evidencia de que use Macs de terceros.
¿Se puede entrenar modelos de IA con Minions?
Las fuentes describen Minions como plataforma de inferencia y no mencionan entrenamiento. Su foco es la disponibilidad del hardware y no el rendimiento máximo con modelos grandes.
¿Qué tipos de tareas de IA ejecuta Minions?
Ejecuta inferencia de machine learning a gran escala. Las fuentes no detallan modelos ni tipos de carga concretos.
Conclusión
Minions de Apple muestra que las colas largas de GPU se pueden atacar con hardware ya comprado, y Apple reporta que bajó esperas de más de diez horas a minutos. Es un resultado interno y autoinformado, sin cifras de throughput ni latencia, así que sirve como idea y no como benchmark.
Si manejás un equipo de ML, medí tu tiempo de cola y la utilización de tus máquinas ociosas antes de copiar el esquema. Si la espera ya es corta, probablemente no lo necesites.