Estado remoto Terraform: guía para equipos
En pocas palabras: A escala empresarial, el estado remoto de Terraform se maneja creando el backend con un proyecto de bootstrap aparte y state local, partiendo el state por entorno y componente, activando locking (use_lockfile en S3, ya que DynamoDB está deprecado) y dejando que solo el CI/CD ejecute apply.
El estado remoto Terraform guarda el archivo terraform.tfstate en un backend compartido (S3, Azure Blob o GCS) con locking, y así varios ingenieros aplican cambios sin pisarse. Según una guía publicada el 14/10/2026 en dev.to, las dos decisiones que más duelen son quién crea ese backend y cómo se parte el state.
El estado remoto de Terraform es el mecanismo que guarda el state (el registro de qué recursos gestiona Terraform y con qué atributos) en un almacenamiento compartido, en vez de en el terraform.tfstate de tu laptop. Sirve para tres cosas: acceso compartido, locking y durabilidad. Lo usan los equipos de infraestructura como código donde más de una persona corre apply. En AWS se implementa con el backend s3.
En este artículo:
- En 30 segundos
- ¿Por qué no alcanza con el state local cuando trabaja un equipo?
- ¿Quién crea el bucket de estado de Terraform? El problema del huevo y la gallina
- ¿Sigue haciendo falta DynamoDB para el locking de Terraform en S3?
- ¿Cómo dividir el state de Terraform por entorno y componente?
- ¿Quién hace plan y quién hace apply con estado remoto en equipo?
- ¿Cómo mover recursos o recuperar un state corrupto sin destruir infraestructura?
- Qué está confirmado y qué falta verificar sobre el estado remoto en Terraform
- Errores comunes al configurar el estado remoto
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
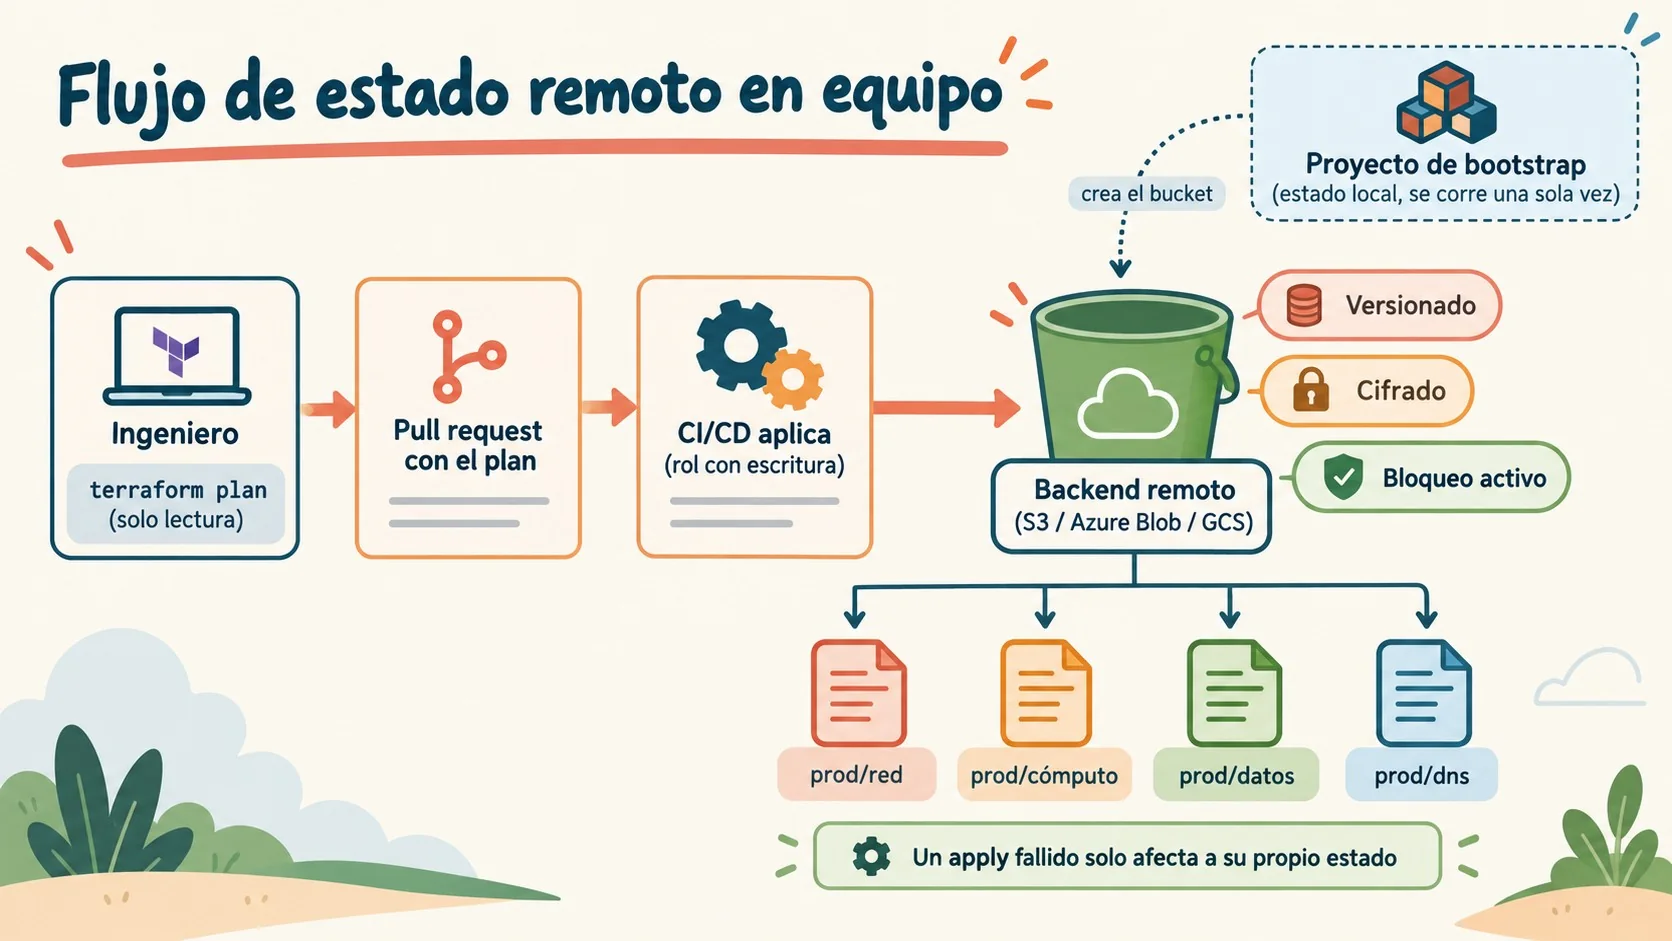
- El bucket del state lo crea un proyecto de bootstrap aparte, con state local, que se corre una vez por cuenta.
- La documentación oficial del backend S3 marca el locking con DynamoDB como deprecado y propone
use_lockfile(por defecto esfalse). La guía de dev.to todavía usa la tabla. - Un state por entorno y por componente (
prod/network,prod/compute) limita el daño de un apply fallido. - Plan en local con permisos de lectura, apply solo desde CI/CD, y
force-unlocksolo después de consultar al equipo.
¿Por qué no alcanza con el state local cuando trabaja un equipo?
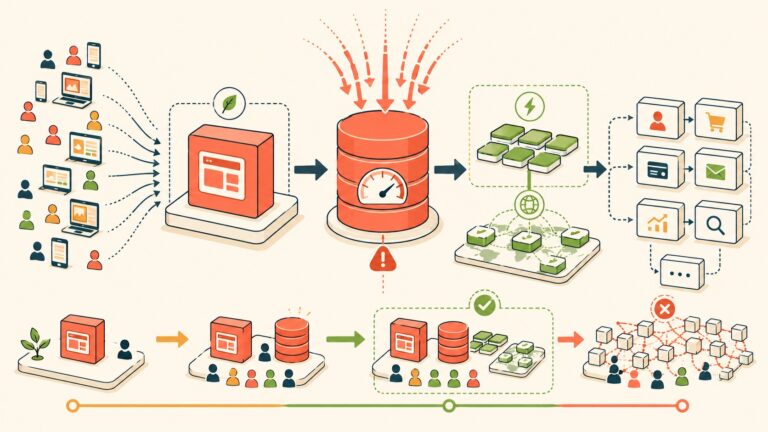
Porque el terraform.tfstate local no se comparte, no se bloquea y se pierde si se rompe la máquina. Si dos personas aplican a la vez, gana la última escritura: los cambios de la otra persona desaparecen del state aunque sigan existiendo en la nube. Esa brecha entre state y realidad se llama drift, y la guía la define como dolorosa de arreglar.
¿Quién crea el bucket de estado de Terraform? El problema del huevo y la gallina
Lo crea un proyecto de Terraform aparte, de bootstrap, con state local. Se corre una vez por cuenta y se commitea a git. Es la respuesta estándar que describe la guía, que compara tres caminos:
- ClickOps: alguien crea el bucket a mano. Funciona una vez, y después nadie recuerda la configuración.
- Proyecto de bootstrap con state local: un Terraform mínimo cuyo único trabajo es crear el backend. Es el camino correcto para equipos.
- Terraform administrando su propio backend: la guía lo desaconseja, porque el
initqueda circular y frágil.
Subís el bucket desde la consola, te olvidás de activar el versionado, seis meses después alguien necesita volver a un state anterior, descubrís que el historial llega solo a dos semanas y terminás reconstruyendo recursos con terraform import uno por uno, que es tan divertido como suena.
El bootstrap del ejemplo en AWS crea un bucket myorg-terraform-state-prod con versionado, cifrado aws:kms y bloqueo de acceso público, más una tabla DynamoDB terraform-state-locks con LockID como clave. El versionado no es un detalle: la documentación oficial del backend S3 lo recomienda con una advertencia para recuperar el state ante borrados accidentales y errores humanos.
¿Y si el proyecto administra su propio backend? Mala idea, por lo del init. Lo explicamos a fondo en configurar estado remoto en una VM Linux de Azure.
¿Sigue haciendo falta DynamoDB para el locking de Terraform en S3?
La documentación oficial dice que no hace falta en setups nuevos: el locking con DynamoDB está deprecado y se va a eliminar en una futura versión menor. El locking nativo de S3 se activa con use_lockfile = true y por defecto está en false. Para migrar desde versiones viejas, la doc permite configurar ambos mecanismos a la vez.
Acá hay una diferencia entre las fuentes. La guía de dev.to arma el bootstrap con tabla DynamoDB (PAY_PER_REQUEST, hash_key LockID), y la doc de HashiCorp la marca como camino en retirada. Mi lectura: copiar el ejemplo tal cual te deja una tabla que vas a tener que sacar después. La doc oficial que consulté no menciona desde qué versión de Terraform está disponible use_lockfile. Tomalo como dato a verificar con terraform version.
Ojo con los permisos: con use_lockfile, Terraform necesita s3:GetObject, s3:PutObject y s3:DeleteObject sobre el objeto .tflock (por ejemplo path/to/my/key.tflock). Sobre el state en sí no hace falta s3:DeleteObject.
terraform {
 backend "s3" {
 bucket = "myorg-terraform-state-prod"
 key = "network/terraform.tfstate"
 region = "us-east-1"
 encrypt = true
 use_lockfile = true
 }
}
Es una adaptación mía del ejemplo de la guía, con el argumento de la doc oficial. Los otros backends no tienen este dilema: Azure Blob y GCS tienen locking nativo y no necesitan una tabla aparte, como muestra la tabla de abajo. Tema relacionado: crear una máquina virtual en Azure.
| Backend | Parámetros clave del ejemplo | Locking | Tabla aparte |
|---|---|---|---|
| S3 | bucket, key, region | Opt-in con use_lockfile; DynamoDB deprecado | No con use_lockfile |
| Azure Blob | resource_group_name, storage_account_name, container_name, key | Nativo, con blob leases | No |
| GCS | bucket, prefix | Nativo | No |
Terraform Cloud no aparece en las fuentes que tengo, así que no lo comparo.
Propuesta editorial, no pasos de la fuente: antes de borrar la tabla, probalo en un state de prueba. Corré dos apply a la vez con use_lockfile = true, confirmá que el segundo falla con error de lock y que durante la corrida aparece un objeto .tflock en el bucket.
¿Cómo dividir el state de Terraform por entorno y componente?
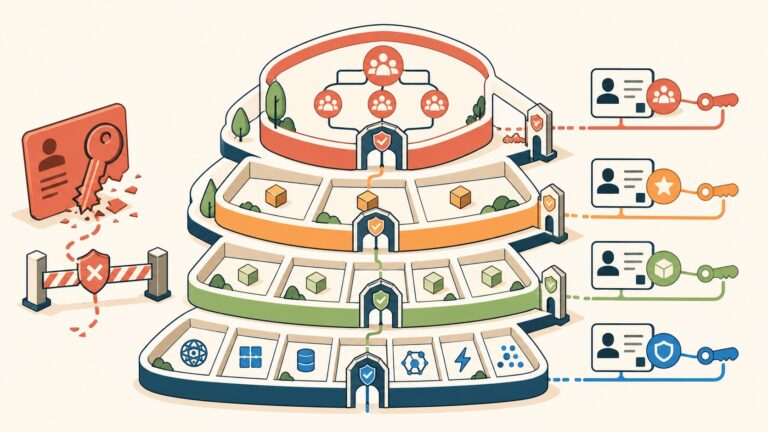
Con un archivo de state por entorno y por componente, de modo que un apply fallido o un state corrupto solo afecte lo que vive en ese archivo. El layout de la guía es prod/network, prod/compute, prod/data, prod/dns, y del lado de staging staging/network y staging/compute, cada uno con su terraform.tfstate.
- Radio de daño: si se corrompe el state de red, compute y data quedan intactos.
- Velocidad: según el autor, un plan sobre 5.000 recursos es lento y sobre 200 es rápido. Son cifras ilustrativas, no un benchmark.
- Control de acceso: el equipo de datos no necesita escritura sobre el state de red, y los archivos chicos mapean limpio a límites de IAM.
El costo son las referencias cruzadas. Cuando compute necesita el ID de la VPC, usás el data source terraform_remote_state. Según la doc oficial, ese data source devuelve las outputs del módulo raíz, pero no las de módulos anidados salvo que las vuelvas a exportar en el raíz. Es el tipo de detalle que te hace perder una tarde.
¿Quién hace plan y quién hace apply con estado remoto en equipo?
Los ingenieros corren plan en local con acceso de lectura, y solo el CI/CD corre apply, con un rol IAM dedicado con escritura, después de que el plan se aprobó en el pull request. Los applies se serializan por state. El autor lo resume en una línea: “Local plan, reviewed apply, locked state”. Relacionado: reglas de ciclo de vida en Terraform.
El state guarda cada atributo de cada recurso, contraseñas y claves incluidas, en texto plano. Por eso conviene tratar el bucket como un almacén de secretos:
- Cifrado en reposo:
encrypt = trueo la configuración KMS del bootstrap. - IAM acotado: lectura para ingenieros, escritura para el CI/CD y admins break-glass. Según la doc oficial, los permisos mínimos sobre el state son
s3:ListBucket,s3:GetObjectys3:PutObject. - Nada de state en git:
*.tfstatey*.tfstate.backupal.gitignoredesde el día uno. - Backend parcial:
terraform { backend "s3" {} }y los valores por-backend-config, desde variables del pipeline.
Eso sí, hay un matiz de la doc de HashiCorp: lo que pasás por -backend-config o hardcodeás queda en el subdirectorio .terraform y en los plan files. Para credenciales recomienda variables de entorno. Nombres de bucket y regiones no son secretos, pero una access key sí.
¿Cómo mover recursos o recuperar un state corrupto sin destruir infraestructura?
Con los comandos terraform state, que operan sobre el state sin tocar la infraestructura real, y corriendo plan enseguida después de cada uno. Si el plan muestra creates o destroys, la dirección estaba mal y hay que corregirla antes de que alguien aplique.
terraform state mv 'aws_instance.web' 'module.compute.aws_instance.web'
terraform plan- state mv: mueve un recurso entre módulos o direcciones. La instancia EC2 sigue corriendo.
- state rm: Terraform deja de gestionar el recurso, que sigue existiendo. Para pasarlo a otro equipo,
rmen un state eimporten el otro. - state pull y push: es la salida de emergencia para un state corrupto. Editar el JSON a mano sin entender el esquema es la forma más rápida de empeorarlo, así que guardá un backup del pull original.
Para pasar de local a remoto, la guía propone cuatro pasos:
- Agregá el bloque
backenda la configuración. - Corré
terraform inity respondé que sí a copiar el state existente. - Verificá con
terraform planque no muestre cambios. - Borrá el
terraform.tfstatelocal y su backup, y commiteá la config.
Sobre el lock trabado después de un apply caído, terraform force-unlock <lock-id> lo libera. Antes preguntale al equipo: si alguien está en medio de un apply, destrabar recrea la condición de carrera que el locking evitaba. Y -lock=false queda para emergencias, avisando antes. En desplegar tu primer servidor en AWS profundizamos sobre esto.
Qué está confirmado y qué falta verificar sobre el estado remoto en Terraform
- Confirmado por la doc oficial: el locking con DynamoDB está deprecado,
use_lockfileexiste y por defecto esfalse, y el lock usa un objeto.tflock. - Confirmado por la guía de dev.to: el layout por entorno y componente, el flujo plan local y apply en CI/CD, y el checklist previo.
- Sin verificar: desde qué versión de Terraform funciona
use_lockfile(la doc consultada no lo dice) y cuándo se elimina DynamoDB. - Ilustrativo: los 5.000 y 200 recursos de la guía son un ejemplo del autor, no una medición.
Errores comunes al configurar el estado remoto
- Crear el bucket a mano: la “solución” rápida deja sin versionado, cifrado ni lifecycle. Pasalo a un proyecto de bootstrap versionado en git.
- Copiar el ejemplo con DynamoDB sin mirar la doc: arrancás con un mecanismo deprecado. Chequeá tu versión de Terraform y probá
use_lockfileen un state de prueba. - Un único state gigante: los planes de diez minutos hacen que la gente deje de correrlos y aplique a ciegas. Dividí por entorno y componente.
- Pasar credenciales por
-backend-config: terminan en.terraformy en los plan files. Usá variables de entorno.
Preguntas Frecuentes
¿Qué es el estado remoto de Terraform?
Es el state de Terraform guardado en un backend compartido (S3, Azure Blob o GCS) en lugar de en un archivo local. Resuelve el acceso compartido, el locking y la durabilidad, tres cosas que el terraform.tfstate de una laptop no puede dar.
¿Cómo creo el bucket de S3 del state si Terraform lo necesita para funcionar?
Creálo con un proyecto de Terraform aparte, de bootstrap, cuyo state queda local. Lo corrés una vez por cuenta, lo commiteás a git y después todos los demás proyectos apuntan al backend que creó. No hagas que un proyecto cree el bucket de su propio state.
¿Sigue haciendo falta una tabla DynamoDB para el locking de Terraform?
Según la documentación oficial del backend S3, no: el locking con DynamoDB está deprecado y se activa el nativo con use_lockfile = true. La versión mínima de Terraform no figura en esa doc, así que verificala con terraform version.
¿Cuándo es seguro usar terraform force-unlock?
Cuando confirmaste con el equipo que nadie está en medio de un apply y el lock quedó trabado por una corrida caída. Si lo usás con un apply en curso, recreás la carrera que el locking evita.
¿Cómo separo el state por entorno para que un apply fallido no rompa todo?
Usá un archivo de state por entorno y por componente, como prod/network/terraform.tfstate y prod/compute/terraform.tfstate. Un apply solo puede destruir lo que está en su propio state, y además ganás planes más rápidos y permisos IAM más finos.
Conclusión
La guía del 14/10/2026 ordena bien la disciplina: bootstrap aparte, state partido por radio de daño, plan local y apply desde CI/CD. Lo que cambia respecto de sus ejemplos es el locking en S3, donde la doc oficial ya marca DynamoDB como deprecado. Si arrancás hoy, probá use_lockfile en un state de prueba y verificá tu versión de Terraform antes de armar la tabla.
El criterio sirve para cualquier infraestructura que declares como código, sea cloud público o servidores y hosting en un proveedor local como donweb.com, siempre que exista un provider de Terraform para lo que gestionás. El autor admite que nadie muestra un bloque de backend en una conferencia (“Nobody demos a backend block at a conference”). Aun así, ahí empiezan casi todas las historias de terror, así que tildá el checklist antes de dar el setup por terminado.