PGConf.Asia 2026: qué presenta EDB en Hong Kong
En pocas palabras: PGConf.Asia 2026 se realiza el 17 y 18 de noviembre de 2026 en Hong Kong, en inglés. EDB presenta nueve sesiones, con la keynote de Bruce Momjian sobre qué le falta a PostgreSQL, charlas de RAG con pgvector, tuning y demos de CloudNativePG y TPA.
PGConf.Asia 2026 se hace el 17 y 18 de noviembre de 2026 en Hong Kong, en inglés. EDB detalló nueve sesiones, con la keynote de Bruce Momjian sobre lo que le falta a PostgreSQL, charlas de RAG con pgvector, tuning y demos de Kubernetes.
PGConf.Asia es la conferencia regional de la comunidad PostgreSQL en Asia, y reúne a desarrolladores, contribuidores, DBAs y usuarios empresariales. La edición 2026 se hace en Hong Kong, en inglés, con un comité organizador y un comité de programa. Bruce Momjian, de EDB, integra el primero y co-preside el segundo. PostgreSQL es el motor de bases de datos relacional open source sobre el que giran las charlas de EDB.
En este artículo:
- En 30 segundos
- ¿Qué le falta a PostgreSQL según la keynote de Bruce Momjian?
- ¿Qué charlas de PostgreSQL con IA, RAG y pgvector presenta EDB?
- ¿Qué sesiones de arquitectura y rendimiento de PostgreSQL hay en PGConf.Asia 2026?
- ¿Qué es CloudNativePG y qué es Trusted Postgres Architect?
- ¿Cuándo es PGConf.Asia 2026 y qué te sirve si no viajás a Hong Kong?
- ¿Qué está confirmado y qué no sobre las sesiones de EDB?
- Errores comunes al leer los abstracts de PGConf.Asia 2026
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Fecha y sede: 17 y 18 de noviembre de 2026, Hong Kong, idioma inglés, según la página del evento en postgresql.org.
- Keynote: Bruce Momjian repasa hints del optimizador, sharding nativo, TDE, índices globales y multi-master, y explica por qué faltan.
- IA: Bruce prueba si los modelos escriben SQL válido con MCP, y Ajit Gadge arma un pipeline de RAG con pgvector, con demo en vivo.
- Operación: CloudNativePG 101 y Trusted Postgres Architect (TPA) incluyen demo en vivo. Todo lo publicado hasta ahora son abstracts, no resultados.
¿Qué le falta a PostgreSQL según la keynote de Bruce Momjian?
Según el adelanto de EDB, la keynote “What’s Missing in Postgres?” cubre cinco ausencias: hints del optimizador, sharding nativo, Transparent Data Encryption (TDE), índices globales y replicación multi-master. La charla explica por qué no existen y qué haría falta para tenerlas. No anuncia que ninguna vaya a llegar.
El abstract agrega que Postgres suma unas 200 funcionalidades y mejoras por año, con un paréntesis que lo dice todo: “well, maybe not this year”. Esa ironía es de la fuente, no mía.
Mi lectura, y es opinión: la lista sirve más como mapa para decidir arquitectura que como promesa. Si hoy necesitás sharding o cifrado transparente, lo resolvés con extensiones o productos de terceros, y la keynote probablemente explique por qué el núcleo no lo hace.
¿Qué charlas de PostgreSQL con IA, RAG y pgvector presenta EDB?
EDB presenta dos charlas de IA. Bruce Momjian evalúa si los modelos actuales generan SELECT y DML válidos a partir de instrucciones en inglés, usando Model Context Protocol (MCP) y una base de ejemplo. Ajit Gadge arma un pipeline de RAG sobre PostgreSQL con pgvector, con demo en vivo. Tema relacionado: cómo funcionan los DNS autoritativos y evitar caídas.
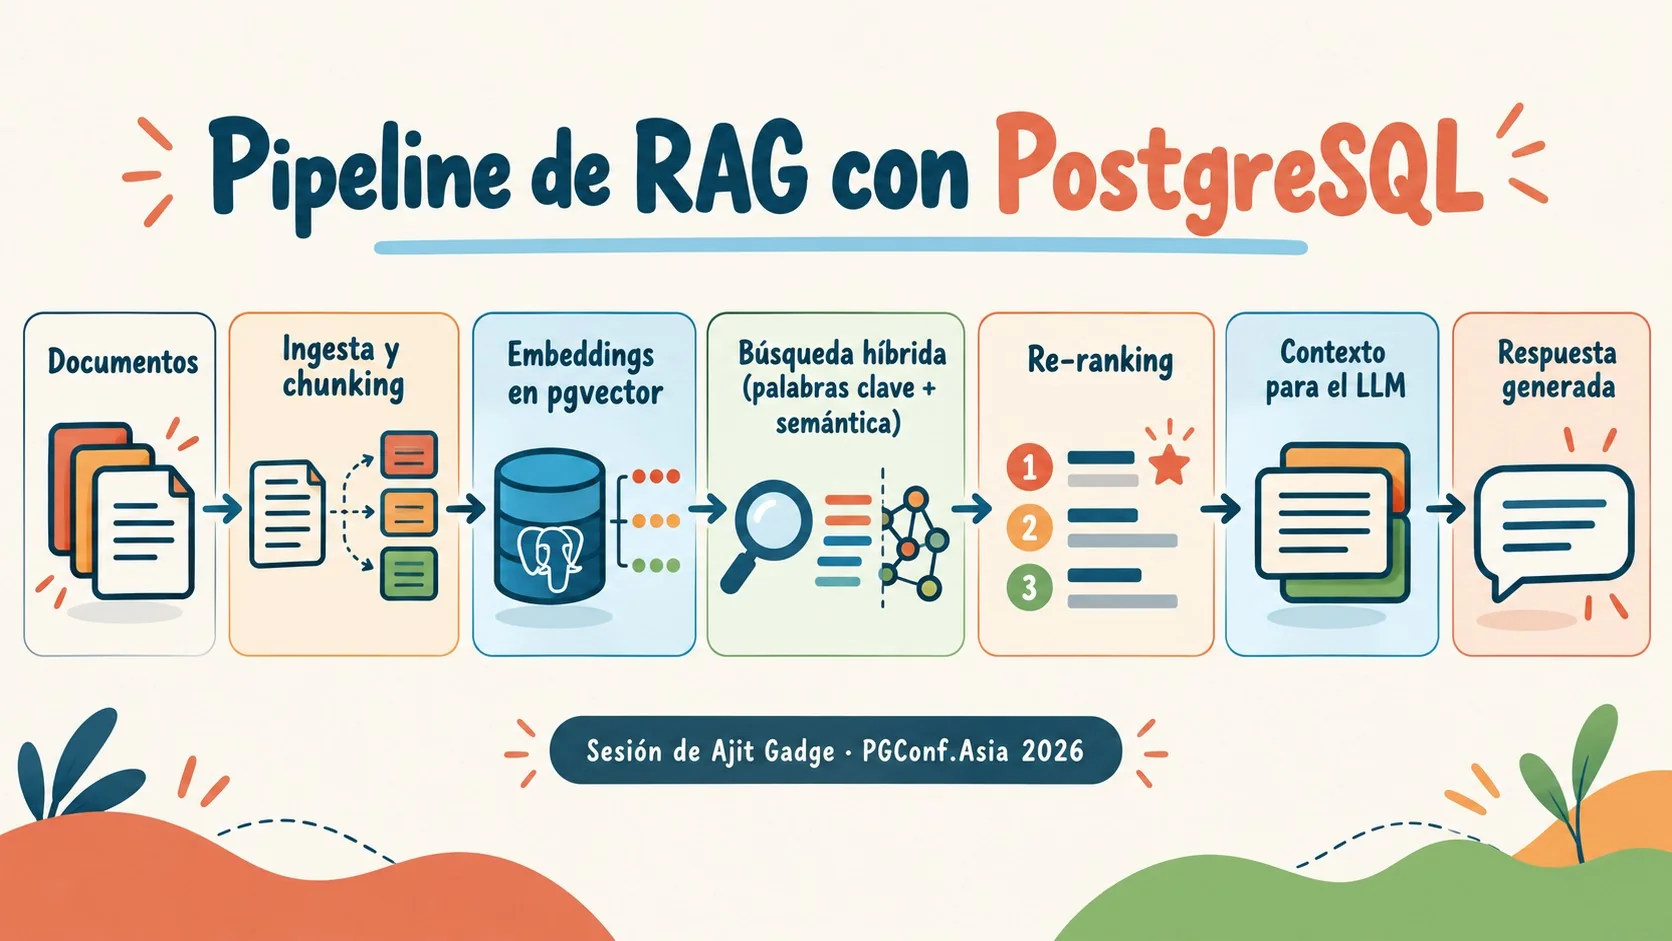
El abstract de Ajit arranca así: “Effective AI search requires more than vector storage: it demands a complete retrieval pipeline”. Traducido, guardar vectores es el primer paso y no el sistema entero. El recorrido que promete la sesión:
- Ingesta y chunking: preparás los documentos antes de vectorizarlos.
- Embeddings en pgvector: se generan y se guardan dentro de PostgreSQL.
- Búsqueda híbrida: combina keyword y semántica.
- Re-ranking y contexto al LLM: se reordenan los resultados antes de armar el prompt.
Ponele que le pedís a la “inteligencia” artificial una consulta sobre tus ventas, te devuelve algo que parece perfecto, la corrés contra producción porque total es un SELECT, resulta que mete un join sin condición, el servidor se pone a transpirar y nadie sabe bien de quién fue la culpa. Escenario hipotético, claro. Pero es el tipo de límite operativo que Bruce dice querer medir.
¿Hay resultados? Todavía no. Los dos abstracts salieron el 13 de octubre de 2026 y las charlas no se dieron.
Propuesta editorial para evaluar cualquier resultado que se publique: corré el SQL generado en una copia de la base con un rol de solo lectura, mirá el EXPLAIN antes de ejecutar DML y compará la salida contra una consulta que escribiste vos. Relacionado: comparativa de herramientas de CI/CD en 2026.
¿Qué sesiones de arquitectura y rendimiento de PostgreSQL hay en PGConf.Asia 2026?
EDB tiene cuatro sesiones en este bloque: scale-out de Koichi Suzuki, expression nodes de Jian He, modelado de datos de Charly Batista y un caso de benchmark TPC-C de Vishal Sawale. Las dos primeras apuntan a quienes diseñan o contribuyen al motor. Las otras dos son para quienes operan PostgreSQL y pagan la factura de infraestructura.
| Sesión | Orador | Tema según el abstract |
|---|---|---|
| Scale out PostgreSQL solution, past and future | Koichi Suzuki | Greenplum, Postgres-XC/XL, Citus, YugabyteDB y CockroachDB; FDW, hooks de transacciones distribuidas y detección de deadlocks |
| A Brief Explanation of the PostgreSQL Expression Node, and Other | Jian He | Cómo un nodo de expresión pasa por el parse analysis; tips para hackear el core |
| Reducing Costs and Improving Performance With Data Modeling in Postgres | Charly Batista | Free Space Map y disposición de datos en bloques para bajar uso de disco, memoria y costo cloud |
| A Benchmarking Case Study of PostgreSQL Locks, Partitions, and Peak Load | Vishal Sawale | Contención del lock de extensión de relaciones en TPC-C sobre PostgreSQL estándar, resuelta con particionado |
La de Vishal Sawale es la más accionable si tu carga escribe mucho. Según el abstract, esa contención frena el rendimiento justo en el pico de tráfico. El abstract de Charly no da cifras de ahorro, así que el “baja costos” queda como promesa hasta ver la charla.
Propuesta editorial (no es de la charla): antes de particionar nada, mirá en pg_stat_activity si tus sesiones esperan con wait_event_type Lock y wait_event extend durante el pico. Si no aparece, el caso no es el tuyo.
¿Qué es CloudNativePG y qué es Trusted Postgres Architect?
CloudNativePG es un operador de Kubernetes para gestionar clusters PostgreSQL de alta disponibilidad, y es un proyecto de la CNCF en nivel Sandbox. Trusted Postgres Architect (TPA) es una herramienta open source de orquestación basada en Ansible que provisiona arquitecturas PostgreSQL desde archivos de configuración declarativos. Cubrimos ese tema en detalle en qué conviene elegir entre Jenkins y GitHub Actions.
Según la ficha de la CNCF, que toma datos de LFX Insights, CloudNativePG entró el 21 de enero de 2025, tiene 4.551 contribuidores de 1.560 organizaciones, 3.173 estrellas en GitHub y un Health Score de 84 (“Healthy”). Sandbox es el primer escalón de madurez de la CNCF. Que los contribuidores superen a las estrellas me llama la atención (probablemente LFX cuente distinto), así que tomalo con pinzas.
- CloudNativePG 101: Gabriele Quaresima y Tao LI cubren CRDs, imágenes de operando, monitoreo con Prometheus, gestión declarativa de bases y upgrades mayores, con demo en vivo.
- TPA: Nawaz Ahmed muestra “architecture-as-code” con Patroni (alta disponibilidad), PgBouncer (pooling) y Barman (recuperación ante desastres) contra el configuration drift, también con demo.
Mi lectura: si tu infraestructura vive en Kubernetes, mirás CloudNativePG, y si vive en servidores o máquinas virtuales, TPA. Es inferencia, no recomendación de las fuentes. Los abstracts no traen detalles de configuración, así que usá la documentación oficial de la versión que vayas a instalar.
¿Cuándo es PGConf.Asia 2026 y qué te sirve si no viajás a Hong Kong?
PGConf.Asia 2026 es el 17 y 18 de noviembre de 2026 en Hong Kong, en inglés, según la página del evento en postgresql.org. Las fuentes no confirman transmisión ni grabaciones, así que para saber si podés seguirlo desde Argentina hay que mirar el sitio oficial.
Hong Kong va 11 horas adelante de Argentina: una charla a las 9:00 allá son las 22:00 del día anterior acá. La misma página lista entradas Early Bird a HKD 120, tickets estándar, extras de workshop y entradas gratis para estudiantes verificados y contribuidores activos. Eso sí: todavía muestra el texto de la convocatoria de charlas, que cerraba el 31 de agosto de 2026, así que confirmá el precio vigente.
Para equipos que operan Postgres, los temas (alta disponibilidad, RAG, Kubernetes, tuning) funcionan de mapa de tendencias. Si querés replicar una demo de CloudNativePG o Patroni, necesitás servidores o cloud para el laboratorio; en Argentina podés mirar donweb.com.
¿Qué está confirmado y qué no sobre las sesiones de EDB?
- Confirmado: fechas, sede e idioma del evento; los nueve títulos con sus oradores; el rol de Bruce Momjian en los comités; la demo en vivo en las sesiones de RAG, CloudNativePG y TPA.
- Sin confirmar: horarios de cada charla, transmisión o grabaciones, resultados de las pruebas de IA y de los benchmarks, y cualquier fecha de llegada de las funcionalidades que menciona la keynote.
Errores comunes al leer los abstracts de PGConf.Asia 2026
- Leer la keynote como roadmap. Explica por qué faltan hints, sharding o TDE, no cuándo llegan. Corrección: no planifiques una migración esperando esas funciones.
- Tratar un abstract como resultado. “Can AI Write SQL?” es una pregunta, no una conclusión. Corrección: esperá a ver el método y los casos.
- Copiar el particionado del caso TPC-C. Es un benchmark con PostgreSQL estándar, no tu carga. Corrección: verificá primero que tenés la misma contención.
- Confundir CloudNativePG con TPA. El primero es un operador de Kubernetes; el segundo es orquestación con Ansible. Corrección: elegí según dónde corre tu infraestructura.
Preguntas Frecuentes
¿Cuándo es PGConf.Asia 2026?
PGConf.Asia 2026 es el 17 y 18 de noviembre de 2026. Se hace en Hong Kong y el idioma es inglés.
¿Qué sesiones va a dar EDB en PGConf.Asia 2026?
EDB lidera nueve sesiones: la keynote y “Can AI Write SQL?” de Bruce Momjian, RAG con pgvector de Ajit Gadge, scale-out de Koichi Suzuki, expression nodes de Jian He, modelado de datos de Charly Batista, locks y particionado de Vishal Sawale, CloudNativePG 101 y TPA. Sobre eso hablamos en ejecutar agentes locales sin depender de una API.
¿Qué funcionalidades le faltan a PostgreSQL?
Según la keynote de Bruce Momjian, faltan hints del optimizador, sharding nativo, TDE, índices globales y replicación multi-master. La charla explica por qué no están, sin prometer que lleguen.
¿Se puede usar PostgreSQL para RAG con pgvector?
Sí, es el recorrido que muestra Ajit Gadge: ingesta, chunking, embeddings en pgvector, búsqueda híbrida, re-ranking y contexto al LLM. El abstract no da métricas, así que la calidad real se mide en tu caso.
¿Qué es CloudNativePG y para qué sirve?
CloudNativePG es un operador de Kubernetes que gestiona clusters PostgreSQL de alta disponibilidad. Es un proyecto de la CNCF en nivel Sandbox desde el 21 de enero de 2025.
Conclusión
PGConf.Asia 2026 trae una agenda de EDB con foco práctico: lo que falta en el motor, IA sobre Postgres, locks, costos y operación en Kubernetes. Todavía no hay resultados, solo abstracts del 13 de octubre de 2026. Lo que te conviene hacer: entrá al sitio oficial, elegí las dos o tres charlas que coinciden con un problema que tenés hoy (contención, flota de clusters, RAG) y tratá cada abstract como una hipótesis para probar en tu entorno.