COPY binario en .NET 9: de 2.910 a 15.710 ítems por segundo
En pocas palabras: Pasar de EF Core a COPY binario de Npgsql acelera la importación masiva en .NET 9 y PostgreSQL 17: según el caso de TeamChords v2, 1.000 chord sheets bajaron de 343,6 ms a 63,7 ms y el throughput subió de 2.910 a 15.710 ítems por segundo.
Según el caso de estudio publicado en dev.to el 15 de octubre de 2026, TeamChords v2 pasó su importación masiva PostgreSQL de EF Core a COPY binario: 1.000 chord sheets bajaron de 343,6 ms a 63,7 ms y el throughput subió de 2.910 a 15.710 ítems por segundo.
COPY es el comando de PostgreSQL para mover datos entre una tabla y archivos o la aplicación cliente, y según la documentación de Npgsql suele ser mucho más rápido que INSERT y SELECT. Con FROM STDIN, las filas viajan por la conexión entre cliente y servidor. Npgsql, el proveedor de PostgreSQL para .NET, lo expone en tres modos (binario, texto y binario crudo) y el binario se abre con BeginBinaryImport.
En este artículo:
- En 30 segundos
- ¿Por qué EF Core se estanca en unos 2.900 ítems por segundo al importar?
- ¿Cómo funciona el COPY binario de PostgreSQL con Npgsql y FastIngest?
- ¿Qué resultados dio el cambio en TeamChords v2?
- ¿Qué límites tiene este benchmark y qué está confirmado?
- ¿Cuándo conviene pasar de EF Core a COPY binario?
- Errores comunes al hacer importación masiva con COPY binario
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El caso reporta 1.000 chord sheets en 63,7 ms contra 343,6 ms antes, unas 5,4 veces menos latencia.
- El autor dice que EF Core con AddRange se clavó en unos 2.900 ítems/seg con lotes de 50, 100 o 250.
- Npgsql exige llamar a Complete() para confirmar el COPY y recomienda pasar NpgsqlDbType en cada Write.
- Las cifras son autoinformadas, de un solo proyecto, sin hardware ni método estadístico en el texto.
- La documentación de PostgreSQL 17 dice que COPY FROM no funciona con tablas que tengan row-level security.
¿Por qué EF Core se estanca en unos 2.900 ítems por segundo al importar?
Según el autor del caso, el techo viene del ChangeTracker y de la generación de SQL. Aun con ChangeTracker.Clear(), EF Core arma estado snapshot, evalúa relaciones y compila parámetros por cada entidad, y PostgreSQL tiene que parsear y planificar cada INSERT multifila. El throughput quedó en unos 2.900 ítems/seg con lotes de 50, 100 o 250.
¿Y el tamaño de lote? No movió el techo. Eso sugiere (lectura nuestra) que el costo está en cada fila y no en los viajes de red.
Antes de eso el equipo mandaba un POST por canción desde el cliente, la “solución” más simple de escribir. Con 500 canciones y 40 ms de ida y vuelta, solo la red suma 20 segundos, y la fuente habla de más de 25 con el procesamiento del servidor. Ojo: el reparto del tiempo entre tracking y parseo es un diagnóstico del autor, no algo que hayamos medido nosotros.
¿Cómo funciona el COPY binario de PostgreSQL con Npgsql y FastIngest?
COPY … FROM STDIN manda las filas al servidor por la conexión del cliente, sin archivos en la máquina de la base, según la documentación de PostgreSQL 17. En formato binario, Npgsql codifica cada campo y vos llamás a StartRow, Write por columna y Complete al final. El caso suma FastIngest, una librería de terceros, para armar el pipeline alrededor.
El flujo que describe el autor:
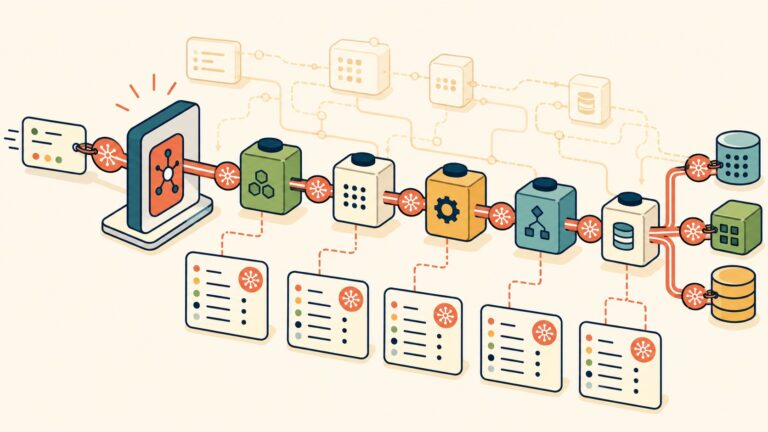
- El endpoint lee el stream. Acepta NDJSON, CSV o multipart sin armar arrays completos en memoria.
- Un Channel acotado aplica backpressure. Lotes de 1.000 filas y capacidad 2.
- La validación corre antes de escribir. Usa ErrorStrategy.CollectAndContinue, así una fila mala no frena la carga.
- El sink abre un import binario por lote. Usa BeginBinaryImportAsync con COPY … FROM STDIN (FORMAT BINARY).
Así se ve el patrón base en el ejemplo de la documentación de Npgsql:
using (var writer = conn.BeginBinaryImport("COPY data (field_text, field_int2) FROM STDIN (FORMAT BINARY)"))
{
 writer.StartRow();
 writer.Write("Hello");
 writer.Write(8, NpgsqlDbType.Smallint);
 writer.StartRow();
 writer.Write("Goodbye");
 writer.WriteNull();
 writer.Complete();
}
Dos advertencias de Npgsql que no conviene ignorar. Si no llamás a Complete(), el COPY se revierte cuando el writer se descarta. Y si escribís un tipo equivocado (un int32 en una columna de texto, por ejemplo), podés obtener una excepción o, peor, corrupción silenciosa de datos.
El fragmento de sink que publica la fuente se corta antes del final, así que no podemos confirmar dónde llama a Complete(). Y como abre un writer en cada WriteBatchAsync, cada lote de 1.000 parece ser un COPY propio. Si es así, una falla a mitad de camino podría dejar lotes anteriores ya confirmados, salvo que haya una transacción externa (inferencia nuestra, el texto no lo aclara). De FastIngest, las fuentes oficiales no dicen nada: lo verificado en documentación oficial es Npgsql y COPY.
¿Qué resultados dio el cambio en TeamChords v2?
El autor reporta que 1.000 chord sheets pasaron de 343,6 ms a 63,7 ms y que el throughput subió de 2.910 a 15.710 ítems por segundo, unas 5,4 veces más. Las asignaciones del hilo bajaron a un rango de 0 a 106 KB. Son cifras del propio proyecto, publicadas en dev.to.
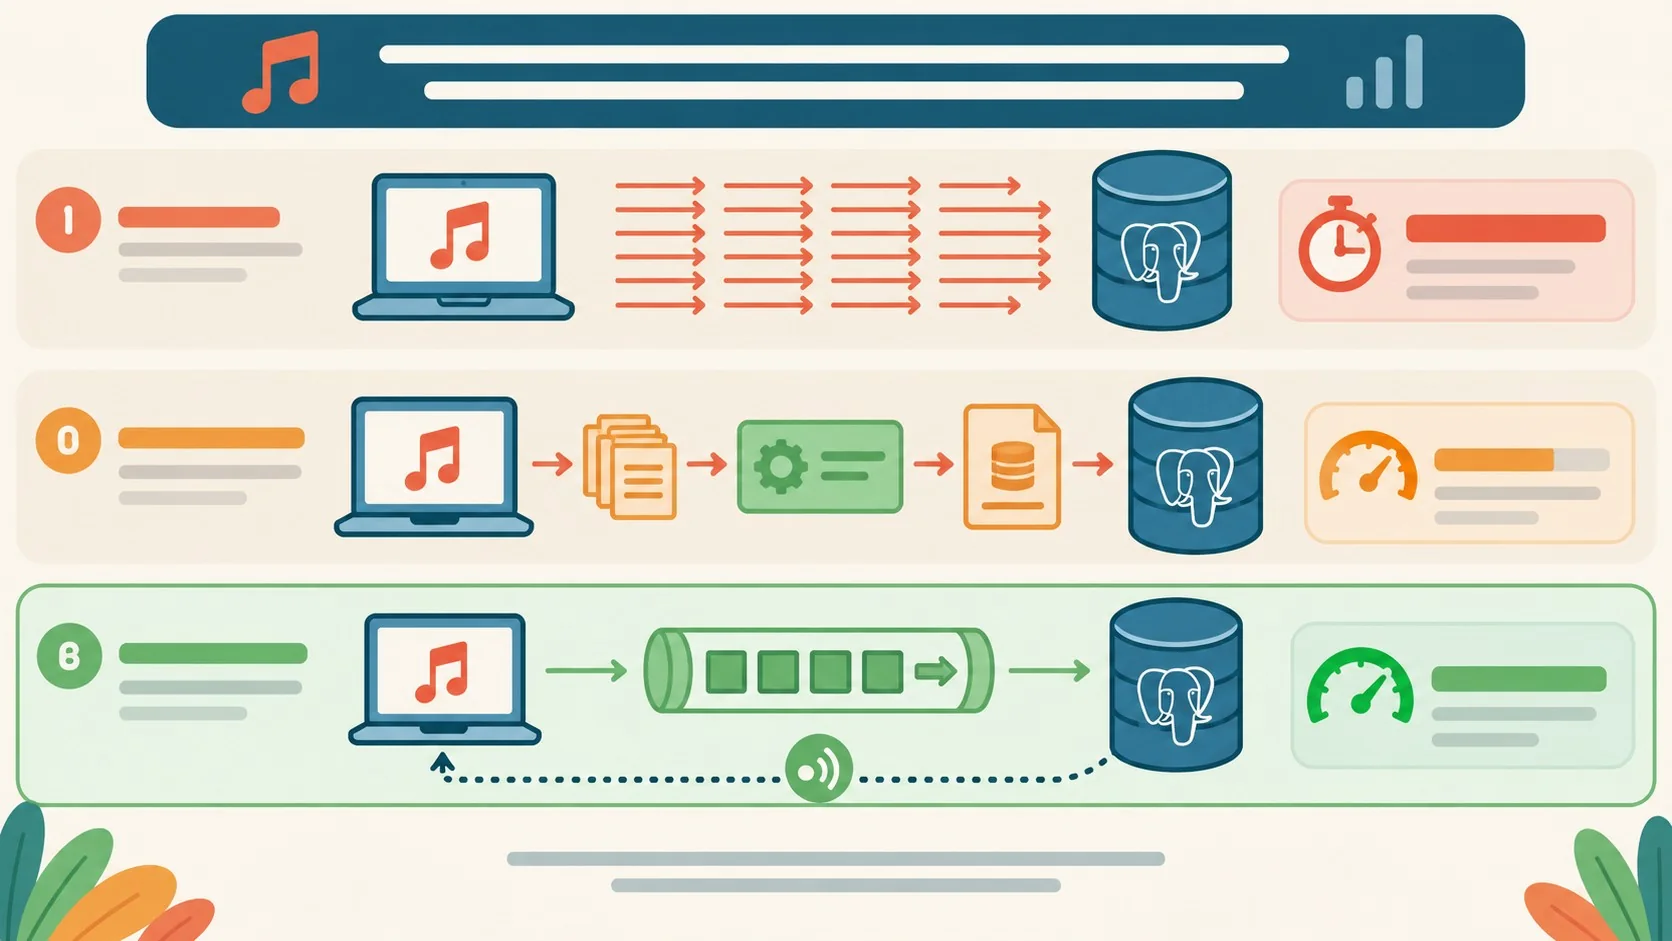
| Enfoque | Mecanismo | Resultado reportado |
|---|---|---|
| 1. Fan-out del cliente | Un POST por canción | Sin cifras propias; 500 canciones con 40 ms de RTT dan más de 25 s según la fuente |
| 2. EF Core en lotes | AddRange + SaveChanges + ChangeTracker.Clear() | Unos 2.900 ítems/seg; 343,6 ms por 1.000 ítems (2.910 ítems/seg) |
| 3. FastIngest + COPY binario | Stream, Channel y NpgsqlBinaryImporter | 63,7 ms por 1.000 ítems (15.710 ítems/seg); 0 a 106 KB asignados |
El progreso en vivo sale del callback OnProgress del pipeline, que empuja las filas procesadas a un hub de SignalR, con un backplane de Redis. Antes de abrir la conexión para el COPY, el endpoint valida que el usuario pertenezca a la organización y chequea el feature gate del plan. En el sink, el id de organización se escribe desde un valor fijo del servidor y no desde cada fila del payload. Eso es lo más sensato del diseño: COPY se salta el ORM y con él cualquier filtro global, así que el control de tenant tiene que estar afuera.
¿Qué límites tiene este benchmark y qué está confirmado?
Son métricas de un solo proyecto, medidas por el autor, sin hardware, tamaño de fila ni método estadístico en el texto. Sirven para ver el orden de magnitud, no para prometerle a tu equipo un 5,4x. (Y sí, es un post de dev.to, no una evaluación independiente.)
Confirmado en documentación oficial:
- Npgsql dice que COPY suele ser mucho más rápido que INSERT y SELECT.
- Sin Complete(), el import binario se revierte al descartar el writer.
- En formato binario no se admiten DELIMITER, NULL ni HEADER, y ON_ERROR ignore solo vale para text y csv.
- COPY FROM no está soportado en tablas con row-level security (la doc sugiere usar INSERT).
Autoinformado o sin verificar:
- Las cifras de latencia y throughput, sin cantidad de corridas ni variabilidad.
- El “0 a 106 KB”, que sale de GC.GetAllocatedBytesForCurrentThread y mide el hilo actual, no la memoria total del proceso.
- La representatividad: son letras de canciones, y tu carga puede tener otras columnas, índices y tamaños.
Un detalle de contexto: la página de la documentación que usamos es la de la versión 17, y a la fecha de esta nota indica que la versión vigente es la 18, con PostgreSQL 19 RC 1 recién publicada el 15 de octubre de 2026. Las reglas de COPY que citamos son las de 17. Lo explicamos a fondo en los costos ocultos de alojar PostgreSQL.
¿Cuándo conviene pasar de EF Core a COPY binario?
Conviene en cargas de onboarding o migración con cientos o miles de filas donde el change tracking no aporta nada, como las bibliotecas de 200 a más de 2.000 chord sheets del caso. Para escrituras transaccionales normales, con lógica de dominio y relaciones, EF Core sigue siendo razonable.
Antes de adoptarlo, una propuesta editorial (no viene de la fuente ni la probamos nosotros) para validar en tu entorno:
- Igualá las condiciones. Misma tabla, mismos índices y misma máquina para ambos enfoques.
- Repetí y quedate con la mediana. Una sola corrida no sirve, y menos con caché fría.
- Contá las filas al final. Un SELECT count(*) contra lo esperado detecta lotes perdidos.
- Mirá pg_stat_progress_copy. La documentación dice que cada backend con COPY reporta su avance ahí, y sirve como control cruzado del progreso que mostrás por SignalR.
Si tu aislamiento de tenants usa row-level security en PostgreSQL, este camino no te sirve tal cual. Para armar un entorno de prueba parecido al de producción, podés mirar los VPS y cloud de donweb.com.
Errores comunes al hacer importación masiva con COPY binario
- Escribir sin NpgsqlDbType. Armás el pipeline, lo probás en tu máquina, anda de maravilla con 1.000 filas, lo subís a producción con un cliente que trae 2.000 canciones y de repente una columna llega con un tipo distinto del que espera la tabla, el COPY falla o, peor, escribe basura sin avisar. Pasá siempre el tipo.
- Olvidarte de Complete(). Sin esa llamada, nada se guarda. Verificá con un conteo de filas.
- Esperar que ON_ERROR ignore funcione en binario. No funciona. Validá antes de escribir, como hace el caso con CollectAndContinue.
- Dar por hecho que COPY convive con RLS. La documentación dice que no. Definilo antes de diseñar el aislamiento.
- Copiar los números del post como promesa. Medí con tus datos.
Preguntas Frecuentes
¿Cuál es la forma más rápida de insertar muchos registros en PostgreSQL desde .NET?
El COPY binario con Npgsql es la opción más rápida de las que compara este caso: 15.710 ítems/seg contra 2.910 con EF Core. La documentación de Npgsql coincide en que COPY suele ser mucho más rápido que INSERT.
¿Por qué EF Core es lento con inserciones masivas?
Según el autor del caso, EF Core arma estado de tracking, evalúa relaciones y genera SQL parametrizado por cada entidad, y PostgreSQL debe parsear y planificar cada INSERT. En su prueba, cambiar el lote entre 50, 100 y 250 no cambió el techo de unos 2.900 ítems/seg.
¿Cómo funciona COPY FROM STDIN en formato binario con Npgsql?
Abrís el import con BeginBinaryImport y un comando COPY … FROM STDIN (FORMAT BINARY), llamás a StartRow y Write por cada fila y columna, y cerrás con Complete(). Si no llamás a Complete(), Npgsql revierte la operación al descartar el writer.
¿Se puede mostrar el progreso de una importación masiva en tiempo real con SignalR?
Sí. El caso usa un callback OnProgress que envía las filas procesadas a un hub de SignalR, con un backplane de Redis. PostgreSQL también reporta el avance de cada COPY en la vista pg_stat_progress_copy, según su documentación.
¿Cuánto mejora el rendimiento usar COPY binario en vez de AddRange?
En este caso mejoró unas 5,4 veces: 1.000 filas pasaron de 343,6 ms a 63,7 ms. Es una medición del autor en un solo proyecto, así que tu resultado puede ser distinto.
Conclusión
El caso de TeamChords v2 muestra que, para cargas masivas donde el tracking no sirve, sacar al ORM del camino y usar COPY binario con Npgsql multiplica el throughput por 5,4 según el propio autor. Lo que queda por probar es cuánto de eso se repite en tu base. Medí con una copia de tus datos, cuidá Complete() y NpgsqlDbType, y revisá si usás row-level security antes de tocar una línea.