Cómo sincronizar Google Sheets con n8n sin releer todo
En pocas palabras: Se logra con push-sync: Apps Script dispara un trigger instalable “on edit” que envía la fila editada por POST a un webhook de n8n, que la guarda en workflow static data, mientras un reconcile nocturno vía gviz/tq corrige las filas perdidas o nunca empujadas.
Un desarrollador identificado como vlotstroom publicó el 22 de octubre de 2026 un diseño open source para sincronizar Google Sheets con n8n sin releer la hoja completa en cada corrida: la planilla empuja los cambios con Apps Script, n8n guarda una copia liviana en memoria y un proceso nocturno corrige lo que se pierde en el camino.
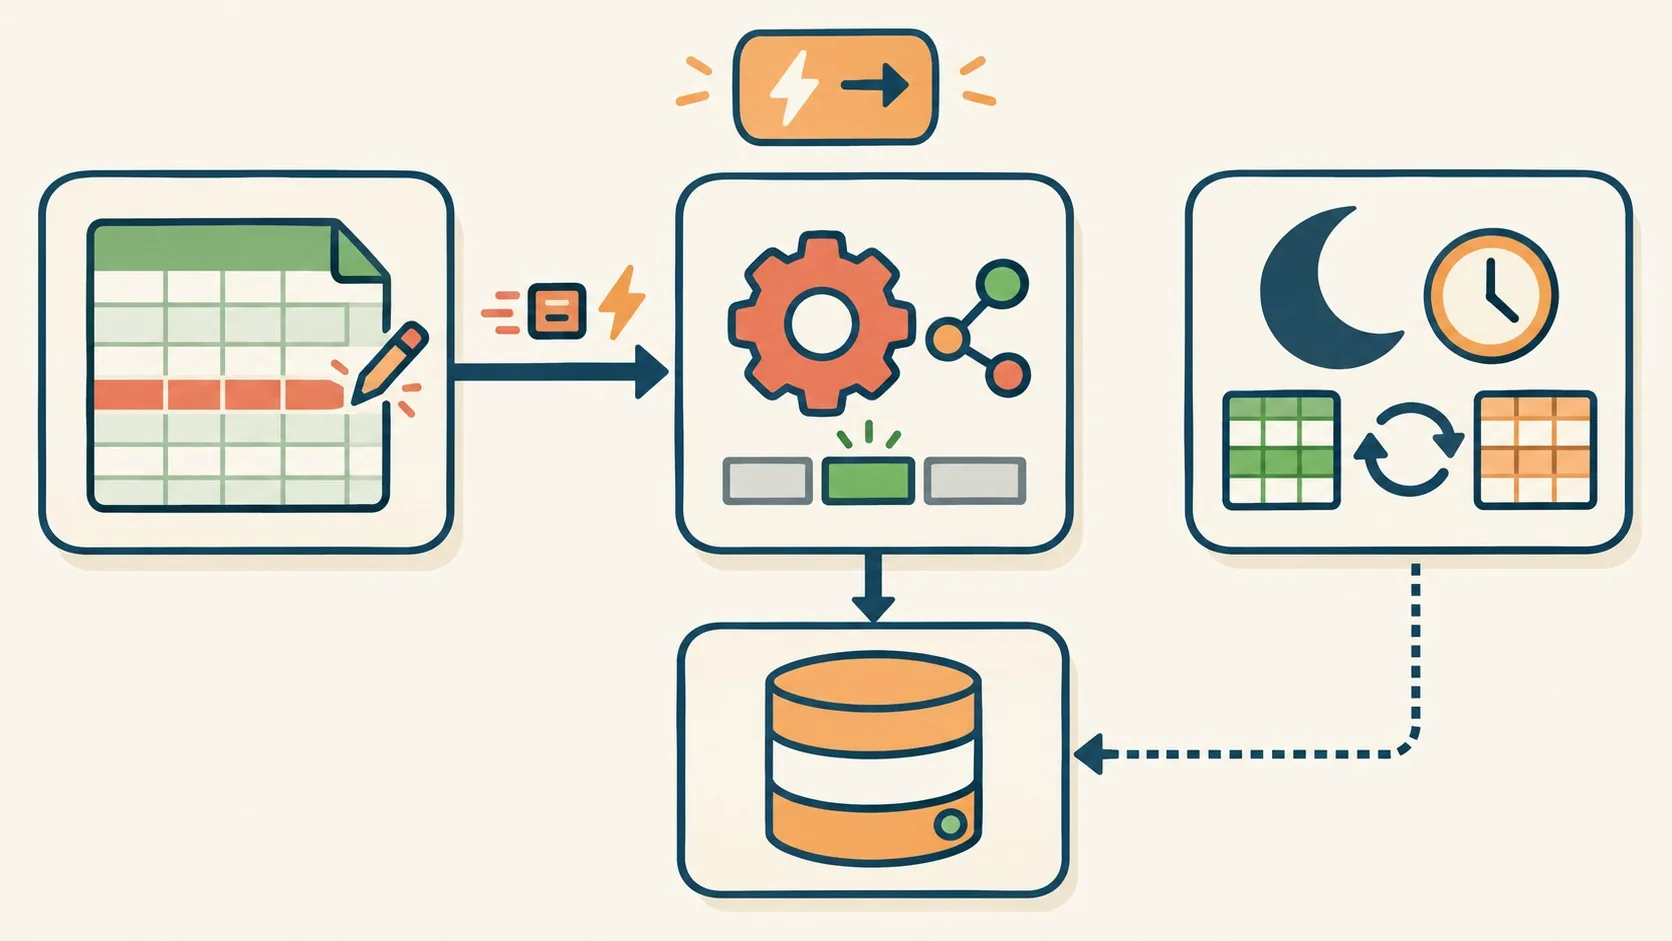
El push-sync es un patrón de integración donde Google Sheets avisa a n8n cada vez que alguien edita una fila, en lugar de que n8n pida toda la hoja por cron. Usa un trigger instalable de Apps Script que dispara un POST a un webhook de n8n, el cual actualiza un registro interno (workflow static data) y, una vez por noche, compara esa copia contra la hoja real con el endpoint gviz/tq de Google.
En este artículo:
- En 30 segundos
- ¿Por qué leer toda la hoja en cada ejecución complica sincronizar Google Sheets con n8n?
- ¿Qué es un trigger instalable en Google Apps Script y para qué sirve?
- ¿Cómo enviar datos de Google Sheets a un webhook de n8n?
- ¿Por qué usar un ID estable en vez del número de fila para sincronizar?
- ¿Cómo funciona la reconciliación nocturna con el endpoint gviz/tq de Google Sheets?
- ¿Qué diferencia hay entre el trigger onChange y el trigger onEdit?
- ¿Por qué no conviene hacer sincronización bidireccional entre Sheets y n8n?
- ¿Cuándo conviene migrar a este patrón y cuándo no?
- Comparación entre los tres mecanismos del diseño
- Errores comunes al implementar este diseño
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El método spreadsheets.values.get de la API v4 no filtra en el servidor: a partir de 50.000 filas, cada lectura completa se vuelve lenta y pesada.
- El endpoint gviz/tq acepta sentencias SELECT … WHERE estilo SQL y devuelve JSON, pero sirve para consultar, no para sincronizar.
- Un trigger instalable “On edit” en Apps Script usa UrlFetchApp.fetch() para mandar un POST a un webhook de n8n en cada edición.
- n8n guarda las filas en workflow static data con un ID estable (no el número de fila) como clave de upsert.
- Una reconciliación nocturna con SELECT A detecta filas borradas y filas que nunca llegaron al store (never_pushed).
¿Por qué leer toda la hoja en cada ejecución complica sincronizar Google Sheets con n8n?
El nodo de Sheets en n8n usa por debajo spreadsheets.values.get, el método de la API v4 que acepta render options pero no condiciones de consulta. Eso significa que cuando limitás columnas desde el nodo, el filtro se aplica después de que Google ya mandó todos los datos, no antes de la transferencia.
Subís el workflow, lo probás con diez filas de prueba, funciona perfecto, lo dejás corriendo por cron contra la hoja real, la planilla crece a 50.000 filas (el ejemplo que usa el diseño original en dev.to) y de repente cada corrida tarda minutos porque el nodo sigue pidiendo todo igual, sin que nadie se haya dado cuenta hasta que alguien se quejó.
Hay una excepción del lado del servidor. El endpoint de Visualization query (gviz/tq) acepta sentencias tipo SELECT … WHERE y devuelve JSON, documentado en la referencia de Google sobre el lenguaje de consulta. Lo golpeás con un nodo HTTP Request. Responde consultas puntuales. No reemplaza una sincronización.
Ejemplo hipotético (no es una medición real, solo sirve para dimensionar el problema): imaginemos una hoja de 50.000 filas y 10 columnas que un workflow lee cada 5 minutos. Si cada lectura completa tardara, digamos, 20 segundos, en un día de 24 horas el cron dispararía 288 lecturas pesadas, aunque en ese día real solo se hayan editado 15 filas. Con push-sync, esas 15 ediciones generan 15 POST livianos de una sola fila cada uno, y la única lectura de la hoja completa queda relegada a la reconciliación nocturna, que además trae solo la columna clave (SELECT A), no las diez.
¿Qué es un trigger instalable en Google Apps Script y para qué sirve?
Un trigger instalable es un gatillo que se agrega manualmente desde Triggers > Add trigger (origen “From spreadsheet”, tipo “On edit”) y que, a diferencia de un trigger simple, puede llamar servicios que necesitan autorización, como UrlFetchApp. Eso es justo lo que hace falta para mandar un POST afuera de la hoja.
La función se escribe en Extensions > Apps Script. El evento que la dispara trae un objeto range que apunta a las celdas editadas, según la guía oficial de triggers de Google. A partir de ahí, la función lee la fila completa con getRange().getValues() y la empaqueta en un POST hacia una URL tipo /webhook/sheet-row, con el nombre de la hoja, el número de fila y los valores.
La autorización corre una sola vez. La hace quien es dueño de la hoja, no un service account tuyo. Para una planilla compartida que gestiona otro equipo, eso es una ventaja y no un trámite extra: nadie externo termina con permisos sobre la hoja, ni depende de un service account propio que haya que gestionar del lado de n8n.
¿Cómo enviar datos de Google Sheets a un webhook de n8n?
Del lado de n8n, el diseño usa un nodo Webhook en modo POST con respuesta “Using Respond to Webhook node”, seguido de un Code node que toma el array de values y lo mapea contra un HEADER fijo, por ejemplo appointment_id, starts_at, status, revenue_eur y source, para armar un objeto con nombres de columna reales en vez de índices sueltos.
Ese objeto se guarda en workflow static data, usando el ID como clave. Si falta el ID, la fila se marca invalid y un IF la manda a un log de errores con el motivo, mientras el webhook responde 422. Como el script de Apps Script corre con muteHttpExceptions, sus fallas son silenciosas por diseño, así que ese log del lado de n8n es la única manera de enterarte si algo se rechazó.
¿Y si llegan dos ediciones rápidas a la misma fila? Mandan dos POST, el segundo pisa al primero, y listo: es el mismo comportamiento de last-write-wins que ya tiene la hoja, sin necesidad de resolver nada a mano.
¿Por qué usar un ID estable en vez del número de fila para sincronizar?
Porque el número de fila cambia con que alguien ordene, inserte o borre filas, y en ese momento deja de identificar nada. El payload que manda Apps Script incluye row_number, pero solo como dato de diagnóstico: la identidad real vive en una columna propia, como appointment_id en el ejemplo del diseño original.
Usar esa columna como clave del upsert en workflow static data hace la sincronización idempotente. La misma fila puede llegar dos veces y el resultado final es un solo registro actualizado, no dos copias sueltas por ahí. Esto es lo que distingue a un upsert bien diseñado de uno frágil: si la clave es inestable (como el número de fila), cada reordenamiento manual de la planilla puede generar registros duplicados o huérfanos en el store, algo que con un ID de negocio simplemente no pasa.
¿Cómo funciona la reconciliación nocturna con el endpoint gviz/tq de Google Sheets?
Una vez por noche, un workflow lee solo la columna clave de la hoja con una consulta SELECT A contra el endpoint gviz/tq, en lugar de traer toda la planilla. La respuesta llega envuelta en un objeto donde las filas están bajo table.rows, no en el nivel superior del JSON, así que hay que aplanarla antes de comparar.
Con esa lista de claves (sheetKeys) comparada contra lo que ya tiene guardado n8n (storeKeys), el workflow calcula dos cosas: las claves que están en el store pero ya no en la hoja (removed, que se borran) y las que están en la hoja pero nunca llegaron al store (never_pushed). Si never_pushed se mantiene arriba de cero noche tras noche, el trigger de push está perdiendo ediciones, y conviene saberlo antes de que se acumule.
Borrar una fila no dispara onEdit. Dispara onChange. Por eso existe el reconcile: tapa el agujero que el push por sí solo no cubre.
¿Qué diferencia hay entre el trigger onChange y el trigger onEdit?
onChange avisa qué tipo de cambio estructural pasó (changeType con valores como INSERT_ROW, REMOVE_ROW o INSERT_COLUMN, según la referencia de eventos de Apps Script), pero no dice en qué fila ni en qué celda, así que no puede disparar un upsert por sí mismo.
Su función en este diseño es otra: adelantar la reconciliación nocturna justo cuando alguien insertó o borró filas, que es el momento en que el store tiene más chances de desincronizarse. Uno dice dónde. El otro dice qué. Ninguno alcanza solo.
¿Por qué no conviene hacer sincronización bidireccional entre Sheets y n8n?
Porque una sincronización de dos vías necesita resolver conflictos (dos sistemas escribiendo la misma fila, sin un ganador natural salvo que confíes en timestamps y definas reglas de quién gana), y last-write-wins de los dos lados termina perdiendo datos sin que nadie se entere. No hace falta ninguna “solución mágica” de sync bidireccional para resolver esto: alcanza con aceptar que hay un solo escritor legítimo (la hoja) y tratar a n8n como un lector que se puede reconstruir.
El diseño push mantiene a la hoja como la única fuente de verdad y a n8n como una proyección descartable. Si el store se corrompe, se borra el workflow static data, se corre el reconcile, y la proyección se reconstruye entera desde la hoja. Una proyección que podés reconstruir le gana a una réplica que tenés que andar reparando a mano, porque el costo de un error deja de ser “perder datos” y pasa a ser “esperar a la próxima reconciliación”.
El mismo autor aplica esta lógica en un paquete de workflows de gestión de turnos que vende por 29 euros, con validación con motivo por campo y logs de error, el mismo patrón descripto para esta sincronización. Si vas a levantar tu propia instancia de n8n para probar el diseño, conviene alojarla en infraestructura cloud confiable como donweb.com y no en un servidor casero que se cae justo cuando alguien edita la hoja.
¿Cuándo conviene migrar a este patrón y cuándo no?
No todo workflow que lee una hoja necesita este rediseño. Antes de meterle Apps Script y un webhook nuevo, vale la pena revisar estos criterios, derivados directamente de las condiciones que describe el diseño original:
- Tamaño de la hoja: si tiene cientos de filas y cabe cómoda en una lectura de segundos, el costo de mantener Apps Script, un webhook y un reconcile probablemente no se justifica todavía.
- Frecuencia de edición manual: este diseño tiene sentido cuando la hoja la edita gente todo el día. Si se actualiza una vez por semana, un cron simple sigue siendo más barato de mantener.
- Quién puede autorizar el trigger: el trigger instalable necesita que el dueño de la hoja lo autorice una sola vez. Si esa persona no está disponible o la hoja cambia de dueño seguido, el mantenimiento se complica.
- Tolerancia al drift: el reconcile corre una vez por noche, así que una fila borrada o un push perdido puede tardar hasta 24 horas en corregirse. Si tu caso de uso necesita consistencia inmediata, este diseño no la garantiza por sí solo.
- Si ya existe un ID estable en la hoja: sin una columna de identidad propia (no el número de fila), el upsert pierde la base que lo hace idempotente y el diseño completo pierde sentido.
Comparación entre los tres mecanismos del diseño
| Mecanismo | Qué informa | Qué no informa | Rol en el diseño |
|---|---|---|---|
| Trigger onEdit instalable | Rango de celdas editadas (e.range) | Si una fila fue borrada o insertada estructuralmente | Dispara el push en tiempo real hacia el webhook |
| Endpoint gviz/tq | Resultado de una consulta SELECT…WHERE sobre una o más columnas | No detecta cambios por sí solo, hay que consultarlo | Alimenta la reconciliación nocturna leyendo solo la columna clave |
| Trigger onChange instalable | Tipo de cambio estructural (INSERT_ROW, REMOVE_ROW, INSERT_COLUMN) | En qué fila o celda ocurrió el cambio | Adelanta el reconcile cuando hay inserciones o borrados |
Errores comunes al implementar este diseño
- Usar un trigger simple en vez de instalable: los triggers simples no pueden llamar UrlFetchApp porque no tienen la autorización necesaria, así que el POST nunca sale.
- Confundir el filtro de columnas del nodo con un filtro de servidor: narrowing en el nodo de Sheets pasa después de que Google ya transfirió toda la fila, no antes.
- Dejar row_number como identidad: en cuanto alguien ordena o borra filas, ese número deja de apuntar a la fila correcta y el upsert empieza a pisar datos equivocados.
- Ignorar las fallas silenciosas de muteHttpExceptions: sin un log de errores del lado de n8n, un webhook caído o un payload inválido desaparece sin dejar rastro.
- Intentar sync bidireccional sin reglas de conflicto: dos escrituras a la misma fila sin timestamps confiables terminan perdiendo datos de forma silenciosa.
Preguntas Frecuentes
¿Cómo evitar que n8n lea toda la hoja de Google Sheets en cada ejecución?
Invirtiendo el flujo: en vez de que n8n pida la hoja completa por cron, la hoja empuja las filas editadas con un trigger onEdit instalable de Apps Script hacia un webhook de n8n, que guarda una copia propia en workflow static data.
¿Qué es un trigger instalable en Google Apps Script y para qué sirve?
Es un gatillo configurado manualmente desde Triggers > Add trigger que, a diferencia de un trigger simple, puede ejecutar servicios con autorización como UrlFetchApp. Sirve para mandar peticiones HTTP hacia afuera de la hoja cuando pasa un evento como “On edit”.
¿Cómo enviar datos de Google Sheets a un webhook de n8n?
Con una función de Apps Script enganchada a un trigger onEdit que lee la fila con getRange().getValues() y hace un UrlFetchApp.fetch() tipo POST con contentType application/json hacia la URL del webhook configurado en el nodo Webhook de n8n.
¿Por qué no conviene hacer sincronización bidireccional entre Sheets y n8n?
Porque necesita resolver conflictos entre dos escritores sobre la misma fila sin un ganador natural, y last-write-wins en ambos lados pierde datos sin aviso. El diseño push mantiene a la hoja como fuente única de verdad y a n8n como una proyección reconstruible.
¿Qué es el endpoint gviz/tq de Google Sheets y para qué se usa?
Es el endpoint de Visualization query de Google, que acepta sentencias tipo SELECT … WHERE y devuelve JSON con los datos envueltos bajo table.rows. En este diseño se usa para leer solo la columna clave durante la reconciliación nocturna, sin bajar toda la planilla.
Conclusión
El diseño publicado el 22 de octubre de 2026 no inventa una API nueva de Google. Reordena tres piezas que ya existen (trigger instalable, webhook con upsert idempotente y reconciliación nocturna vía gviz/tq) para que la carga pesada de leer 50.000 filas deje de repetirse en cada corrida.
Lo que podés concluir con estos datos: si tu workflow lee la hoja completa por cron y la planilla crece, vale la pena medir cuánto tarda hoy ese nodo de Sheets antes de migrar a push-sync, no después. Lo que estos datos no permiten afirmar es cuánto mejora el tiempo de ejecución en tu caso puntual: eso depende del tamaño real de tu hoja y de la frecuencia de edición, algo que solo se verifica corriendo las dos versiones del workflow y comparando los tiempos propios.