Almacenamiento de objetos en la nube: S3 vs R2 vs Supabase
En pocas palabras: Para avatares de usuario conviene subida privada desde el servidor con clave de idempotencia y URLs prefirmadas de descarga temporal. Según documentación oficial de Amazon S3, estas URLs pueden durar hasta 7 días con SDK o CLI, y hasta 12 horas desde la consola.
Elegir almacenamiento de objetos en la nube para avatares de usuario se resuelve con una sola pregunta: qué pasa cuando un reintento falla a mitad de camino. Amazon S3, Cloudflare R2, Supabase Storage y los backends unificados tipo Infrai resuelven ese límite de forma distinta, según plantea un artículo técnico publicado el 23 de octubre de 2026 en Dev.to. Vale aclarar algo antes de seguir: ese artículo tiene bastante código de ejemplo apuntado a un producto específico (Infrai), así que conviene leerlo separando el criterio técnico —que es sólido y sirve para cualquier proveedor— de la promoción de ese backend en particular.
El almacenamiento de objetos en la nube es un servicio que guarda archivos (imágenes, avatares, documentos) como objetos binarios identificados por una clave única, sin la jerarquía de carpetas de un sistema de archivos tradicional. Amazon S3, Cloudflare R2 y Supabase Storage son ejemplos de este modelo. Para subir avatares de usuario, la clave está en combinar subida privada desde el servidor con URLs prefirmadas de descarga temporal, según plantea el artículo de Dev.to.
En este artículo:
- En 30 segundos
- ¿Por qué el límite de reintentos importa más que la velocidad de subida?
- ¿Qué criterios seguir al armar el flujo de subida desde el servidor?
- ¿Qué es una URL prefirmada y cómo evita exponer archivos privados?
- ¿Qué diferencia a Amazon S3, Cloudflare R2, Supabase Storage y un backend unificado de almacenamiento de objetos en la nube?
- ¿Cuándo conviene subir archivos directo desde el navegador en vez del servidor?
- ¿Qué errores de diseño conviene evitar al implementar subida de archivos?
- ¿Qué significa esto para un equipo chico en Latinoamérica?
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El problema de fondo no es la velocidad de subida, es qué pasa cuando un reintento no te confirma si el write se aplicó o no.
- La base de datos tiene que llevar la cuenta del estado (pendiente / subido); el bucket solo guarda bytes.
- Una URL prefirmada de S3 puede valer hasta 7 días con credenciales de usuario IAM y Signature Version 4, según la documentación oficial de AWS.
- S3, R2 y Supabase Storage resuelven versionado, replicación y CORS de formas distintas; antes de elegir conviene listar qué necesitás de verdad, no qué suena mejor en una tabla.
- Subir directo desde el navegador ahorra ancho de banda del servidor, pero exige que tu dominio ya tenga resuelto el tema CORS, cosa que no todos los backends configuran de forma independiente.
¿Por qué el límite de reintentos importa más que la velocidad de subida?
Importa más porque un reintento mal diseñado genera un objeto ambiguo, mientras que una subida lenta solo genera demora. El invariante es simple: un reintento nunca debería crear un segundo objeto por error, y un link de descarga nunca debería otorgar acceso público sin que alguien lo haya decidido.
Ponele que subís un avatar, la conexión se corta a mitad de la transferencia y tu cliente reintenta automáticamente. El problema no es el reintento en sí —eso está bien—, el problema es qué pasa si el primer intento sí había llegado al servidor pero la respuesta nunca volvió a tu lado. Ahí tenés dos objetos con contenido parecido y ningún registro claro de cuál es el válido. Un timeout no te dice si el servidor aplicó el write o no, y esa es la parte que conviene asumir siempre, no una excepción rara.
Ejemplo hipotético (ilustrativo, no un caso real): imaginá una app de turnos médicos donde el paciente sube la foto de su DNI al registrarse. Si el flujo trata “upload exitoso” como el final del proceso, y la red se corta justo cuando el servidor ya guardó el archivo pero la confirmación no llegó al cliente, el usuario ve un error, reintenta, y ahora hay dos fotos de DNI con nombres distintos en el bucket. Si el sistema solo guarda la última key que “parece haber funcionado”, nadie sabe cuál de las dos quedó asociada al perfil. La salida no es evitar el reintento, es que la base de datos tenga un registro en estado pending antes de intentar la subida, y recién lo pase a uploaded después de confirmar la respuesta del storage. Si queda colgado en pending por más de X minutos, un proceso de reconciliación lo revisa y decide si reintentar o descartar.
Más contexto sobre esta lógica de diseño al evaluar hosting en la nube frente a local.
¿Qué criterios seguir al armar el flujo de subida desde el servidor?
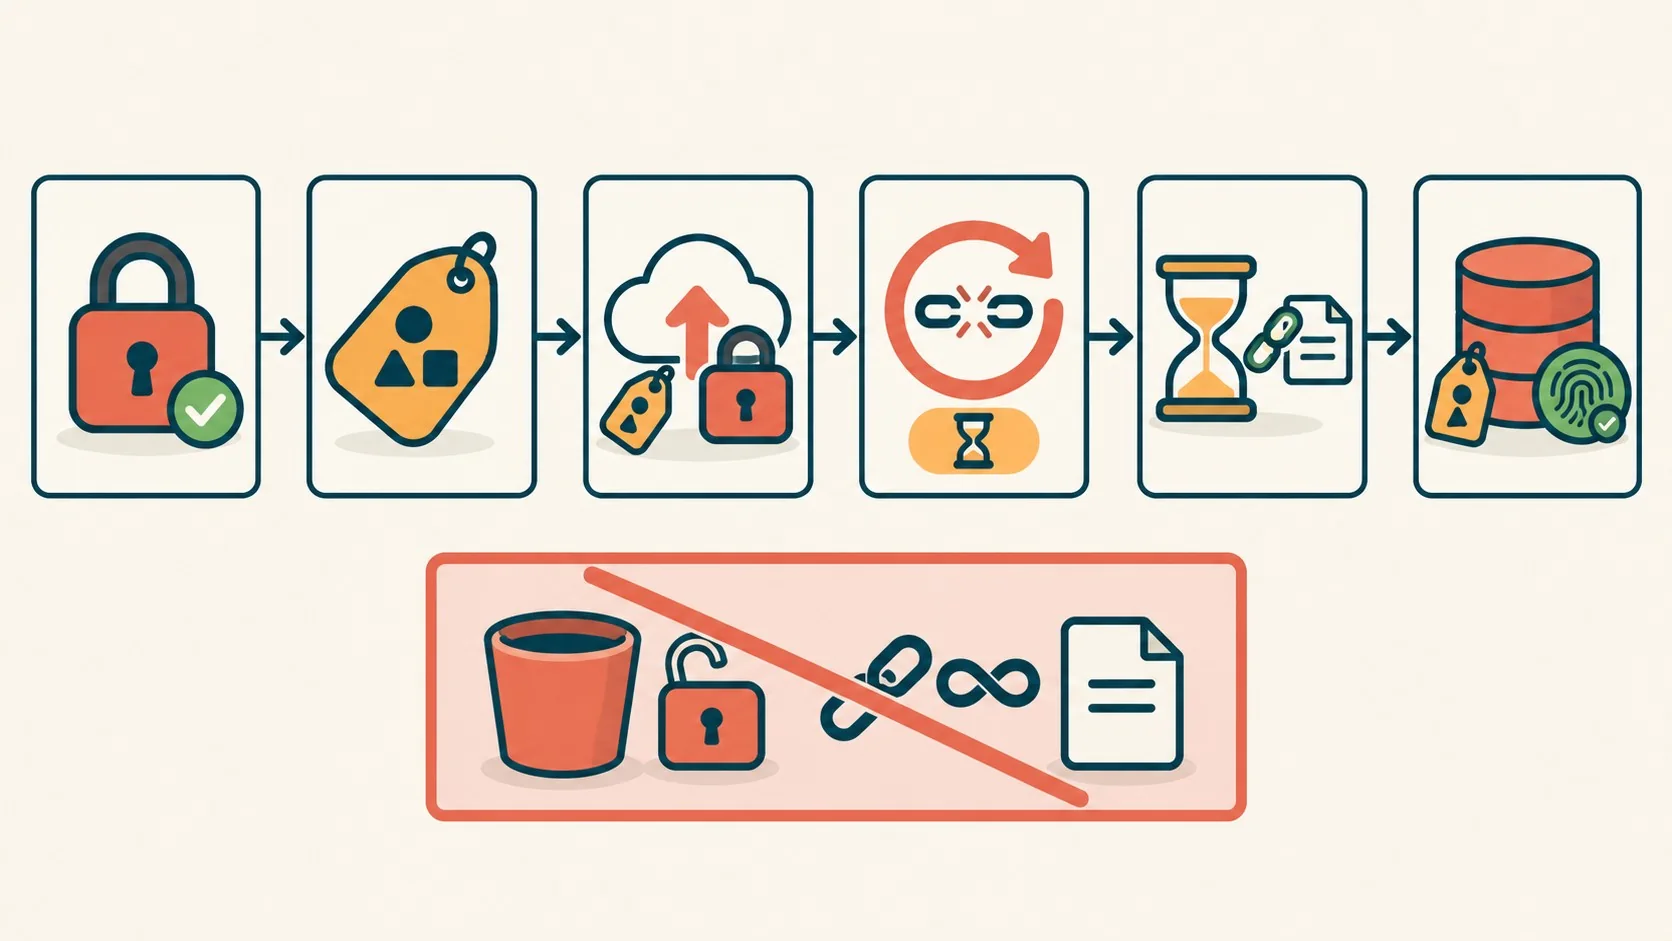
No hace falta memorizar una lista de pasos como si fuera una receta; lo que importa es el criterio detrás de cada decisión. Según el artículo de Dev.to, el camino crítico para archivos grandes se puede resumir en cuatro criterios que, en la práctica, cubren casi cualquier implementación:
- La autenticación vive en tu API, no en el bucket. El usuario nunca debería tener credenciales directas contra el storage; eso lo decide tu backend.
- La clave del objeto es opaca, no el nombre original del archivo. Algo como
tenant/asset-id/original.binen vez de usar el nombre que mandó el cliente, porque ese nombre podés recibirlo manipulado. - Cada intento de subida lleva una clave de idempotencia estable, para que un reintento con la misma clave sea reconocido como “el mismo intento” y no genere un objeto nuevo.
- El estado vive en tu base de datos, no en el storage. El storage guarda bytes; tu aplicación decide si ese archivo está pendiente, confirmado, o hay que reconciliarlo.
Sobre esos cuatro criterios, después hay detalles de implementación: reintentar solo errores transitorios (429, 5xx) respetando Retry-After, y generar la URL de descarga solo cuando el usuario realmente la pide, no en el momento de subir. Pero si solo te llevás una cosa de esta sección, que sea esta: la idempotencia hace que el reintento sea seguro, no que una respuesta desconocida se vuelva exitosa. Eso lo sigue resolviendo la reconciliación posterior, no el reintento.
¿Qué es una URL prefirmada y cómo evita exponer archivos privados?
Una URL prefirmada es un link con firma criptográfica que otorga acceso temporal a un objeto privado, sin tocar la política del bucket ni exponer credenciales. Así la define la documentación oficial de Amazon S3: cualquiera con la URL puede usarla hasta que expire, pero las credenciales de fondo siguen siendo las del principal IAM que la generó.
Con un usuario IAM y Signature Version 4, el límite de expiración llega a 7 días. Con credenciales temporarias (rol de IAM, instancia EC2, STS), la URL muere cuando mueren esas credenciales, aunque hayas puesto una fecha de expiración más larga. Eso explica un comportamiento que puede resultar confuso: una URL “configurada para 12 horas” puede dejar de funcionar a las 6 horas si corre sobre un rol de EC2, porque hereda esa ventana más corta de sus credenciales de fondo.
Hay un detalle de seguridad que conviene remarcar con criterio propio: la URL de descarga que te devuelve el servicio ya es, en sí misma, la capacidad de acceso completa. No necesita nada más. Por eso agregarle el header Authorization de tu propio backend no solo es innecesario, es un riesgo: ese header va dirigido a tu API, no al storage, y si el navegador o un worker lo reenvía a un destino equivocado, estás filtrando credenciales que no tenían por qué viajar ahí. Lo explicamos a fondo en comparando almacenamiento de objetos sin costo de egreso.
¿Qué diferencia a Amazon S3, Cloudflare R2, Supabase Storage y un backend unificado de almacenamiento de objetos en la nube?
La diferencia está en dónde cada producto pone el límite operativo, no en quién sube archivos más rápido. La comparación útil no es un ranking de velocidad, es la que podés probar contra tus propios requisitos de recuperación ante fallas.
| Opción | Mejor uso | Qué hay que verificar antes |
|---|---|---|
| Amazon S3 | Estrategia de archivos en crecimiento que necesita control operativo maduro | Configuración exacta de versionado, object lock, replicación y lifecycle |
| Cloudflare R2 | Storage compatible con S3 cuando el borde de Cloudflare ya forma parte del diseño | Recuperación de multipart, supuestos de egress y procedimientos de migración |
| Supabase Storage | Subidas que conviven con auth y base de datos de una app Supabase | Comportamiento con archivos grandes y política de URLs firmadas |
| Backend unificado (ej. Infrai) | Contrato REST único cuando el storage es una capacidad más entre varias | Suele faltar versionado, object lock y replicación automática entre regiones; conviene chequearlo caso por caso |
Criterios de decisión, antes de mirar la tabla de precios de nadie:
- ¿Necesitás poder recuperar una versión anterior de un archivo borrado por error? Si la respuesta es sí, el versionado deja de ser un “nice to have” y pasa a ser un requisito duro: ahí S3 es la opción conservadora.
- ¿Tu infraestructura ya vive del lado de Cloudflare (Workers, Pages, DNS)? Si sí, R2 reduce una cuenta más para auditar; si no, el ahorro de egreso no compensa sumar una plataforma nueva.
- ¿Tu app ya depende de la auth y la base de datos de Supabase? Si sí, Supabase Storage te evita reconciliar estado entre dos sistemas distintos.
- ¿El storage es una pieza chica de un backend que también va a manejar otras cosas (colas, funciones, autenticación)? Ahí un backend unificado tiene sentido práctico, siempre que confirmes de antemano que podés vivir sin versionado ni replicación automática.
Ninguna de estas opciones es universalmente mejor. Supabase Storage es razonable cuando el modelo de datos de Supabase ya es el centro de gravedad del proyecto. Un backend unificado como el que describe la fuente de Dev.to puede reducir pegamento de integración cuando el mismo servicio maneja más que solo uploads, pero esa comodidad tiene un costo: menos controles de recuperación de serie, que hay que compensar con disciplina propia en tu base de datos.
¿Cuándo conviene subir archivos directo desde el navegador en vez del servidor?
Conviene cuando tu dominio y tu gateway ya soportan el comportamiento CORS que esa subida necesita, no antes. La subida directa desde el browser reduce el ancho de banda que consume tu servidor de aplicación, pero introduce una decisión de CORS que hay que resolver primero, no sobre la marcha.
El artículo de Dev.to señala algo puntual: algunos backends no tienen una ruta independiente para configurar CORS (set_cors), y eso hay que tomarlo como un límite de arquitectura, no como un detalle a resolver después del lanzamiento. Si tu proveedor de storage no te da esa configuración de forma independiente, el flujo desde el navegador solo tiene sentido si otra capa de tu stack (gateway, CDN, reverse proxy) ya puede manejar CORS por su cuenta. En nuestra guía completa de cloud-hosting profundizamos sobre esto.
Si tu backend corre sobre un VPS propio, vale la pena revisar esa capa de infraestructura antes de decidir. Para proyectos que arrancan en Argentina, donweb.com es una opción conocida para alojar la capa de autenticación y lógica que genera las URLs prefirmadas, separada del bucket de storage en sí.
¿Qué errores de diseño conviene evitar al implementar subida de archivos?
El error más caro es tratar todos los códigos de error HTTP como si fueran lo mismo. Un 400 necesita mostrar el cuerpo del error al usuario, un 429 necesita esperar según Retry-After, un timeout necesita reconciliación posterior, y un 5xx necesita reintento acotado con una operación idempotente. Meterlos todos en un único loop de reintento es la forma más rápida de convertir un endpoint de upload en una cola de incidentes.
El segundo error es optar por un bucket público con URL permanente para resolver el problema de compartir archivos. Ese patrón funciona para un catálogo de assets genuinamente público o un sitio estático, pero es incorrecto para documentos de usuario, fotos de perfil privadas o cualquier archivo con dueño identificable.
El tercer error, menos obvio, son los fragmentos multipart abandonados. En servicios donde el lifecycle mínimo configurable es de un día (no de una hora), un fragmento de una subida multipart interrumpida puede quedar guardado —y facturado— sin que nadie lo note. Si tu flujo puede dejar subidas multipart a medio terminar, necesitás un proceso externo propio que las rastree y las borre; no asumas que el proveedor lo hace por vos.
Por último: no uses metadata como índice de búsqueda. El listado de objetos en la mayoría de estos servicios soporta filtrado por prefijo, nada más sofisticado. El estado de tu aplicación, en tu base de datos, sigue siendo la única fuente confiable sobre qué archivo pertenece a quién. Cubrimos ese tema en detalle en la guía de solución de problemas de hosting.
¿Qué significa esto para un equipo chico en Latinoamérica?
Para un equipo chico, la decisión rara vez es puramente técnica: también es quién mantiene el pegamento entre servicios y cuántas cuentas distintas hay que auditar cada mes. En vez de buscar el precio exacto por gigabyte —que cambia seguido y depende del plan y la región de cada proveedor—, tiene más sentido hacerse estas preguntas antes de elegir:
- ¿Cuántos sistemas distintos ya factura tu equipo (hosting, base de datos, auth, storage)? Cada proveedor nuevo es una cuenta más para monitorear y un contrato más para entender cuando algo falla.
- ¿Quién en el equipo es responsable de revisar la facturación y las alertas de cada servicio? Si la respuesta es “nadie en particular”, sumar un proveedor de storage separado sin necesidad concreta multiplica ese problema.
- ¿Tu app ya depende de un stack (Supabase, Cloudflare, AWS)? Quedarte dentro de ese mismo ecosistema para el storage suele significar menos cosas para aprender a mantener, aunque no sea la opción técnicamente “óptima” en el papel.
Si tu backend ya corre sobre infraestructura propia o un VPS, mantener el storage separado y bien delimitado (bucket privado, base de datos como dueña del estado) suele salir más simple de mantener en el tiempo que perseguir la opción que gana un benchmark de velocidad.
Preguntas Frecuentes
¿Cómo elijo un almacenamiento de objetos en la nube para subir avatares de usuario?
Elegí según tu necesidad de recuperación ante fallas, no según velocidad de subida. Si necesitás versionado, object lock o replicación entre regiones, Amazon S3 es la opción conservadora; si tu app ya vive en Supabase o en el borde de Cloudflare, Supabase Storage o R2 reducen fricción de integración.
¿Qué es una URL prefirmada y por qué es más segura que un link público?
Una URL prefirmada otorga acceso temporal y firmado a un objeto privado sin cambiar la política del bucket, según la documentación oficial de AWS. Es más segura que un link público porque expira (hasta 7 días con credenciales IAM) y hereda los permisos de quien la generó, en vez de quedar accesible para siempre.
¿Cómo evito que un reintento de subida cree un archivo duplicado?
Usá una clave de idempotencia estable en cada request de subida y guardá el estado del archivo (pending / uploaded) en tu base de datos antes de empezar la transferencia. Así, si un reintento llega después de un timeout, el servidor reconoce la misma operación en vez de crear un objeto nuevo.
¿Qué diferencia hay entre Amazon S3, Cloudflare R2 y Supabase Storage para subir archivos?
S3 tiene el ecosistema más maduro para versionado, object lock y replicación; R2 ofrece una API estilo S3 pero integrada al borde de Cloudflare; Supabase Storage se integra directo con el modelo de auth y base de datos de una app Supabase. Ninguna es universalmente mejor, cada una resuelve el límite operativo en un lugar distinto de la arquitectura.
¿Es seguro subir avatares directamente desde el navegador a un bucket en la nube?
Es seguro solo si tu dominio y gateway ya soportan la configuración CORS necesaria para esa subida directa. Sin esa configuración resuelta de antemano, subir desde el servidor con clave privada y presignar solo la descarga es el camino más simple y, en general, el más confiable.
Conclusión
La elección de almacenamiento de objetos en la nube para avatares no se gana en una tabla de precios, se gana en cómo cada opción maneja un reintento fallido. S3 queda como la opción conservadora cuando versionado y replicación son no negociables. R2 y Supabase Storage tienen sentido cuando ya conviven con una plataforma mayor. Un backend unificado reduce pegamento de integración, pero exige asumir que no hay red de seguridad de versionado detrás, y conviene confirmarlo con el proveedor puntual que estés evaluando, no asumirlo por la categoría.
Lo que no cambia con ninguna opción: la base de datos tiene que ser dueña del estado, el bucket tiene que ser dueño de los bytes, y cada reintento necesita una identidad propia. Antes de mover algo a producción, probá el escenario de timeout a propósito —cortá la conexión a mitad de una subida de prueba— y mirá qué hace tu sistema. Si no tenés una respuesta clara sobre qué queda guardado y qué estado le asigna tu base de datos, todavía no está listo.