Blue-Green vs Canary: las lecciones de Knight y CrowdStrike
En pocas palabras: Rolling actualiza instancias de a lotes, blue-green conmuta todo el tráfico de una vez entre dos ambientes completos, y canary expone un porcentaje chico de tráfico real antes de ampliarlo. CrowdStrike no usó ninguna de las tres el 19 de julio de 2024 y tiró 8,5 millones de máquinas Windows; Microsoft estimó ese número al día siguiente.
El 1 de agosto de 2012, Knight Capital perdió $460 millones en 45 minutos por un rolling deployment manual sin verificación en ocho servidores. Doce años después, el 19 de julio de 2024, CrowdStrike tiró 8,5 millones de máquinas Windows por no tener ninguna etapa de staging. Son dos fallas de naturaleza distinta, pero las dos terminan en el mismo lugar: la forma en que se entrega una actualización decide qué tan grande es el daño y qué tan rápido se puede frenar.
Rolling, blue-green y canary deployment son las tres estrategias estándar para llevar código nuevo a producción sin cortar el servicio. Ninguna es automáticamente “la correcta”: cada una mueve el tráfico de forma distinta y, por eso mismo, cada una falla de forma distinta cuando algo sale mal.
En este artículo:
- Resumen rápido
- ¿Qué pasó con Knight Capital en 2012 y por qué perdió $460 millones en 45 minutos?
- ¿Qué causó la caída masiva de CrowdStrike en 2024?
- ¿Qué diferencia a rolling, blue-green y canary deployment?
- Ejemplo hipotético: el mismo bug, tres destinos distintos
- ¿Qué preguntas te tenés que hacer antes de elegir una estrategia?
- ¿Cuáles son los límites y riesgos de cada estrategia de despliegue?
- ¿Cómo elegir la estrategia de despliegue correcta para tu equipo?
- Errores comunes al elegir estrategia de despliegue
- Comparación: rolling vs blue-green vs canary deployment
- Preguntas Frecuentes
- Conclusión
- Fuentes
Resumen rápido
- Knight Capital perdió $460 millones (según la SEC) en 45 minutos el 1/8/2012 por un rolling deployment manual sin revisión cruzada en 8 servidores.
- CrowdStrike tiró 8,5 millones de máquinas Windows el 19/7/2024 al mandar una actualización a todos los hosts a la vez, sin canary ni staging.
- Blue-green necesita el doble de infraestructura, pero permite un rollback instantáneo con un solo switch.
- Canary arranca con 1% a 5% del tráfico y lo amplía según métricas, pero necesita observabilidad sólida para que la muestra sea representativa.
- El propio informe de causa raíz de CrowdStrike prometió pasar a un despliegue escalonado que arranca con canary.
¿Qué pasó con Knight Capital en 2012 y por qué perdió $460 millones en 45 minutos?
Un técnico de Knight Capital copió código nuevo a siete de ocho servidores de producción y nadie revisó que el despliegue estuviera completo. En el octavo servidor, que quedó corriendo la versión vieja, un feature flag reciclado despertó una rutina muerta llamada Power Peg, según la reconstrucción del caso publicada por Ciphemic Academia.
En los primeros 45 minutos después de la apertura del mercado, el router de la firma mandó más de 4 millones de órdenes tratando de completar apenas 212 pedidos de clientes, operando 397 millones de acciones en 154 papeles. La SEC calculó la pérdida en más de $460 millones; la contabilidad propia de Knight habló de unos $440 millones, según repasa Ciphemic Academia. La firma terminó pagando una multa de $12 millones y, meses después, fue adquirida por otra compañía: nunca recuperó la reputación.
Lo peor vino después del error inicial. Cuando los ingenieros se dieron cuenta del desastre, revirtieron el código nuevo en los siete servidores sanos, lo que esparció el comportamiento viejo todavía más. Ahí está la primera lección incómoda: un rollback mal pensado puede empeorar una falla en vez de contenerla.
¿Qué tiene que ver esto con elegir entre rolling, blue-green o canary? Todo. Knight tenía, sin saberlo, un rolling deployment a medio terminar: siete instancias con el código nuevo y una con el viejo, corriendo en simultáneo, sin que nadie verificara que las ocho estuvieran alineadas antes de abrir el mercado. No fue una falla “de rolling deployment”: fue un rolling deployment que nadie terminó de ejecutar ni de chequear.
¿Qué causó la caída masiva de CrowdStrike en 2024?
CrowdStrike empujó una actualización de contenido defectuosa (el archivo de canal 291) a todos los hosts Windows que estaban online entre las 04:09 y las 05:27 UTC del 19 de julio de 2024, sin ninguna etapa de staging previa. El resultado: unas 8,5 millones de máquinas entraron en bucle de arranque o pantalla azul, según estimó Microsoft al día siguiente del incidente, de acuerdo con el registro de Wikipedia.
El problema técnico de fondo era más puntual de lo que parece desde afuera. El sensor Falcon validaba los archivos de canal con expresiones regulares y los cargaba en un arreglo esperando 21 campos, pero el archivo tenía el formato viejo de 20 campos, y nadie chequeó la longitud antes de acceder a la memoria. Las pruebas unitarias solo cubrieron el camino feliz. No hubo pruebas de regresión contra el formato anterior, y los archivos de canal ni siquiera tenían un número de versión verificado.
El apagón frenó aerolíneas como United, Delta y American, afectó a la Bolsa de Londres, a Lloyds Bank y a la mayoría de los consultorios médicos del Reino Unido, según repasa Computer Weekly. Se cancelaron más de 1.000 vuelos en todo el mundo.
En su propio informe de causa raíz, CrowdStrike prometió pasar a un despliegue escalonado que arranca con un canary deployment y se va ampliando de forma gradual, además de darle a los clientes más control sobre cuándo bajan las actualizaciones. Dicho de otra forma: la propia empresa reconoció, a posteriori, que el canary que no tenía habría limitado el desastre a una fracción de esos 8,5 millones de equipos.
¿Qué diferencia a rolling, blue-green y canary deployment?
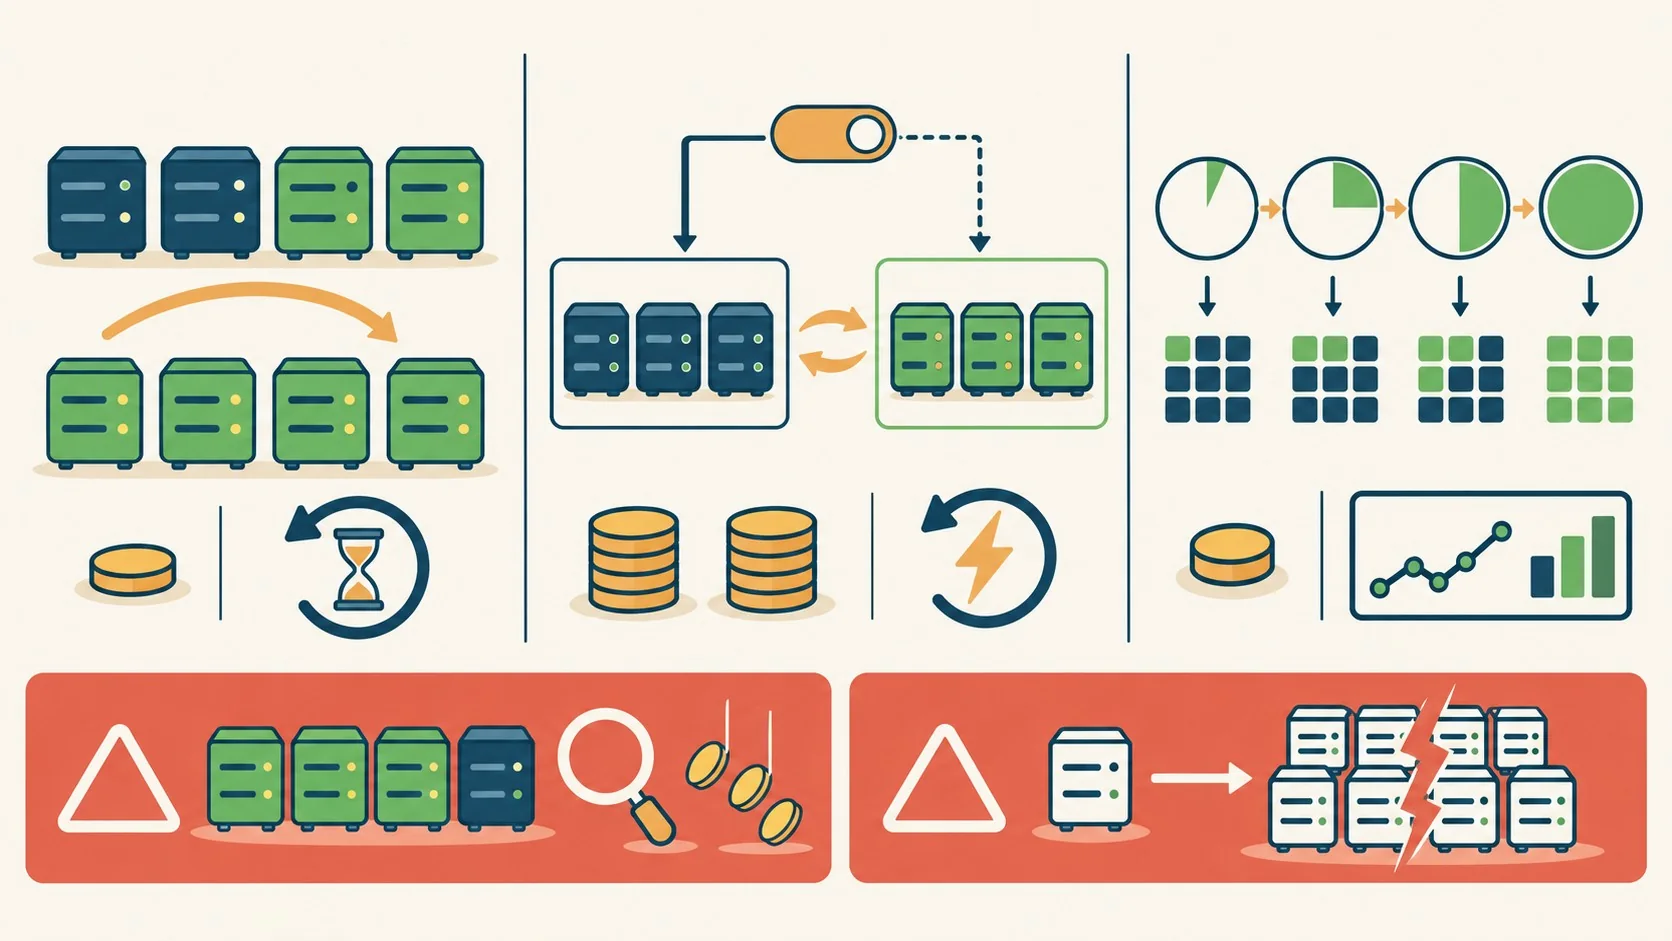
Las tres estrategias resuelven el mismo problema (llevar código nuevo a producción sin tirar el servicio) pero mueven el tráfico de formas distintas: rolling reemplaza instancias de a lotes, blue-green conmuta todo de una vez entre dos ambientes completos, y canary desplaza un porcentaje de tráfico real de manera gradual.
¿Qué es rolling deployment?
Rolling deployment es la estrategia que reemplaza las instancias viejas por la versión nueva en lotes chicos: se bajan unas pocas, se actualizan, se chequean y se devuelven a servicio, y así con el siguiente lote. Kubernetes la usa por default en sus Deployments, con parámetros como maxUnavailable y maxSurge para controlar cuántos pods pueden faltar o sobrar durante la actualización.
No necesita infraestructura extra, lo que la hace la opción más barata. El costo oculto es que vieja y nueva versión conviven mientras dura el rollout, así que esquemas de base de datos, APIs y flags tienen que funcionar con ambas versiones al mismo tiempo. Si eso no está garantizado, el rollout mismo se convierte en el bug, como pasó con Knight Capital.
¿Qué es blue-green deployment?
Blue-green deployment es mantener dos ambientes de producción idénticos, bautizados blue y green: uno sirve el tráfico real mientras el otro recibe la versión nueva y se testea, y recién ahí se conmuta el router o el load balancer para que todo el tráfico pase al ambiente actualizado de una sola vez. Volver atrás es simplemente switchear de nuevo, lo que lo hace la opción más rápida para deshacer un desastre.
El costo es literal: duplicás la infraestructura mientras dura la transición. Y hay un punto que suele subestimarse: si ambos ambientes comparten la misma base de datos (lo habitual), los cambios de esquema tienen que ser compatibles con las dos versiones del código al mismo tiempo, no solo con la nueva.
¿Qué es canary deployment?
Canary deployment es enviar una porción chica de tráfico real (entre 1% y 5%, típicamente) a la versión nueva, mirar las métricas de error y latencia, y ampliar el porcentaje solo si todo se ve sano. El nombre viene del canario en la mina de carbón. En Kubernetes, herramientas como Argo Rollouts o Flagger automatizan los pasos y los porcentajes, y servicios como AWS CodeDeploy ya traen presets de canary y linear traffic-shifting para algunos targets.
La trampa de canary no es técnica, es estadística: si ese 5% inicial de tráfico no representa bien a toda la base (por región, tipo de dispositivo o perfil de uso), un bug que afecta justamente a lo que el canary no cubrió puede pasar el filtro sin que nadie lo note hasta que se amplía el rollout.
Ejemplo hipotético: el mismo bug, tres destinos distintos
Este es un ejemplo hipotético, no un caso real, pensado solo para ilustrar cómo cambia el impacto según la estrategia elegida.
Imaginemos un equipo que gestiona 20 instancias de un servicio de pagos y despliega una versión con un bug que hace fallar un 10% de las transacciones bajo cierta condición de carga. El bug no se detecta en testing porque esa condición solo aparece con tráfico real.
- Con rolling (lotes de 2 instancias, sin chequeo de métricas de negocio): el bug viaja con cada lote. Si el equipo tarda 20 minutos en notar el patrón de fallas, para entonces ya pasó por 10 de las 20 instancias: la mitad de la capacidad está comprometida antes de frenar el rollout.
- Con blue-green (switch total, sin gate gradual): el bug no toca a nadie mientras dura el testing en el ambiente verde, pero en el segundo exacto del switch, el 100% del tráfico pasa a la versión con el bug. El rollback es instantáneo, pero el impacto, mientras duró, fue total.
- Con canary (arranque en 5%, métricas de error por transacción): el bug afecta a una fracción del 5% inicial. Si la alerta de error rate dispara en minutos, el tráfico se redirige antes de ampliar a 25% o 50%. El costo es tiempo: el rollout completo tarda más en cerrar.
La diferencia no está en qué estrategia “es mejor”, sino en qué variable cada equipo prioriza: rolling prioriza simplicidad y costo, blue-green prioriza velocidad de reversión, canary prioriza minimizar cuántos usuarios tocan un bug antes de detectarlo. Ningún ejemplo hipotético reemplaza la medición real, pero sirve para pensar qué pregunta hacerse antes de elegir.
¿Qué preguntas te tenés que hacer antes de elegir una estrategia?
En vez de buscar “la mejor” estrategia en abstracto, conviene responder estas cuatro preguntas para el servicio concreto que estás desplegando:
- ¿Tenés métricas de negocio en tiempo real, no solo de infraestructura? Si solo medís CPU y memoria, canary no te va a avisar de un bug que rompe transacciones pero no satura recursos. Sin esa observabilidad, rolling con chequeos simples es más honesto que un canary que da falsa seguridad.
- ¿Cuánto te cuesta tener infraestructura duplicada, aunque sea por horas? Si la respuesta es “no podemos”, blue-green queda afuera salvo para releases puntuales de alto riesgo, y el presupuesto define más que la preferencia técnica.
- ¿Tu base de datos y tus APIs soportan convivir con dos versiones del código al mismo tiempo? Esto aplica a rolling y canary por igual. Si la respuesta es no, hay que resolver eso primero (versionado de API, migraciones expand-then-contract) antes de elegir estrategia de despliegue.
- ¿Qué tan parejo es tu tráfico entre regiones, dispositivos o tipos de cliente? Si tu base de usuarios es muy heterogénea, un canary chico puede no representarla. Ahí conviene canary por anillos (empleados, luego un país, luego el resto) en vez de un porcentaje al azar.
Knight Capital falló en la pregunta 3: tenía código viejo y nuevo conviviendo sin que nadie lo supiera. CrowdStrike falló antes de llegar a la pregunta 1: ni siquiera había una etapa intermedia donde una métrica pudiera frenar algo.
¿Cuáles son los límites y riesgos de cada estrategia de despliegue?
Knight Capital es el riesgo de un rolling deployment manual sin verificación: versiones mixtas corriendo sin que nadie lo supiera, y un rollback que empeoró todo. CrowdStrike es el riesgo opuesto: no tener ninguna etapa intermedia, así que un error que hubiera afectado a un 5% de las máquinas terminó afectando al 100% en minutos.
- Rolling sin verificación real: si el chequeo de salud solo mira que el pod responda pero no que se comporte bien, el código con problemas igual termina copiado a todas las instancias.
- Blue-green sin gate gradual: el switch mueve a todos los usuarios de golpe, así que un bug que pasó el testing golpea al 100% de la base en el mismo segundo del cutover.
- Canary con muestra no representativa: un bug que solo afecta a cierta región, hardware o tipo de cliente puede esconderse en ese 5% inicial y aparecer recién cuando se amplía el rollout.
- Feature flags reciclados: Knight reutilizó un flag viejo para una funcionalidad nueva y dejó código muerto activo durante años. Un flag debería significar una sola cosa, y punto.
¿Alguna de las tres estrategias te salva solo por elegirla? No. La herramienta no reemplaza la disciplina de verificar antes de ampliar el alcance de un despliegue.
¿Cómo elegir la estrategia de despliegue correcta para tu equipo?
Una regla práctica que resume bastante bien el criterio de la industria: usá rolling como base para servicios stateless, sumá canary cuando tengas métricas confiables que te digan si una release está sana, y reservá blue-green para los releases de alto riesgo donde necesitás un fallback instantáneo. Tiene sentido porque cada estrategia cubre un hueco que las otras dos dejan abierto, según plantea la guía de Ciphemic Academia.
Hay un punto que Knight Capital enseñó por las malas: separar deploy de release. Deployar es poner código en los servidores. Lanzar es prenderlo para los usuarios. Los feature flags te permiten hacer lo primero sin lo segundo, pero si reciclás un flag viejo para una funcionalidad nueva, como hizo Knight, estás sentado sobre una bomba con temporizador desconocido.
Lo que sí tenés que automatizar, sea cual sea la estrategia que elijas, es la verificación de que la versión nueva corre de verdad en todos lados: subís el código, lo probás en local, funciona bárbaro, lo mandás a producción y de repente todo se rompe porque un servidor quedó con la versión vieja, nadie lo detectó a tiempo y el sistema siguió operando como si todo estuviera bien. Eso fue, literalmente, lo que pasó en el octavo servidor de Knight.
Errores comunes al elegir estrategia de despliegue
- Confundir deploy con release: pensar que subir código a producción es lo mismo que activarlo para todos los usuarios lleva a releases sin gate, como el switch de blue-green hecho sin testing previo.
- Dejar flags viejos sin borrar: el caso de Power Peg en Knight Capital pasó justamente por reutilizar un flag y dejar código muerto vivo en el sistema durante años.
- Medir solo infraestructura en un canary: si tu canary solo chequea CPU y memoria pero no mira error rate de negocio, una release rota puede pasar el filtro igual.
- No tener plan de rollback probado: Knight intentó frenar manualmente y empeoró todo revirtiendo mal; un rollback que nunca se ensayó no es un plan, es una apuesta.
Comparación: rolling vs blue-green vs canary deployment
| Característica | Rolling | Blue-green | Canary |
|---|---|---|---|
| Cómo mueve el tráfico | Instancia por instancia, en lotes | Todo de una vez, en el switch | Gradualmente, por porcentaje |
| Infraestructura extra | Poca | Un segundo ambiente completo | Chica, para la porción canary |
| Velocidad de rollback | Lenta (otro rollout) | Rápida (switch inverso) | Rápida (se corta el tráfico) |
| Daño si la release falla | Crece lote por lote | Todos, de golpe, salvo que haya gate | Mínimo al inicio, un pequeño % de usuarios |
| Caso de referencia | Knight Capital (2012) | Riesgo similar si el switch no se testea | CrowdStrike prometió esto tras 2024 |
Preguntas Frecuentes
¿Qué diferencia hay entre blue-green y canary deployment?
Blue-green conmuta el 100% del tráfico de una sola vez entre dos ambientes completos, mientras que canary mueve un porcentaje chico de tráfico (1% a 5% para arrancar) y lo va ampliando según las métricas. Blue-green te da un rollback instantáneo; canary te da el menor blast radius posible si algo sale mal.
¿Qué fue el incidente de CrowdStrike de 2024?
Fue la caída masiva del 19 de julio de 2024, cuando CrowdStrike envió una actualización de contenido defectuosa a todos los hosts Windows online entre las 04:09 y 05:27 UTC, sin staging previo. Unas 8,5 millones de máquinas terminaron en bucle de arranque o pantalla azul.
¿Qué pasó con Knight Capital en 2012?
El 1 de agosto de 2012, un despliegue manual mal verificado en ocho servidores activó una rutina muerta llamada Power Peg, que mandó más de 4 millones de órdenes al mercado en 45 minutos. La SEC calculó la pérdida en más de $460 millones.
¿Cuál es la mejor estrategia de despliegue para evitar downtime?
No hay una única “mejor”: rolling sirve como base para la mayoría de los servicios stateless, canary reduce el blast radius en servicios de alto tráfico con buena observabilidad, y blue-green conviene cuando necesitás un rollback instantáneo en releases riesgosos. Las tres necesitan verificación automatizada para funcionar bien.
¿Cómo funciona un rolling deployment en Kubernetes?
Kubernetes reemplaza los pods viejos por nuevos en lotes, controlado por maxUnavailable (cuántos pods pueden faltar) y maxSurge (cuántos extra se pueden crear durante el update). Un pod solo recibe tráfico una vez que su readiness probe confirma que está sano.
Conclusión
Knight Capital y CrowdStrike no fallaron por usar la estrategia “incorrecta”. Fallaron por saltarse la verificación que cada estrategia necesita para funcionar: Knight con un rolling a medio hacer y sin segunda revisión, CrowdStrike sin ninguna etapa intermedia. La elección entre rolling, blue-green y canary importa, pero importa más automatizar el chequeo de que la versión nueva corre de verdad en todos lados antes de ampliar el alcance. Si estás armando o revisando tu pipeline de despliegue, el criterio concreto es simple: definí qué significa “sano” para tu sistema, medilo con datos reales de producción, y recién después decidí si necesitás el fallback instantáneo de blue-green o el blast radius chico de canary.