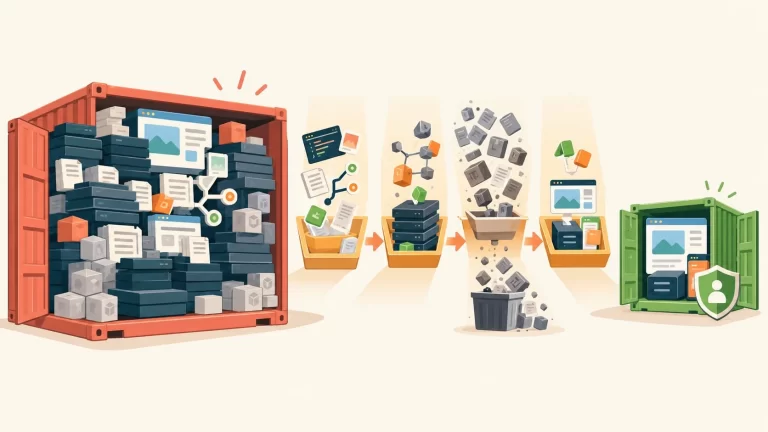
Cómo reducir el tamaño de una imagen Docker de 2GB
En pocas palabras: Para bajar una imagen Docker de 2GB a 150-250MB, usá un multi-stage build: una etapa compila con el toolchain completo y otra, basada en node:22-alpine, copia solo node_modules de producción y el build final. Con un binario estático compilado (Go, Rust) sobre scratch, la imagen puede quedar en 10-50MB.
Tu imagen Docker pesa 2GB, los pulls en producción se cuelgan y el escaneo de seguridad te tira cientos de hallazgos. La causa casi siempre es la misma: nadie separó lo que hace falta para compilar de lo que hace falta para correr. Un multi-stage build bien armado ataca exactamente eso, separando el stage de compilación del stage de runtime, y la imagen final baja a 150-250MB con Alpine, o a 10-50MB si tu lenguaje compila a binario estático, según los números que documenta DevOps Interview Mastery.
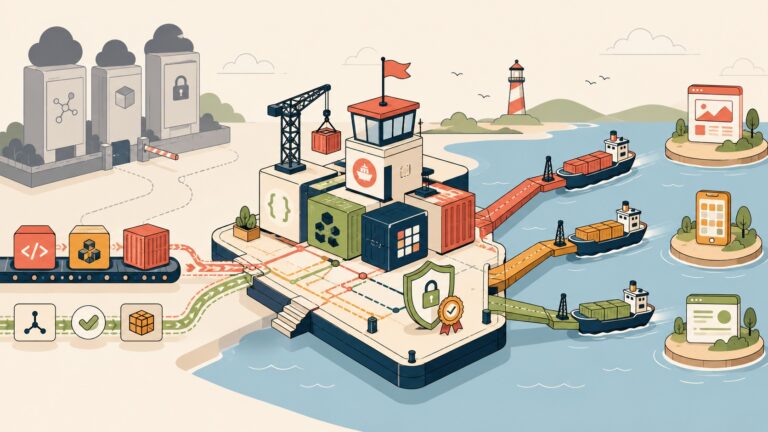
Un multi-stage build en Docker es una técnica que usa múltiples instrucciones FROM en un mismo Dockerfile, cada una con un propósito distinto: una etapa compila y empaqueta con el toolchain completo, y otra etapa, mínima, copia solo los artefactos finales para correr en producción. La documentación oficial de Docker la recomienda para todo tipo de aplicación, interpretada o compilada.
En este artículo:
- En 30 segundos
- ¿Por qué una imagen Docker termina pesando 2GB?
- ¿Cómo se estructura un multi-stage build correctamente para reducir el tamaño de la imagen Docker?
- ¿Cuál es el error más común al manejar dependencias en multi-stage builds?
- ¿Alpine, distroless o scratch: cuál elegir como imagen base?
- ¿Qué tamaño real se puede esperar después de optimizar una imagen Docker?
- ¿Qué beneficios trae esto además de ahorrar espacio en disco?
- ¿Qué otras prácticas complementan el multi-stage build?
- Errores comunes al optimizar imágenes Docker
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Una imagen Node.js típica con Debian completo, dev dependencies y código fuente sin filtrar pesa cerca de 2GB; el código de la app real son apenas 10MB.
- Con multi-stage build y runtime
node:22-alpine, la imagen final baja a 150-250MB sin comprimir, según los números de la guía de DevOps Interview Mastery. - Con binarios estáticos de Go o Rust sobre
scratcho distroless, el piso real es de 10 a 50MB. - El error clásico: usar
npm installen vez denpm ci, que muta el lockfile sin avisar. - Docker mismo documentó una reducción de 880MB a 428MB en un ejemplo con Spring Boot y Maven usando dos stages.
¿Por qué una imagen Docker termina pesando 2GB?
Porque alguien trató el contenedor como si fuera una máquina virtual completa, con todo lo necesario para desarrollar viviendo también en producción. Esa es la causa raíz, y la lógica detrás es simple si la pensás en capas: cada RUN y cada COPY en un Dockerfile de un solo stage queda grabado en la imagen final, para siempre, incluso si tres instrucciones después borrás el archivo que acabás de copiar. No existe “borrar de verdad” en un stage único; solo existe agregar capas nuevas arriba de las viejas.
Ponele que tenés un proyecto Node.js típico. La imagen base node sobre Debian ya pesa más de 1GB por sí sola. Encima le instalás node_modules con las dependencias de desarrollo adentro (webpack, jest, eslint viajando hasta producción, ninguno de los cuales ejecuta una línea en runtime). Copiás el árbol de código fuente completo, carpeta .git incluida. Y si algún módulo nativo necesitó compilar, probablemente dejaste instalado todo un toolchain de compiladores que nadie va a volver a usar. El resultado: tu aplicación real pesa 10MB y el resto es sobrepeso puro.
Ese sobrepeso no es solo un problema de disco. Cada paquete que metés es superficie de ataque nueva, cada CVE del toolchain aparece como hallazgo en tu escaneo de seguridad, y cada nodo sin las capas cacheadas tiene que descargar los 2GB enteros por la red.
¿Cómo se estructura un multi-stage build correctamente para reducir el tamaño de la imagen Docker?
Se usa un stage con el toolchain completo para compilar, y después se copian solo los artefactos terminados a un stage de runtime mínimo. El stage de build se descarta entero; solo el último stage termina viajando al registry. Cubrimos ese tema en detalle en nuestra guía de instalación de Docker Desktop, si todavía no tenés Docker instalado.
Para Node.js, el patrón que resuelve el problema de las dependencias de forma prolija necesita tres stages, no dos. La razón es casi de sentido común una vez que la ves escrita: compilar (correr TypeScript, bundlers) necesita las dev dependencies, pero el runtime final no puede llevarlas. Si hicieras todo en un solo stage de build, el node_modules que generás ahí tiene mezcladas las dependencias de producción con las de desarrollo, y no hay forma de separarlas después sin volver a instalar. Por eso se agrega un stage intermedio, deps, que solo corre npm ci --omit=dev y nunca ve el código de la app:
# Stage 1: build con el toolchain completo
FROM node:22-alpine AS builder
WORKDIR /app
COPY package*.json ./
RUN npm ci
COPY . .
RUN npm run build

# Stage 2: solo dependencias de producción
FROM node:22-alpine AS deps
WORKDIR /app
COPY package*.json ./
RUN npm ci --omit=dev

# Stage 3: runtime mínimo
FROM node:22-alpine AS runtime
WORKDIR /app
RUN addgroup -S app && adduser -S app -G app
COPY --from=deps /app/node_modules ./node_modules
COPY --from=builder /app/dist ./dist
COPY package.json ./
USER app
EXPOSE 3000
CMD ["node", "dist/server.js"]
El stage runtime final nunca ejecuta npm install ni npm ci: solo copia carpetas ya armadas desde los dos stages anteriores. Eso significa que ni TypeScript, ni webpack, ni el código fuente sin compilar llegan a esa imagen. Lo único que entra es exactamente lo que el proceso en producción necesita para arrancar.
Docker documenta el mismo principio con un ejemplo en Java: un stage builder con eclipse-temurin:21.0.8_9-jdk-jammy que compila con Maven, y un stage final con la imagen jre-jammy, mucho más liviana, que solo copia el .jar resultante. En ese caso puntual, la imagen bajó de 880MB a 428MB, según la guía oficial de Docker. Con dos stages (JDK para compilar, JRE para correr) alcanza porque Java no tiene el problema de dev dependencies mezcladas que sí tiene un proyecto Node con npm: el JAR que sale de Maven ya es un artefacto autocontenido, no una carpeta de dependencias que hay que depurar.
¿Cuál es el error más común al manejar dependencias en multi-stage builds?
Usar npm install en vez de npm ci. npm install puede modificar el lockfile sin que te enteres, mientras que npm ci instala exactamente lo que dice el lockfile y falla fuerte si hay drift, además de ser más rápido en CI.
El segundo error es más sutil, y es el que separa a alguien que entiende multi-stage de alguien que solo copió un ejemplo de internet: intentar hacer npm ci --omit=dev directo en el stage de build. No funciona, porque compilar casi siempre necesita las dev dependencies (TypeScript, bundlers) — si las omitís ahí, el npm run build falla. Y tampoco podés enviar a producción el node_modules de ese mismo stage de build, porque ahí adentro siguen viviendo esas mismas dependencias de desarrollo que no querés en el runtime final. El stage deps separado existe para eso: nunca toca el código fuente, solo instala producción desde el lockfile.
Un detalle chico pero que suma: copiá package*.json antes de COPY . .. Así Docker cachea la capa de dependencias y solo la reconstruye cuando cambia el lockfile, no en cada edición de código fuente. En nuestra guía sobre cómo automatizar la publicación de tus imágenes con GitHub Actions profundizamos sobre esto.
¿Alpine, distroless o scratch: cuál elegir como imagen base?
Depende de si necesitás debuggear interactivamente, de tu postura de seguridad, y de si tu binario es estático. No hay una respuesta única, pero sí un criterio que se puede aplicar caso por caso.
- Alpine (~5MB de base): trae shell y el gestor
apk, así que podés entrar y debuggear interactivamente. Ojo con esto: usa musl libc en vez de glibc, lo que rompe módulos nativos de vez en cuando. Si tu app depende de código nativo, probalo en Alpine antes de comprometerte. - Distroless (imágenes de Google): solo trae el runtime de tu lenguaje, certificados CA, tzdata, y nada más. Sin shell, sin gestor de paquetes, superficie de ataque reducida y escaneos de CVE mucho más silenciosos. Para debuggear usás
kubectl debugcon contenedores efímeros, o las variantes:debugque incluyen busybox. - Scratch: literalmente vacío. Solo sirve para binarios estáticos, y tenés que copiar los certificados CA a mano si tu app hace llamadas TLS. Es la opción más liviana y más segura cuando aplica.
Ejemplo hipotético: supongamos un equipo que mantiene una API en Node.js que usa sharp (procesamiento de imágenes con bindings nativos) y necesita, además, revisar logs dentro del contenedor cuando algo falla en staging. En ese escenario, saltar directo a distroless sería un error: si sharp no compiló bien contra musl libc, el único síntoma sería un crash en el arranque sin shell para entrar a investigar por qué. El camino más razonable sería: primero validar en Alpine que el módulo nativo funciona (aprovechando que tiene shell para debuggear si algo rompe), y recién después, con esa certeza, evaluar migrar a distroless para producción si la prioridad de seguridad lo justifica. Es un ejemplo ilustrativo, no un caso real reportado por ninguna de las fuentes, pero resume bien el orden de decisiones que conviene seguir.
La regla práctica que se desprende de esto: Alpine para lenguajes interpretados donde la ergonomía de debugging importa (sobre todo mientras todavía no confirmaste que tus dependencias nativas son compatibles con musl), distroless cuando la seguridad es la prioridad y ya validaste que la app corre sin sorpresas, scratch para binarios estáticos sin dependencias nativas que resolver.
¿Qué tamaño real se puede esperar después de optimizar una imagen Docker?
Una imagen Node.js optimizada con multi-stage y runtime Alpine queda entre 150 y 250MB sin comprimir. Un binario estático de Go o Rust sobre scratch baja a 10-50MB. La reducción real desde los 2GB iniciales supera el 90% en el caso de Node.js.
Acá hay que ser precisos, porque es donde muchos tutoriales exageran. Estos números son sin comprimir, lo que muestra docker images en tu máquina local. Los registries guardan las capas comprimidas, así que los números de Docker Hub aparecen entre dos y tres veces más chicos para la misma imagen. Comparar el número comprimido de un artículo contra el número sin comprimir de otro es, literalmente, cómo se inventan esas “imágenes Node de 50MB” que después nadie puede reproducir en su máquina. Te puede servir nuestra cobertura de la demo de Kubernetes de Google con microservicios.
| Enfoque | Tamaño realista (sin comprimir) |
|---|---|
Imagen completa node:22, dev deps, código fuente | ~2GB |
Multi-stage con runtime node:22-alpine | 150-250MB |
| Multi-stage con runtime Node distroless | similar, superficie algo más chica |
| Binario estático Go/Rust sobre scratch o distroless | 10-50MB |
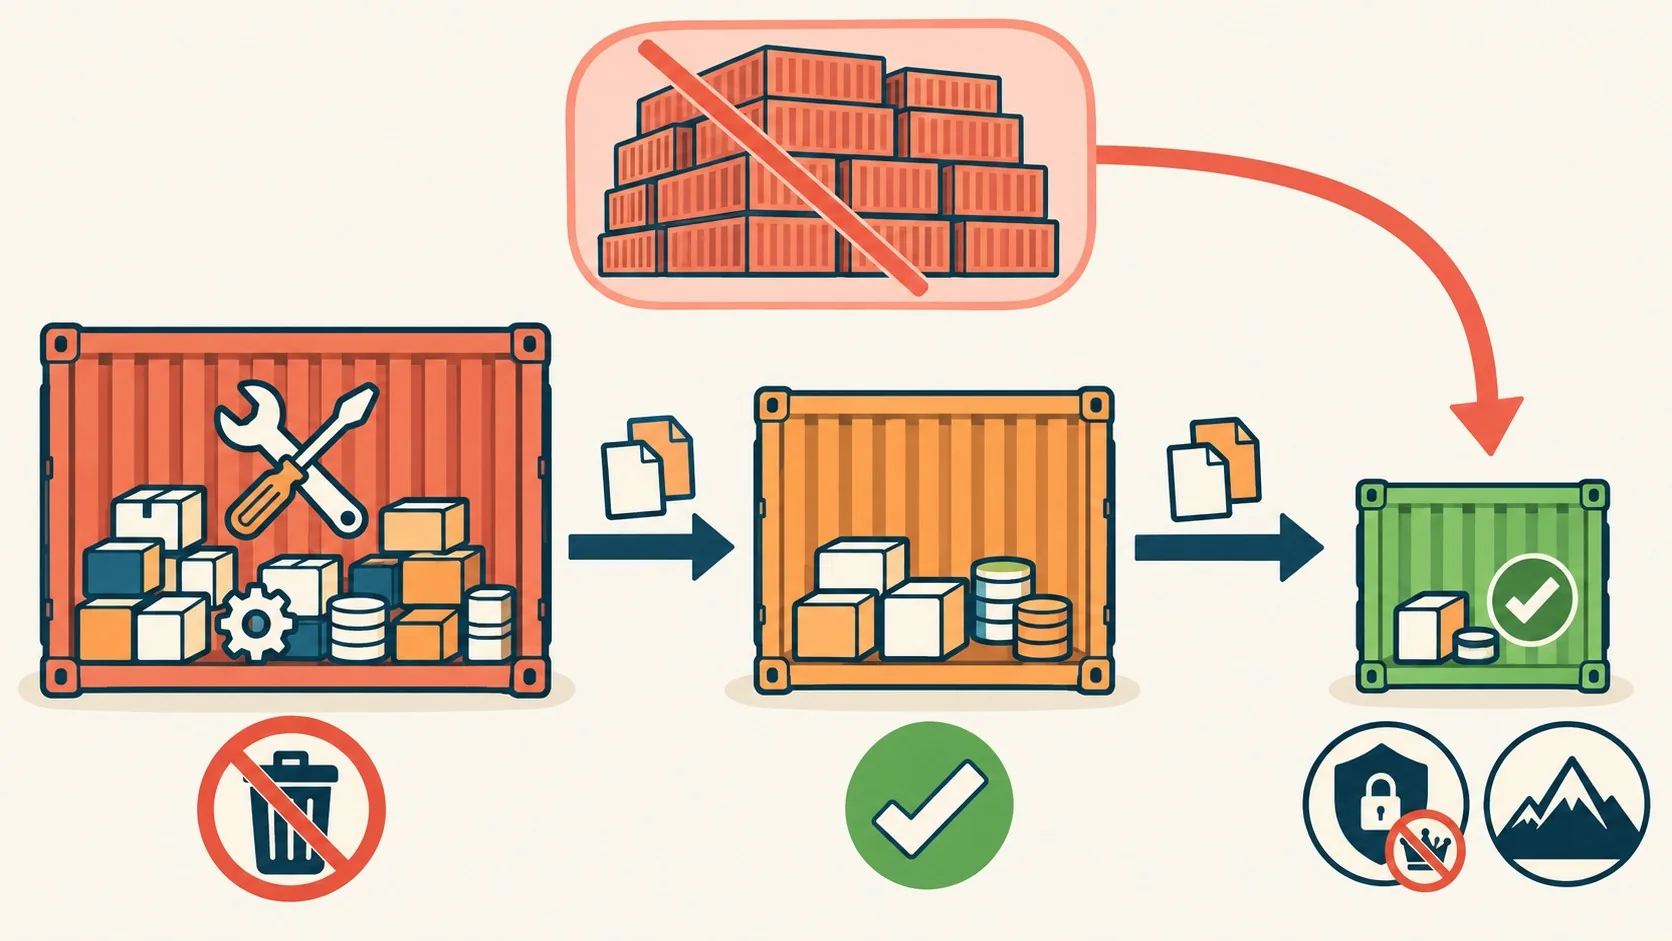
Una imagen Node.js toca piso cerca de 150MB porque el runtime solo, antes de que llegue tu código, ya pesa eso. Si de verdad necesitás la clase de los 50MB, la respuesta no es “optimizar más” el Dockerfile de Node: es cambiar de lenguaje a algo que compile a binario estático, donde el stage final puede ser directamente FROM scratch más los certificados CA.
¿Qué beneficios trae esto además de ahorrar espacio en disco?
Los pulls en frío bajan de minutos a segundos, lo que importa justo cuando más importa: eventos de autoescalado, reemplazo de nodos, recuperación ante desastre. Los reportes de CVE pasan de cientos de hallazgos a un puñado, porque los paquetes vulnerables simplemente ya no están. Y el costo de almacenamiento y egress del registry baja en proporción al tamaño de la imagen, en cada ambiente que guarda una copia.
Si alojás tus apps en infraestructura cloud, esto se siente directo en la factura: menos tamaño de imagen es menos transferencia de datos cada vez que un nodo nuevo hace pull. Para equipos que recién están armando su stack de contenedores sobre infraestructura propia, donweb.com ofrece servidores cloud donde este tipo de optimización rinde en costos reales, no solo en teoría.
¿Qué otras prácticas complementan el multi-stage build?
Un .dockerignore bien armado y herramientas como docker history o dive para auditar capas. Son detalles que parecen menores, pero sin ellos el multi-stage build pierde buena parte de su efecto.
- .dockerignore excluyendo
node_modules,.git, tests y documentación: mantiene chico el contexto de build y evita queCOPY . .arrastre basura a las capas. - docker history o la herramienta
dive: muestran exactamente qué instrucción generó cuántos megabytes, que es cómo encontrás esa capa accidental de 400MB. - Usuario no-root:
addgroupyaddusercuestan tres líneas y es de lo primero que marca cualquier revisión de seguridad. - Pin de versión por digest:
node:22-alpineya es mejor quenode:latest, pero un tag de versión sigue siendo mutable y puede traer parches nuevos sin avisar. Solo pinear por digest (node@sha256:...) hace que la base sea de verdad inmutable.
Errores comunes al optimizar imágenes Docker
Subís la imagen a producción, parece que anduvo bien en local, hacés el pull en un nodo nuevo y de repente el deploy tarda el triple porque nadie separó las capas de dependencias del código fuente y cada commit reconstruye todo desde cero. Relacionado: instalar un WAF en contenedores Docker.
- Copiar el código fuente antes que el package.json: rompe el cacheo de capas. Cada cambio de una línea en el código obliga a reinstalar todas las dependencias de nuevo.
- Elegir Alpine sin probar módulos nativos: musl libc no es glibc. Si tu app usa bindings nativos, probalo en Alpine antes de comprometerte, no después de que falle en producción.
- Comparar tamaños comprimidos contra sin comprimir: así nacen los benchmarks de “50MB” que nadie puede reproducir en su máquina.
- Dejar el toolchain de compilación en la imagen final: si instalaste
gccopython3-devpara un módulo nativo, asegurate de que viva solo en el stage de build, no en el runtime.
Preguntas Frecuentes
¿Qué es un multi-stage build en Docker?
Es una técnica de Docker que permite usar varias instrucciones FROM en un mismo Dockerfile, cada una con un propósito distinto: compilar en un stage con el toolchain completo y copiar solo los artefactos finales a un stage de runtime mínimo. El stage de build se descarta y nunca llega al registry.
¿Por qué mi imagen de Docker pesa 2GB?
Porque la imagen incluye cosas que no necesitás en producción: la base completa de Debian, dependencias de desarrollo como webpack o eslint, el código fuente con .git incluido, y a veces un toolchain de compilación entero para un solo módulo nativo. El código real de la aplicación suele pesar apenas 10MB.
¿Cuál es la diferencia entre Alpine y distroless?
Alpine trae shell y gestor de paquetes (apk), lo que permite debuggear interactivamente, pero usa musl libc en vez de glibc. Distroless, de Google, solo incluye el runtime y certificados, sin shell ni package manager, lo que reduce drásticamente la superficie de ataque y los hallazgos en escaneos de CVE.
¿Cómo evito que node_modules infle la imagen de Docker?
Separando las dependencias en un stage propio con npm ci --omit=dev y copiando solo ese node_modules de producción al stage final, nunca el del stage de build que todavía tiene las dev dependencies adentro.
¿Qué tamaño es normal para una imagen de Node.js en producción?
Entre 150 y 250MB sin comprimir con multi-stage build y runtime Alpine, según los números de la guía de DevOps Interview Mastery. El runtime de Node ya pesa eso antes de que llegue tu código, así que no esperes bajar de ahí salvo que migres a un lenguaje compilado con binario estático.
Conclusión
El cambio concreto es separar el stage que compila del stage que corre en producción, y copiar solo lo que el runtime necesita. Con eso, una imagen Node.js que pesaba 2GB baja a 150-250MB, y el ejemplo de Spring Boot que documenta Docker bajó de 880MB a 428MB con apenas dos stages.
Si estás arrancando, el paso práctico es simple: tomá tu Dockerfile actual, corré docker history para ver qué capa pesa más, y después decidí si tu caso pide Alpine, distroless o scratch. El orden importa más de lo que parece: primero validá que tu app corre sin sorpresas (con shell a mano si tenés dependencias nativas sin probar), y recién después endurecé la imagen según tu prioridad real de seguridad. No hay una sola respuesta correcta, pero sí un criterio para elegir sin adivinar.