Importar GitHub Actions a CI/CD: la letra chica
En pocas palabras: No queda listo: el importador de AngusGit genera un borrador donde pull_request pierde el filtro de types, runs-on: ubuntu-latest pasa a modo NATIVE con una etiqueta (no una máquina hosteada). El secret REPO_TOKEN hay que crearlo manualmente como credencial, o el job falla.
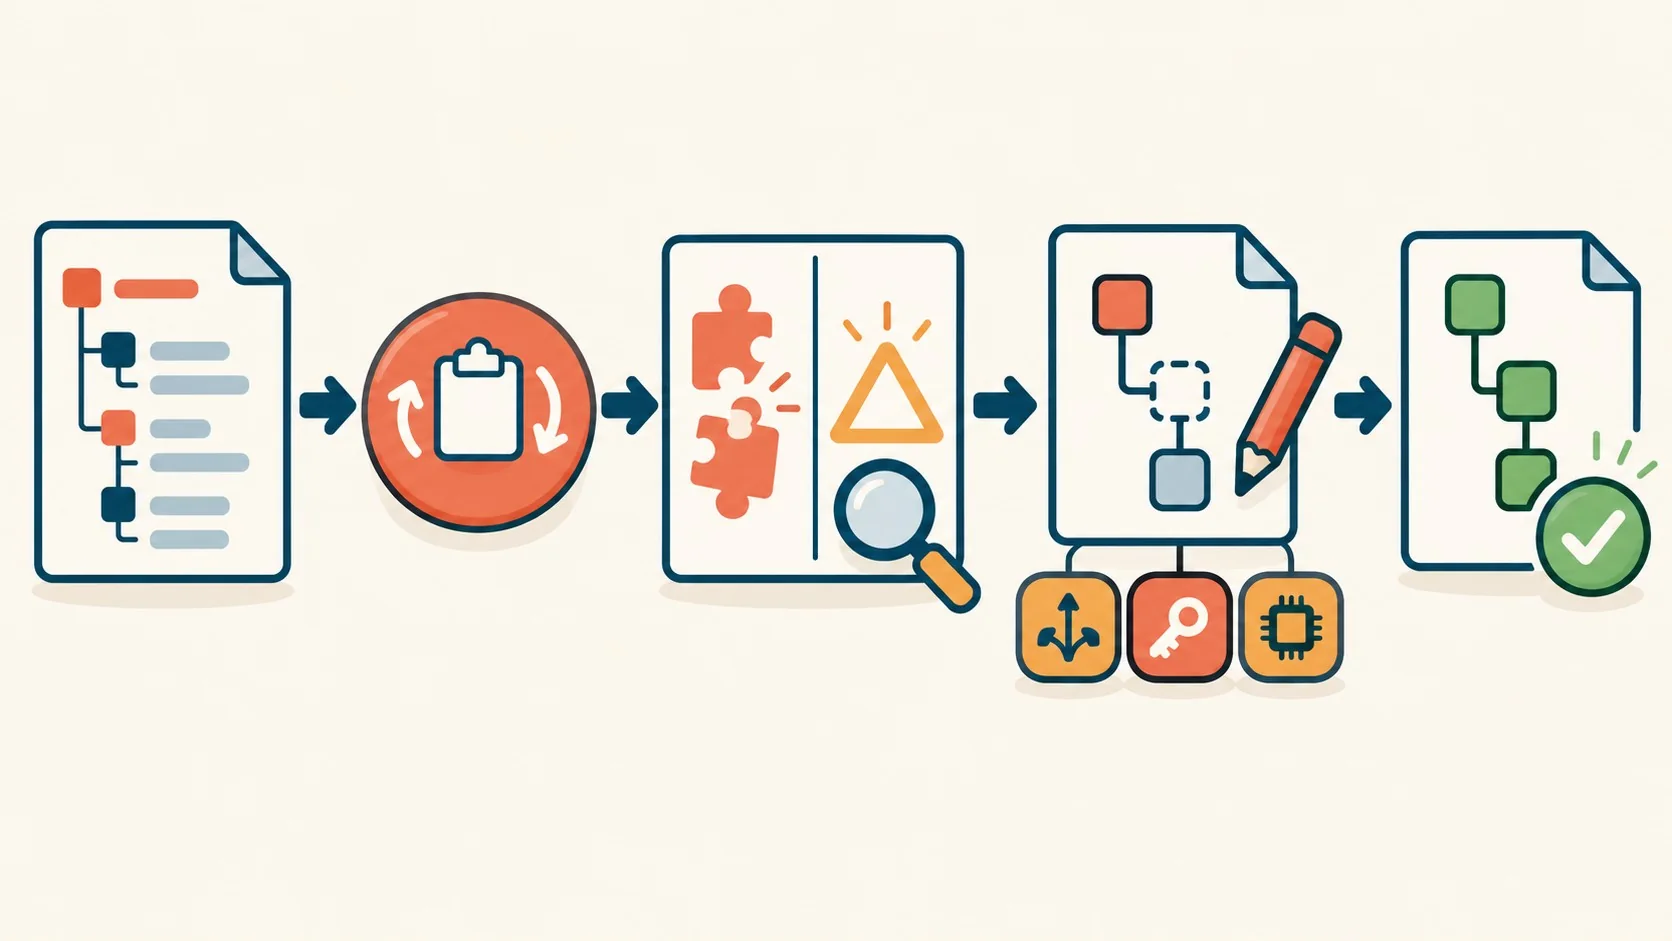
Pegás el workflow de GitHub Actions en el importador de AngusGit, apretás “Convertir” y lo que te devuelve es un borrador, no un pipeline listo para correr. El trigger pull_request pierde el filtro de types. runs-on: ubuntu-latest se convierte en modo NATIVE con una etiqueta igual al nombre, no en una máquina hosteada. El secret REPO_TOKEN no se crea solo: hay que darlo de alta como credencial aparte. Si guardás el YAML sin revisar esas tres cosas, el job se queda esperando runner o falla con “Credential not visible or expired”.
GitHub Actions es el sistema de CI/CD integrado en GitHub que ejecuta workflows definidos en archivos YAML dentro de .github/workflows/ cada vez que ocurre un evento en el repositorio, como un push o un pull request. Cuando vas a importar GitHub Actions a CI/CD de otra plataforma (en este caso AngusGit), el conversor traduce ese YAML a su propio formato, pero solo mapea un subconjunto de la sintaxis original. La trampa no está en lo que falla ruidosamente —eso al menos te avisa—, sino en lo que queda “medio traducido” y corre sin quejarse, hasta que alguien mergea algo que no debía pasar.
En este artículo:
- En 30 segundos
- ¿Qué entrega realmente el conversor: un pipeline listo o un borrador?
- ¿Cómo quedan los triggers push y pull_request después de convertir?
- ¿Por qué los secrets como REPO_TOKEN no se crean solos al importar?
- ¿Qué pasa con runs-on: ubuntu-latest y las acciones de Marketplace al convertir?
- Criterios para decidir qué revisar primero según el workflow
- ¿Qué errores aparecen si guardás el borrador sin corregirlo?
- ¿Cómo se adaptan los scripts que usan variables de contexto de GitHub?
- ¿Qué hacer si el repositorio tiene varios archivos de workflow?
- Errores comunes al importar GitHub Actions a CI/CD
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El importador de AngusGit convierte el workflow en un YAML borrador acompañado de dos listas: “no mapeado” y “atención”.
pull_requestpierde el filtro detypesy, si el original no teníabranches, el borrador tampoco limita rama destino.runs-on: ubuntu-latestpasa arunner.mode: NATIVEcon etiquetaubuntu-latest, no a una máquina hosteada por GitHub.secrets.REPO_TOKENse reescribe comoenv.REPO_TOKENen la listasecretsdel job, pero el valor hay que crearlo manualmente como credencial.- Acciones de terceros como
actions/setup-java@v4quedan en la lista “no mapeado” y no se instalan.
¿Qué entrega realmente el conversor: un pipeline listo o un borrador?
Entrega un borrador que todavía hay que corregir a mano. Después de pegar el workflow en el diálogo Importar GitHub Actions y apretar Convertir, AngusGit muestra el YAML resultante junto con dos listas: una de elementos “no mapeados” (cosas que simplemente no se tradujeron) y otra de “atención” (cosas que se tradujeron pero cambiaron de comportamiento).
El punto es que nada se guarda todavía. Si venís desde la lista de pipelines, el botón de abajo a la derecha dice Crear pipeline; si venís desde una página en blanco, dice Llenar en editor. En cualquiera de los dos casos, podés apretar Cancelar en cualquier momento y no queda nada creado en el repositorio. El menú del diálogo trae una advertencia chica, directa: “parte de la sintaxis se convierte automáticamente, validar después de importar”. Esa frase chica es la que la mayoría salta, y es justo la que importa.
Este flujo de CI/CD está disponible en los planes de equipo y empresa de AngusGit. La versión comunidad no tiene el menú de CI/CD, así que si trabajás con ese plan, directamente no vas a ver esta opción. Sobre eso hablamos en cómo se compara frente a otras herramientas de CI/CD.
¿Cómo quedan los triggers push y pull_request después de convertir?
push conserva el filtro de ramas tal cual estaba, pero pull_request pierde el filtro de types y, salvo que el original tuviera un branches explícito, no queda limitado a ninguna rama destino. Esa diferencia es la que más dolores de cabeza genera después, y no porque la herramienta esté “mal hecha”: es lo esperable cuando un conversor automático pasa de un modelo de eventos a otro que no tiene los mismos conceptos.
Con el workflow de ejemplo de la fuente, que dispara en push a main y en pull_request con types: [opened, synchronize], el resultado convertido queda así:
- push se mantiene igual: el borrador conserva
branches: [main]sin cambios. - pull_request pierde los types:
openedysynchronizevan a la lista “no mapeado” y desaparecen del YAML final. - pull_request_target se reescribe como pull_request: la lista de atención aclara que el modelo de permisos es distinto, así que no es un cambio neutro.
- release pasa a on: tag: si tenía
types, también quedan sin mapear. - schedule con cron se mantiene: se traduce a
on: schedulecon el mismocron, aunque el motor lo revisa cada 60 segundos aproximadamente, no al instante.
Hay un detalle que conviene tener presente: on: push solo responde a un git push real. Si en GitHub la práctica es mergear pull requests hacia main con el botón de merge, ese evento no dispara un push nuevo. La validación antes del merge, entonces, tiene que depender del trigger pull_request, no del push.
Ejemplo hipotético: imaginemos un equipo con un repo donde tres personas abren pull requests por día contra main. El workflow original en GitHub tenía pull_request: types: [opened, synchronize] sin branches, porque daba por sentado que cualquier PR en el repo iba contra main (es el único flujo que usan). Después de importar, el borrador queda con on: pull_request pelado, sin types ni branches. Mientras el repo siga teniendo una sola rama de destino para PRs, el comportamiento observable no cambia: sigue disparando en cada PR. El problema aparece el día que alguien abre una rama de release y empieza a mandar PRs contra esa rama también —ahí el pipeline se dispara igual, porque nada en el YAML lo está filtrando, y el equipo nota que están consumiendo minutos de runner en validaciones que no pedían. No es un bug: es una limitación que no se nota hasta que el patrón de trabajo cambia. Por eso conviene escribir branches explícito en el borrador aunque “no haga falta” todavía.
¿Por qué los secrets como REPO_TOKEN no se crean solos al importar?
Porque el conversor solo traduce la referencia al secret, no el valor. ${ secrets.REPO_TOKEN } se convierte en ${ env.REPO_TOKEN } y el nombre REPO_TOKEN queda anotado en la lista secrets del job, pero la credencial en sí hay que crearla a mano antes de correr el pipeline. Tiene sentido si lo pensás desde el lado de seguridad: ningún conversor decente debería poder copiar un secreto de una plataforma a otra sin que alguien con permisos lo autorice explícitamente.
El procedimiento es puntual: entrás a CI/CD → Configuración → Credenciales, apretás Nueva credencial, le ponés exactamente el mismo nombre que aparece en el workflow (en este caso REPO_TOKEN, y ese nombre no se puede editar después de creado), elegís tipo Credencial de texto, visibilidad Repositorio específico y pegás el valor del token. Una vez guardado, el valor en texto plano no se puede volver a ver. Complementá con si Jenkins sigue siendo una alternativa viable.
Si te saltás este paso, el job no tira un error genérico. Tira exactamente “Credential not visible or expired”, que es bastante claro una vez que sabés por qué pasa, pero confunde la primera vez que lo ves. Vale la aclaración: GITHUB_TOKEN, el token que GitHub genera automático en cada ejecución, no tiene equivalente nativo en AngusGit. Cualquier paso que dependa de él hay que reescribirlo con una credencial propia o eliminarlo del workflow.
¿Qué pasa con runs-on: ubuntu-latest y las acciones de Marketplace al convertir?
ubuntu-latest no se convierte en una máquina hosteada equivalente. El borrador lo traduce como runner.mode: NATIVE con una etiqueta llamada ubuntu-latest, lo cual significa que el job va a correr directamente sobre cualquier runner que tenga esa etiqueta puesta, sea cual sea el sistema operativo real de esa máquina. Es, básicamente, el conversor diciéndote “no sé qué máquina querías, pero te dejo el nombre anotado para que vos resuelvas”.
Si no existe ningún runner con esa etiqueta, el job no falla: se queda esperando indefinidamente. Para resolverlo hay que ir a CI/CD → Runners, crear uno nuevo, generar un token (válido una hora, visible una sola vez) e instalarlo vía Instalación Zip en una máquina de build, con la etiqueta ubuntu-latest puesta sin agregar docker (si agregás esa etiqueta, el runner pasa a modo contenedor y no toma esta tarea).
Las acciones de terceros tampoco se instalan. actions/setup-java@v4 queda en la lista “no mapeado” con la aclaración de que las Marketplace Actions o acciones remotas no se descargan automáticamente, así que JDK y Maven simplemente no están disponibles salvo que resuelvas ese paso con una imagen propia. En cambio, actions/checkout@v4 se omite directo: la plataforma ya hace un clone propio, aunque es superficial, con profundidad 1 y sin historial ni tags, algo que conviene tener en cuenta si algún script más adelante usa git describe --tags o necesita el historial completo.
Criterios para decidir qué revisar primero según el workflow
No todos los workflows necesitan la misma cantidad de curado después de importar. Un criterio simple, basado en lo que efectivamente cambia de comportamiento (no solo de sintaxis), para priorizar la revisión:
- Si el workflow dispara pasos de publicación o deploy: lo primero a revisar es el trigger y el condicional de ese paso, no el runner. Un
ifmal migrado puede publicar en una rama equivocada; un runner que no aparece simplemente te deja esperando y lo notás enseguida. - Si el workflow usa más de una acción de Marketplace: conviene resolver primero la imagen del runner (pasar a modo
DOCKERcon una imagen que ya tenga las herramientas) antes de tocar triggers o secrets, porque sin eso el pipeline ni siquiera llega a ejecutar los pasos. - Si el repositorio tiene varias ramas de trabajo activas (no solo
main): priorizar la revisión depull_requesty agregarbranchesexplícito, aunque el workflow original no lo tuviera, porque es justo el escenario donde la pérdida detypesy de filtro de rama se nota más rápido. - Si hay algún secret involucrado en cualquier paso: crear la credencial antes de intentar correr el pipeline, no después del primer fallo. El mensaje de error es claro, pero perder un ciclo de build solo para confirmar algo que ya se sabía de antemano no suma nada.
¿Qué errores aparecen si guardás el borrador sin corregirlo?
Los errores más comunes tienen un patrón: todos vienen de alguna de las tres diferencias ya mencionadas (triggers, secrets, runner). La siguiente tabla resume el síntoma, la causa real y la corrección puntual, tal como queda documentado en el proceso de conversión. Para más detalles técnicos, mirá por qué conviene evitar credenciales estáticas.
| Síntoma | Causa | Corrección |
|---|---|---|
| El job queda en cola para siempre | No hay runner con la etiqueta ubuntu-latest, o el modo es NATIVE y no hay máquina disponible | Crear runner con esa etiqueta, o cambiar a modo DOCKER con una imagen propia |
| “command not found” al buscar java | setup-java quedó en “no mapeado” y nunca se instaló | Usar una imagen de runner que ya incluya el JDK necesario |
| “Credential not visible or expired” | El secret figura en la lista secrets del job, pero no existe la credencial con ese nombre | Crear la credencial con el nombre exacto en CI/CD → Configuración → Credenciales |
| El paso de publish corre en ramas que no debía | El if del paso usa ref == ‘refs/heads/main’, pero ref ya devuelve solo el nombre de rama | Separar en un job propio y usar branch == ‘main’ a nivel job |
| git describe reporta que no encuentra tags | El checkout automático es superficial, profundidad 1, sin historial | Evitar lógica que dependa de tags o historial completo |
¿Cómo se adaptan los scripts que usan variables de contexto de GitHub?
Se adaptan reemplazando cada variable de contexto de GitHub por su equivalente en AngusGit, porque el runtime no inyecta el objeto github original. github.ref pasa a ref, pero con un cambio de valor importante: ya no devuelve refs/heads/main, devuelve directamente main. Es un cambio chico en apariencia, pero cualquier comparación de string hecha copiando y pegando del workflow original va a fallar silenciosamente si no se ajusta.
El resto de los mapeos sigue la misma lógica: github.sha se convierte en commitSha, github.event_name en event, y github.ref_name en branch. Si en el script queda alguna otra referencia a github.* que no entra en esta lista, el borrador la deja tal cual en el YAML, pero en runtime no se va a inyectar ningún valor para ella. Para scripts de build que necesitan datos del repositorio sin pasar por el contexto de job, las variables de entorno disponibles son GIT_REPO_URL, GIT_BRANCH y GIT_COMMIT_SHA.
¿Qué hacer si el repositorio tiene varios archivos de workflow?
Cada archivo se importa por separado y se convierte en un pipeline independiente. No existe una opción de “importar todo el directorio de una vez”: el flujo de conversión trabaja sobre un YAML a la vez, así que si tenés tres archivos en .github/workflows/, vas a repetir el proceso de pegar, convertir y revisar tres veces. Puede parecer tedioso, pero en la práctica es mejor que una importación masiva automática: cada workflow suele tener sus propias particularidades de triggers y secrets, y revisarlos juntos sin distinguir aumenta la chance de pasar algo por alto.
Una vez que cada pipeline corre bien por separado, conviene mover el YAML definitivo a la carpeta .anguscicd/ del repositorio (por ejemplo .anguscicd/ci.yaml), en vez de dejarlo solo guardado desde el editor. Mientras estés en etapa de prueba, basta con convertir sin crear el pipeline: así el repositorio queda intacto hasta que el YAML esté realmente listo. La carpeta .github/workflows/ original no hace falta borrarla; AngusGit no la ejecuta, y podés dejarla ahí hasta que confirmes que la migración funciona.
Errores comunes al importar GitHub Actions a CI/CD
- Crear el pipeline sin leer las dos listas: apretar “Crear pipeline” apenas aparece el YAML, sin revisar “no mapeado” ni “atención”, es la forma más rápida de terminar con un job roto en producción.
- Asumir que el token de GITHUB_TOKEN tiene equivalente: no existe una credencial automática equivalente en AngusGit; cualquier paso que use ese token hay que reescribirlo con una credencial propia.
- Dejar el filtro de if a nivel step en lugar de job: condiciones como
ref == 'refs/heads/main'en un step no leen el mismo contexto que a nivel job; conviene separar en jobs y usarbranch == 'main'. - Etiquetar el runner con “docker” por las dudas: eso cambia el modo del runner a contenedor y hace que no tome tareas en modo NATIVE que esperan esa etiqueta sin docker.
Preguntas Frecuentes
¿Qué es GitHub Actions?
GitHub Actions es el sistema de CI/CD integrado en GitHub que ejecuta workflows YAML guardados en .github/workflows/ cada vez que ocurre un evento en el repositorio, como un push o un pull request. No corre dentro de AngusGit ni de ninguna otra plataforma externa: los archivos de esa carpeta solo se ejecutan dentro de GitHub. Ya lo cubrimos antes en cómo se automatiza la publicación en Docker Hub.
¿Se puede importar un workflow de GitHub Actions y usarlo sin revisarlo?
No, porque el conversor solo traduce un subconjunto de la sintaxis y deja afuera elementos como los types de pull_request, el timeout a nivel job o las acciones de Marketplace. Guardar el YAML sin pasar por las listas “no mapeado” y “atención” suele terminar en jobs que quedan en cola o fallan por credenciales faltantes.
¿Cómo se migran los secrets de GitHub Actions a otra plataforma de CI/CD?
El conversor cambia la referencia de secrets.X a env.X dentro del YAML, pero el valor del secret no se transfiere automáticamente. Hay que crear una credencial nueva con el mismo nombre, tipo texto y visibilidad restringida al repositorio, en la sección de configuración de credenciales de la plataforma destino.
¿Por qué el job se queda esperando un runner después de importar el workflow?
Porque runs-on: ubuntu-latest se convierte en modo NATIVE con una etiqueta llamada ubuntu-latest, y si ningún runner tiene esa etiqueta configurada, la tarea queda en cola indefinidamente en vez de fallar con un error visible.
¿Qué pasa con runs-on: ubuntu-latest cuando se convierte un workflow de GitHub Actions?
No se convierte en una máquina hosteada equivalente a la de GitHub. Queda como una etiqueta de runner en modo NATIVE, así que el comportamiento real depende de qué sistema operativo tenga la máquina que efectivamente tome esa etiqueta.
Conclusión
Importar un workflow de GitHub Actions a otra plataforma de CI/CD te ahorra escribir el YAML desde cero, pero no te ahorra la revisión. Los tres puntos que siempre hay que chequear antes de crear el pipeline son los triggers (sobre todo pull_request, que pierde filtros), los secrets (que hay que dar de alta como credenciales aparte) y el runner (porque ubuntu-latest no es una máquina mágica, es una etiqueta que alguien tiene que atender). Si tu equipo está evaluando mover pipelines entre plataformas, conviene tratar la conversión automática como punto de partida, nunca como entrega final: un criterio simple es correr el pipeline importado en un entorno de prueba, mirar los logs del primer job completo y recién después mover el YAML definitivo a la carpeta de pipelines del repositorio. Y si el workflow tiene lógica de deploy o condiciones sensibles a la rama, la revisión de ese punto puntual vale más tiempo que repasar línea por línea todo lo demás.