Cómo leer un plan EXPLAIN de PostgreSQL sin errores
En pocas palabras: Para leer EXPLAIN en PostgreSQL hay que recorrer el árbol de nodos de hojas a raíz: cost, rows y width son estimaciones del planner (no mediciones). EXPLAIN ANALYZE ejecuta la consulta real y agrega tiempo, filas y loops reales, como muestra el ejemplo oficial con tenk1 (cost=0.00..445.00 rows=10000 width=244).
Leer un plan EXPLAIN en PostgreSQL se reduce a una idea central: recorrer el árbol de nodos desde las hojas (los scans) hacia la raíz, entendiendo que cost, rows y width son estimaciones del planner, no mediciones reales. EXPLAIN ANALYZE ejecuta la consulta de verdad y agrega tiempo real, filas reales y loops para contrastar esas estimaciones con lo que pasó de verdad.
EXPLAIN es el comando de PostgreSQL que muestra la estrategia elegida por el planner para resolver una consulta, representada como un árbol de nodos con costo estimado, filas estimadas y ancho de fila por cada paso. EXPLAIN ANALYZE, una variante del mismo comando, ejecuta la consulta real y agrega tiempo observado, filas reales y loops, según la documentación oficial de PostgreSQL.
En este artículo:
- En 30 segundos
- ¿Qué información muestra cada nodo de un plan EXPLAIN?
- ¿Qué significan cost, rows y width realmente?
- ¿Cuál es la diferencia entre EXPLAIN y EXPLAIN ANALYZE?
- ¿Cuándo un desajuste entre filas estimadas y reales es un problema real?
- ¿Cómo investigar un desajuste de filas paso a paso?
- ¿Qué limitaciones tiene un solo plan EXPLAIN?
- ¿Qué está confirmado y qué no en todo esto?
- ¿Cuáles son los errores más comunes al leer un plan EXPLAIN?
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- EXPLAIN muestra el plan sin ejecutar la consulta; EXPLAIN ANALYZE la ejecuta de verdad y puede modificar datos si es INSERT, UPDATE o DELETE.
- El ejemplo oficial
Seq Scan on tenk1 (cost=0.00..445.00 rows=10000 width=244)viene de una tabla de test con 345 páginas y 10.000 filas. - Los parámetros de costo son configurables: seq_page_cost vale 1.0 por defecto y random_page_cost vale 4.0 por defecto.
- GoCardless reportó una estimación de ~25.000 valores distintos de payout_id contra casi 3.5 millones reales, resuelto subiendo el statistics target a 5.000.
- Un mismatch entre filas estimadas y reales solo importa si el nodo corrió hasta el final, sin un Limit ni un loop que lo haya cortado antes.
¿Qué información muestra cada nodo de un plan EXPLAIN?
Cada nodo de un plan EXPLAIN representa un paso de recuperación o procesamiento, y muestra cuatro números: costo de arranque, costo total, filas estimadas y ancho de fila en bytes, según la documentación oficial de PostgreSQL. Si estás recién aprendiendo cómo leer explain postgresql, conviene arrancar con el ejemplo más simple posible.
Los scans están en las hojas del árbol. Joins, sorts y aggregates aparecen arriba. En el formato de texto, el resultado final queda en la línea de más arriba, las flechas -> marcan los nodos hijos, y Filter e Index Cond describen condiciones de un nodo, no nodos nuevos.
Ponele que corrés esto contra la tabla de test tenk1: Seq Scan on tenk1 (cost=0.00..445.00 rows=10000 width=244). Ahí tenés los cuatro campos: 0.00 de costo de arranque, 445.00 de costo total, 10.000 filas estimadas y 244 bytes de ancho promedio. Estos números vienen del ejemplo documentado de la base de test de PostgreSQL 18, no de una medición aparte.
Si corrés SELECT relpages, reltuples FROM pg_class WHERE relname = 'tenk1', vas a ver que tenk1 tiene 345 páginas de disco y 10.000 filas, y el costo sale de (páginas * seq_page_cost) + (filas * cpu_tuple_cost), es decir (345 * 1.0) + (10000 * 0.01) = 445. Para ver el árbol sin ejecutar nada, corré EXPLAIN solo, sin ANALYZE.
¿Qué significan cost, rows y width realmente?
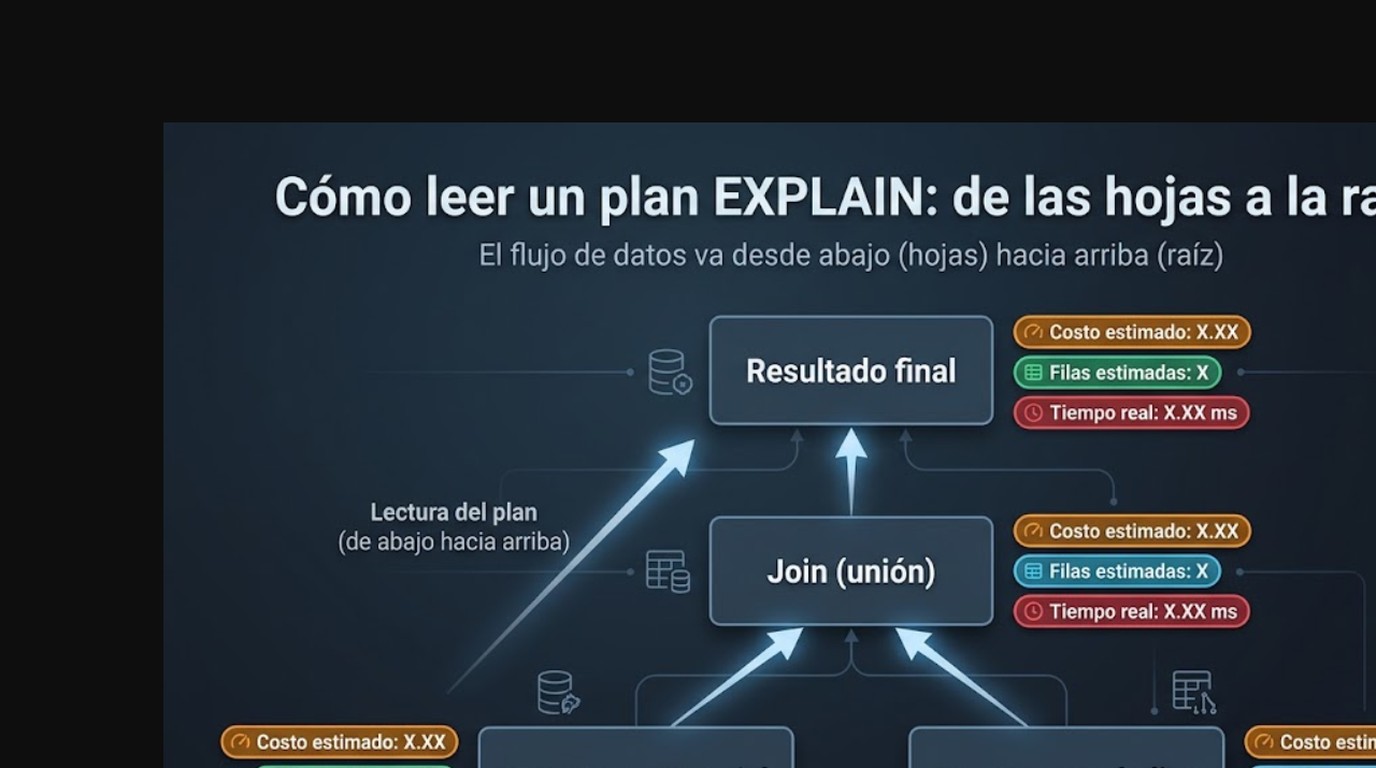
Cost, rows y width son predicciones del planner basadas en estadísticas, no mediciones de tiempo real, de I/O real ni del tamaño real del resultado. Esto se conecta con lo que analizamos en nuestra nota sobre cómo elegir el proveedor adecuado para tu base de datos.
El costo usa una escala configurable, con parámetros como seq_page_cost (1.0 por defecto) y random_page_cost (4.0 por defecto). El costo de un nodo superior incluye el de sus hijos, así que sumar los costos de toda una rama duplica trabajo que el planner ya contó una vez. Tomalo como una comparación interna bajo las mismas condiciones, no como milisegundos ni como un benchmark portable entre servidores, datasets o versiones de PostgreSQL.
Las estimaciones de filas y width dependen de estadísticas muestreadas. El planner usa los conteos de páginas y filas de pg_class, más la información de selectividad de pg_statistic. ANALYZE junta esos datos con un muestreo, así que la estimación sigue siendo aproximada incluso después de correr ANALYZE de nuevo.
¿Cómo pasás de la predicción a la observación real? Comparás el rows= estimado contra el actual rows de un plan con ANALYZE, y buscás dónde empiezan a divergir. Antes de asumir que la estimación está mal, revisá si el nodo terminó de ejecutarse o si hubo loops.
¿Cuál es la diferencia entre EXPLAIN y EXPLAIN ANALYZE?
La diferencia es que EXPLAIN solo muestra el plan sin ejecutar la consulta, mientras que EXPLAIN ANALYZE ejecuta la instrucción (statement) de verdad y agrega tiempo real (actual time), filas reales y loops al lado de las estimaciones originales, según la documentación oficial.
Cuando un nodo corre más de una vez (como el lado interno de un nested loop), el tiempo y las filas reportadas son promedios por ejecución. Multiplicás esos promedios por loops para calcular el tiempo y las filas acumuladas del nodo, no el tiempo total de la consulta completa.
Mirá este ejemplo documentado con LIMIT 2 sobre tenk1: el Index Scan hijo estima 10 filas si corriera hasta el final, pero el Limit padre lo corta después de conseguir 2. Te puede servir nuestra cobertura de los problemas comunes de hosting y dominio, además de nuestra guía de hosting.
Limit (cost=0.29..14.33 rows=2 width=244) (actual time=0.051..0.071 rows=2.00 loops=1)
-> Index Scan using tenk1_unique2 on tenk1 (cost=0.29..70.50 rows=10 width=244) (actual time=0.051..0.070 rows=2.00 loops=1)
PostgreSQL es explícito: esto no es un error de estimación. Antes de diagnosticar un mismatch de filas, fijate si un nodo padre como Limit cortó la ejecución del hijo antes de tiempo.
Ojo con esto. EXPLAIN ANALYZE ejecuta INSERT, UPDATE o DELETE con efectos secundarios reales. La documentación recomienda envolver todo en una transacción y hacer rollback, pero los valores de secuencia que avanzan con nextval no vuelven atrás después del rollback, y tampoco el consumo de recursos que ya se gastó. Si no sabés qué efectos tiene ejecutar la consulta, arrancá con EXPLAIN sin ANALYZE.
¿Cuándo un desajuste entre filas estimadas y reales es un problema real?
Un desajuste entre filas estimadas y reales solo importa si el nodo corrió hasta completarse, es decir, sin un Limit ni un loop temprano que lo haya cortado antes.
Predicados correlacionados, distribuciones sesgadas y estimaciones pobres de valores distintos pueden producir errores genuinos que un ANALYZE fresco por sí solo no arregla. Según el blog de ingeniería de GoCardless (última edición: septiembre de 2022), PostgreSQL estimó unos 25.000 valores distintos de payout_id, cuando los conteos aproximados del equipo indicaban casi 3.5 millones. Según el mismo relato, la estimación se estabilizó después de subir el statistics target a 5.000.
La versión de servidor, el hardware y el tipo de hosting no están establecidos en ese relato. Tomalo como un caso puntual, no como receta universal. El valor 5.000 no es un número mágico que funcione para cualquier tabla. Complementá con esta nota para entender mejor el panorama del cloud hosting actual.
¿Cómo investigar un desajuste de filas paso a paso?
Para investigar un mismatch de filas en un nodo que corrió hasta el final, el proceso documentado tiene cuatro pasos concretos.
- Establecé el contexto exacto de ejecución: el SQL literal, los parámetros usados y la versión de PostgreSQL.
- Encontrá dónde diverge la estimación de la realidad: comparando rows= estimado contra actual rows nodo por nodo.
- Revisá pg_stats para las columnas involucradas: most_common_vals, histogram_bounds y n_distinct te dicen qué sabe (o no sabe) el planner.
- Probá una corrección puntual y verificala en condiciones representativas: no te quedes con la conclusión de un solo plan sobre datos de prueba chicos.
¿Qué limitaciones tiene un solo plan EXPLAIN?
Un plan EXPLAIN muestra lo que el planner elegió, y con ANALYZE, lo que pasó en esa ejecución puntual. No establece por qué la consulta fue lenta ni si una corrección funciona en otros casos.
Una consulta literal que investigás a mano puede generar un plan distinto al de un prepared statement, que usa un plan genérico. Para ver el plan real de un prepared statement, usás EXPLAIN EXECUTE. PostgreSQL también advierte contra extrapolar resultados de datasets chicos a situaciones bastante distintas.
¿Sirve entonces un solo EXPLAIN para cerrar el caso? No. Tratalo como punto de partida de un diagnóstico, combinado con inspección de estadísticas, datos representativos y, para problemas intermitentes, logging con auto_explain bajo overhead controlado.
¿Qué está confirmado y qué no en todo esto?
Está confirmado por la documentación oficial que cost, rows y width son estimaciones del planner, y que EXPLAIN ANALYZE ejecuta la consulta con efectos reales. Lo que no está confirmado de forma general es que subir el statistics target a un valor específico resuelva cualquier mismatch de filas. Cubrimos ese tema en detalle en al momento de decidir entre hosting local o en la nube.
Confirmado: la estructura de árbol del plan, el significado de cada campo, el comportamiento de rollback con nextval y la recomendación de usar EXPLAIN EXECUTE para prepared statements. Todo esto surge de la documentación de PostgreSQL.
No confirmado de forma universal: el caso de GoCardless es un relato de blog de ingeniería, no un paper revisado ni un benchmark reproducible en distintas versiones de PostgreSQL. La versión usada en ese caso, el hardware y el proveedor de hosting no se especifican, así que el número 5.000 de statistics target es un dato puntual, no una regla general (spoiler: no hay un valor mágico que sirva para todas las tablas).
¿Cuáles son los errores más comunes al leer un plan EXPLAIN?
- Sumar los costos de cada nodo de una rama: el costo de un nodo superior ya incluye el de sus hijos, así que sumarlos todos duplica el conteo. Mirá solo el costo total del nodo raíz para comparar planes completos.
- Asumir que un mismatch de filas siempre es un bug: si el nodo tiene un Limit arriba o corre dentro de un loop, el desajuste es esperable y está documentado, no es un fallo de las estadísticas.
- Correr EXPLAIN ANALYZE sobre un UPDATE o DELETE en producción sin transacción: aunque hagas rollback después, los nextval ya avanzaron y el consumo de recursos ya pasó. Probá primero con EXPLAIN solo.
- Comparar costos entre dos servidores distintos como si fueran tiempos reales: el costo es una unidad arbitraria, no milisegundos, y depende de random_page_cost, seq_page_cost y la configuración local de cada instancia.
Preguntas Frecuentes
¿Qué significa cada campo del EXPLAIN en PostgreSQL?
Cada nodo muestra cuatro campos: costo de arranque, costo total si el nodo corre hasta el final, filas estimadas y ancho promedio de fila en bytes. Estos cuatro números aparecen siempre, haya o no ANALYZE, y vienen de las estadísticas que PostgreSQL guarda en pg_class y pg_statistic.
¿Cuál es la diferencia entre EXPLAIN y EXPLAIN ANALYZE?
EXPLAIN muestra el plan elegido por el planner sin ejecutar la consulta, mientras que EXPLAIN ANALYZE la ejecuta de verdad y agrega tiempo real, filas reales y loops. Usar ANALYZE implica correr la consulta con todos sus efectos secundarios, incluyendo cambios de datos si es un INSERT, UPDATE o DELETE.
¿Por qué el número de filas estimado no coincide con el real?
Puede ser porque el planner trabaja con estadísticas muestreadas, no con conteos exactos, o porque un nodo padre como Limit cortó la ejecución antes de que el hijo terminara. Antes de sospechar de las estadísticas, confirmá si el nodo corrió hasta el final o si hubo loops de por medio.
¿EXPLAIN ANALYZE modifica datos en la base?
Sí, si la consulta es un INSERT, UPDATE o DELETE, porque EXPLAIN ANALYZE ejecuta la statement real con sus efectos reales. Incluso un SELECT puede tener efectos si llama funciones como nextval, y esos avances de secuencia no se revierten con un rollback.
¿Cómo saber si una query es lenta leyendo el plan de ejecución?
Corré EXPLAIN ANALYZE y fijate en el actual time de cada nodo, no en el cost estimado, porque el cost es una unidad arbitraria y el actual time está en milisegundos reales. Buscá el nodo con mayor tiempo acumulado, multiplicando actual time por loops, para encontrar el cuello de botella real.
Conclusión
Leer un plan EXPLAIN no es magia ni requiere memorizar cada tipo de nodo: es entender que cost, rows y width son predicciones, y que EXPLAIN ANALYZE te da la foto real de lo que pasó en una ejecución puntual. El cambio de hábito más útil es dejar de asumir que un mismatch de filas es automáticamente un error de las estadísticas antes de revisar si hubo un Limit o un loop de por medio.
Para el día a día, el criterio práctico es simple: empezá con EXPLAIN plano cuando no sepas qué efectos tiene la consulta, subí a EXPLAIN ANALYZE cuando necesites tiempos reales, y si el mismatch persiste en un nodo que corrió completo, mirá pg_stats antes de tocar nada. Si administrás una base de Postgres en producción, sea en un VPS propio o en un servidor dedicado como los de donweb.com, el mismo proceso de diagnóstico aplica sin importar quién te hostee la infraestructura.
El caso de GoCardless sirve como recordatorio: un ANALYZE fresco no siempre resuelve el problema, y a veces hay que tocar parámetros de estadísticas específicos para esa tabla. Eso sí, probá en condiciones representativas.
Fuentes
- PostgreSQL Documentation – 14.1. Using EXPLAIN
- Dev.to – How to read PostgreSQL EXPLAIN output
- Blog de ingeniería de GoCardless sobre estadísticas de PostgreSQL