Apagones de noviembre 2026: qué falló en cada servicio
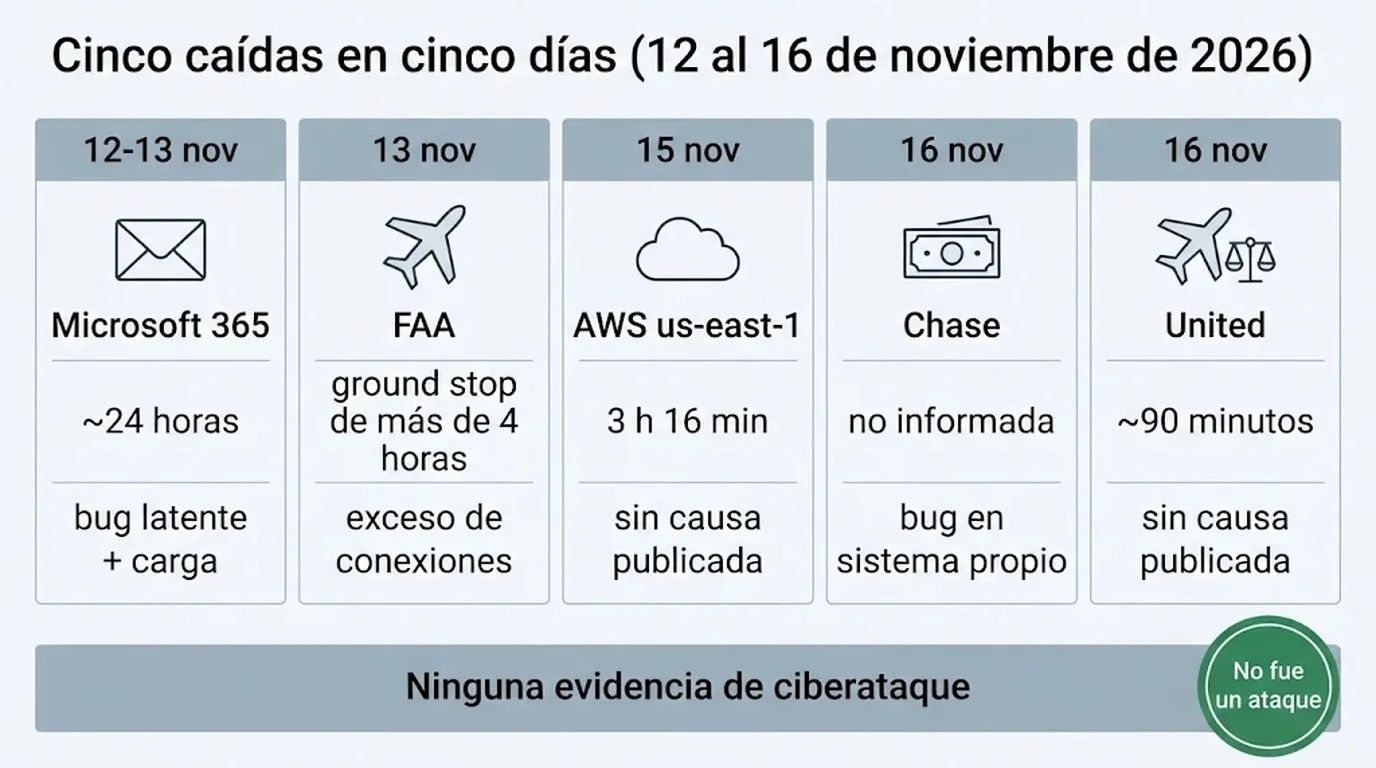
Entre el 12 y el 16 de noviembre de 2026 se cayeron Microsoft 365, la red de control de tráfico aéreo de la FAA, la región us-east-1 de AWS, los sistemas de Chase y un sistema del que dependían las salidas de United Airlines. Fueron cinco incidentes en cinco días, cada uno con una causa distinta o todavía sin publicar, y ninguno quedó vinculado a un ciberataque ni a otro de la misma semana.
La coincidencia fue el calendario. Lo que sí comparten, en los casos donde la empresa publicó cómo falló, es el mecanismo: un componente muy compartido —un gateway de red, un router, un balanceador, un sistema on-premise— convirtió una falla local en una caída amplia. Esa parte se puede revisar en cualquier infraestructura sin esperar el informe final de nadie.
En este artículo:
- ¿Qué es la ola de apagones tecnológicos de noviembre de 2026?
- ¿Qué pasó con la caída de Microsoft 365 en noviembre de 2026?
- ¿Por qué se cayó el sistema de la FAA y cuántos vuelos se cancelaron?
- ¿Qué falló en AWS us-east-1 el 15 de noviembre?
- ¿Qué falló en Chase y United el 16 de noviembre?
- ¿La ola de apagones de noviembre de 2026 fue un ciberataque?
- Qué revisar en tu propia infraestructura antes de la próxima caída
- Fuentes consultadas
¿Qué es la ola de apagones tecnológicos de noviembre de 2026?
Fue una sucesión de incidentes independientes entre el 12 y el 16 de noviembre de 2026 que afectó servicios muy visibles: correo corporativo, control de tráfico aéreo, una región de nube, banca y una aerolínea. No hubo un origen común. Cada organización informó una causa diferente o todavía no publicó ninguna, y la ola fue más amplia que esos cinco nombres: también hubo interrupciones en Apple, en sistemas internos de la NSA y en otros bancos.
| Fecha | Qué falló | Duración | Causa informada | ¿Ciberataque? |
|---|---|---|---|---|
| 12 al 13/11 | Microsoft 365: Exchange Online, Outlook, Teams, SharePoint, Copilot, Defender for Office 365, Intune | Casi 24 horas (11:20 AM ET del 12 a 11:10 AM ET del 13) | Defecto latente de una actualización de julio de 2026 en servidores gateway, agravado por sobrecarga y capacidad fuera de línea | Microsoft: no |
| 13/11 | Ground stop nacional de la FAA, con inestabilidad en 17 de las 22 Air Route Traffic Control Centers | Casi 5 horas (anuncio 3:36 PM ET, reanudación cerca de las 8:15 PM ET) | Exceso de intentos de conexión desde dos sitios; causa raíz en investigación | Seguridad Nacional: sin indicios |
| 15/11 | AWS us-east-1: errores de conectividad e inicio de sesión en 11 servicios, incluido IAM Identity Center y un subconjunto de Network Load Balancers en use1-az1 | 3 horas 16 minutos (3:05 a 6:21 AM PST) | AWS no publicó causa raíz | Los reportes de AWS no lo mencionan |
| 16/11 | Chase | No informada públicamente | Bug de software en un sistema on-premise | Chase: no |
| 16/11 | United Airlines: sistema del que dependían las salidas | Unos 90 minutos de demoras en salidas | No declarada; el sindicato de pilotos apuntó al sistema de peso y balance | United: sin indicios |
¿Qué pasó con la caída de Microsoft 365 en noviembre de 2026?
Exchange Online y Outlook dejaron de responder durante casi 24 horas, entre las 11:20 AM ET del 12 de noviembre y las 11:10 AM ET del 13, y arrastraron a Teams, SharePoint Online, Microsoft 365 Copilot, Defender for Office 365 e Intune, además de servicios de terceros que dependen de Exchange. Microsoft lo atribuyó a un problema técnico, «no relacionado con ciberataques ni con IA o agentes».
El informe preliminar, publicado el 15 de noviembre, describe tres factores que se combinaron:
- Un defecto latente en una actualización de julio de 2026 de los servidores gateway de la red de Microsoft 365.
- Unas 15 horas antes de la caída, Teams había migrado al gateway que usa Exchange Online, sumando carga sobre ese componente.
- Casi el 14% de la capacidad de gateway ya estaba fuera de línea por una falla previa.
El defecto se manifestó como contención de locks: se agotaron CPU y memoria, más del 80% de los servidores gateway quedó sin responder y el tráfico redirigido automáticamente golpeó a otros gateways, que fallaron igual. Exchange Online no pudo hacer failover a otra infraestructura por razones de escala, los reinicios no sostuvieron la recuperación y el rollback no era posible porque el cambio tenía meses. La salida fue desplegar una actualización que revirtió el código defectuoso. El informe final estaba previsto para el 20 de noviembre; al cierre de esta nota no había sido publicado.
¿Sigue caído Microsoft 365 o ya se restableció el servicio?
El servicio se restableció el 13 de noviembre a las 11:10 AM ET, cuando Microsoft completó la reversión del código defectuoso. Desde entonces no se reportaron eventos activos en Azure status ni impacto confirmado en cargas de trabajo de clientes de Azure. Lo que falta es el informe definitivo, previsto para el 20 de noviembre, con el detalle técnico completo del incidente.
¿Por qué se cayó el sistema de la FAA y cuántos vuelos se cancelaron?
El 13 de noviembre la FAA emitió un ground stop nacional, el segundo de ese tipo desde el 11 de septiembre de 2001. La red quedó inestable en 17 de las 22 Air Route Traffic Control Centers por un exceso de tráfico de conexiones —unos 1.000 intentos cada cuatro o cinco segundos— originado en dos sitios: el radio de El Dorado, Arkansas, donde se había instalado un router nuevo durante el reemplazo de cobre por fibra, y el radar de Amarillo, Texas.
Sobre cuántos vuelos se cancelaron, las fuentes consultadas no publican una cifra consolidada atribuible al ground stop. Lo que sí está documentado: había cerca de 3.500 aeronaves ya en vuelo cuando se detuvieron las salidas, el tráfico se reanudó alrededor de las 8:15 PM ET y las demoras y cancelaciones se extendieron durante el fin de semana.
L3Harris bloqueó los dos sitios de origen y la red se estabilizó. La FAA desactivó la misma función en más de 60 routers Juniper y pausó la instalación de esos equipos; HPE, dueño de Juniper, sostiene que el dispositivo funcionó como estaba configurado. La causa raíz sigue en investigación y Seguridad Nacional dijo que no había indicios de ciberataque.
¿Qué falló en AWS us-east-1 el 15 de noviembre?
Entre las 3:05 y las 6:21 AM PST, la región de Virginia del Norte registró errores de conectividad e inicio de sesión en 11 servicios, entre ellos IAM Identity Center y un subconjunto de Network Load Balancers en una celda de use1-az1. La autenticación quedó mitigada a las 5:20 AM PST y los balanceadores fueron la última pieza en recuperarse. AWS no publicó causa raíz.
La recomendación que dejó AWS para quienes tuvieron balanceadores afectados fue crear uno nuevo con destinos en varias Availability Zones. Como referencia de magnitud, un recuento de incidentes mayores de AWS, Azure, Google Cloud y Cloudflare desde enero de 2020 —63 casos, mediana de 5 horas 57 minutos— ubica a este evento por debajo de la mediana, y señala que un 32% de esas caídas se originó en un cambio de configuración o despliegue. Te puede servir nuestra cobertura, donde comparamos Microsoft y GitHub en detalle.
¿Qué falló en Chase y United el 16 de noviembre?
Chase atribuyó su interrupción a un bug de software en un sistema de hardware on-premise y aclaró que «no está relacionado con un incidente de ciberseguridad». El episodio afectó el procesamiento de transacciones y tuvo efecto dominó en clientes de otros bancos, incluidos pagos por Zelle; el operador de Zelle dijo que su red estaba plenamente operativa. United, en tanto, sufrió demoras de salida de unos 90 minutos por un problema en un sistema tecnológico del que dependían los despegues, sin impacto en vuelos en curso. No declaró causa; el sindicato de pilotos apuntó al sistema de peso y balance.
¿La ola de apagones de noviembre de 2026 fue un ciberataque?
No hay evidencia de ciberataque. Microsoft, Seguridad Nacional, Chase y United descartaron una causa ciber o dijeron que no había indicios, y los reportes de AWS no la mencionan. El 18 de noviembre, el secretario de Seguridad Nacional Markwayne Mullin, el director de Inteligencia Nacional Jay Clayton y el subdirector del FBI Christopher Raia dijeron ante el comité de Seguridad Nacional de la Cámara que las caídas no fueron maliciosas. El secretario de Estado Marco Rubio fue explícito: «No estamos bajo un ataque sistémico».
Los rumores más difundidos tampoco resisten el contraste con los datos publicados:
- Ataque coordinado: las causas informadas son distintas entre sí —un defecto de software en gateways, tráfico excesivo desde dos sitios de red, un bug en hardware on-premise— y dos empresas aún no publicaron causa.
- «Apagón de 90 días desde el 17 de noviembre»: fue un bulo montado sobre la prueba rutinaria del Emergency Alert System, que se emitió a las 2:20 PM ET y duró cerca de un minuto en TV y radio.
- Tormenta solar: los datos de la NOAA mostraban condiciones tranquilas en esos días.
- Eventos conectados entre sí: no hay evidencia publicada que vincule dos de estos incidentes.
Hay un matiz que sí es real y conviene no mezclar: el ransomware contra hospitales y universidades estaba elevado en el mismo período y CISA sumó más vulnerabilidades explotadas que lo habitual en septiembre y octubre. Nada de eso está ligado a estas caídas. Tratarlo como la causa apuntaría a los equipos hacia el problema equivocado. Ya lo cubrimos antes en evitar caídas con DNS autoritativos bien configurados.
La capa de la IA merece una aclaración, porque circuló como explicación y como sospecha a la vez. Según David Agranovich, exdirector de inteligencia del Consejo de Seguridad Nacional en la primera administración Trump, las herramientas de IA están detectando vulnerabilidades a un ritmo enorme, y las organizaciones parchean a las apuradas infraestructuras heredadas cuyas dependencias son difíciles de prever. El senador Mark Warner planteó algo similar: la IA acelera el descubrimiento de fallas y presiona para parchear todo junto. Eso afecta la confiabilidad, pero no convierte ninguna de estas caídas en un ataque.
Como criterio de verificación —propuesta editorial, no conclusión de las fuentes—, ante un rumor de ataque masivo conviene hacer dos búsquedas: el comunicado del operador afectado y el del organismo oficial del país. Si las causas publicadas son diferentes entre sí y ninguna menciona actividad maliciosa, la hipótesis del ataque coordinado pierde sustento. Si aparece una fuente que sí lo afirma, hay que verificar si es primaria o si cita a otra que tampoco lo es.
Qué revisar en tu propia infraestructura antes de la próxima caída
El patrón se repite en industrias distintas: un componente compartido transforma una falla local en una caída amplia. Lo accionable no es adivinar el próximo origen, sino limitar hasta dónde puede propagarse una falla.
- Listá las dependencias únicas: balanceador, proveedor de identidad, base de datos, segmento de red. Cada camino crítico necesita al menos dos formas independientes de funcionar.
- Corré activo-activo con tráfico real. Una región standby que nunca sirvió producción es un failover sin probar.
- Distribuí los destinos de los balanceadores entre Availability Zones, tal como recomendó AWS después del 15 de noviembre.
- Ensayá el failover con la capacidad ya degradada, no en el mejor escenario. El caso de Microsoft muestra qué pasa cuando el reruteo llega a servidores que están al límite.
- Mantené un acceso break-glass que no dependa de la misma región ni del mismo proveedor de identidad que tus sistemas principales.
- Alojá la status page y las alertas en infraestructura separada de lo que monitorean, para que el equipo pueda comunicar mientras arregla.
Y hay una parte que suele quedar afuera del plan: la recuperación no termina cuando el servicio vuelve. Quedan correos en cola, pagos y registros de fichaje sin conciliar, aviones y tripulaciones fuera de posición. Presupuestar ese tramo es parte del diseño, no un detalle posterior.
Si tu equipo necesita levantar una status page en infraestructura separada o un entorno de pruebas con tráfico propio, en Donweb podés contratar hosting y dominios para ese tipo de despliegue desde Argentina, sin sumar la dependencia al mismo proveedor que estás tratando de monitorear.
Fuentes consultadas
- Control Plane, «The November 2026 Outage Wave, Explained» (19/11/2026)
- Foreign Policy, «The U.S. Tech Outage Wave, Explained» (18/11/2026)
- BBC Mundo, «Ataques informáticos, IA o actualizaciones pendientes: qué hay detrás de la ola de problemas tecnológicos» (18/11/2026)
- AP, cobertura de los fallos tecnológicos y los vuelos demorados
- NBC News, cobertura de la semana de caídas
- DRJ, lecciones de los incidentes de la FAA y Microsoft 365