Azure Maia 300: qué prometió Microsoft y qué falta probar
En pocas palabras: Microsoft presentó Azure Maia 300, su acelerador de IA propio para inferencia, y lo desplegará en racks de 96 chips a escala multi-gigavatio desde 2027. Promete hasta 7 veces el throughput de tokens de Maia 200 y 40% más tokens por megavatio que sistemas basados en GPU.
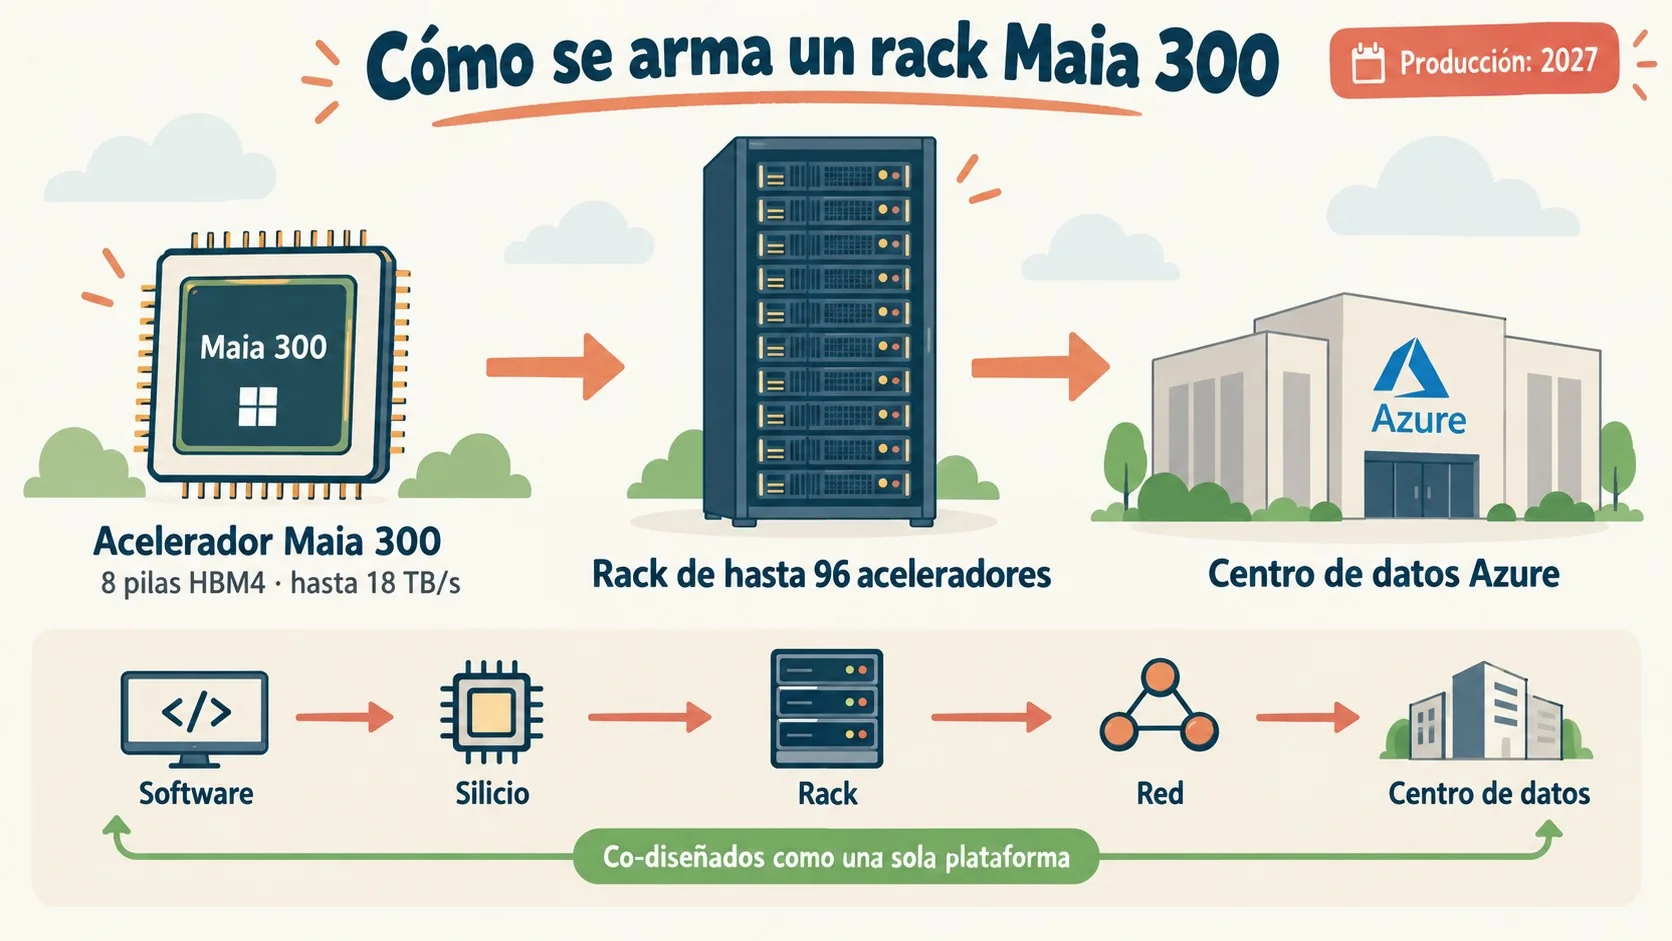
Azure Maia 300 es el próximo acelerador de IA propio de Microsoft, que la empresa presentó el 12 de octubre de 2026. Microsoft planea desplegarlo en racks de hasta 96 aceleradores y llevar Azure Maia a escala multi-gigavatio desde 2027, con hasta 7 veces el throughput de tokens de Maia 200.
Azure Maia 300 es un acelerador de IA diseñado por Microsoft para inferencia, es decir, para ejecutar modelos ya entrenados y generar respuestas, no para entrenarlos. Es la tercera generación de la familia Maia y apunta a contextos largos y tareas agénticas de varios pasos. Microsoft lo va a usar en Copilot, GitHub y Foundry, y todavía no lo ofrece como instancia para clientes de Azure.
En este artículo:
- En 30 segundos
- ¿Qué lleva un rack de Azure Maia 300?
- ¿Cuánto mejora Maia 300 frente a Maia 200 y a las GPU?
- ¿Por qué Microsoft diseña chips para inferencia agéntica?
- ¿Cuándo llega Maia 300 y qué es un despliegue multi-gigavatio?
- ¿Qué cambia para quienes usan Azure y Copilot en Argentina y Latinoamérica?
- ¿Qué está confirmado y qué falta saber de Maia 300?
- Errores comunes al leer el anuncio de Maia 300
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Qué anunció Microsoft: Maia 300, que será el sistema principal de inferencia de sus productos y servicios.
- Hardware: hasta 96 aceleradores por rack, con ocho pilas de memoria HBM4 y hasta 18 TB/s de ancho de banda pico por chip.
- Promesas: hasta 7 veces el throughput de Maia 200 por rack y 40% más tokens por megavatio que los sistemas con GPU líderes. Son cifras de Microsoft, sin medición independiente.
- Cuándo: despliegues de producción en 2027. Más detalles en Ignite 2026, en noviembre de 2026 en San Francisco.
¿Qué lleva un rack de Azure Maia 300?
Un rack de Maia 300 reúne hasta 96 aceleradores, y cada uno lleva ocho pilas de memoria HBM4 con hasta 18 TB/s de ancho de banda pico, según The Register, que cita el blog de Scott Guthrie, vicepresidente ejecutivo de Cloud + AI. Microsoft lo presenta como un “sistema completo”: software, silicio, rack, red y centros de datos co-diseñados para funcionar como una sola plataforma.
Hay más detalle en la cobertura de dos medios especializados. Ojo: no figura en el resumen oficial de Microsoft que revisamos, así que es información secundaria hasta que salga la documentación completa.
- Chip: según StorageReview, cómputo en TSMC N2P y ocho pilas HBM4 que suman 288 GB y 18 TB/s dentro de 950 W de TDP. Maia 200 tenía 216 GB y 7,1 TB/s.
- Rack: 96 aceleradores en 167 kW y 27,6 TB de HBM, contra 48 aceleradores y 64 kW en el rack de Maia 200.
- Red: Converge Digest describe Ethernet con transporte propio de IA, enlaces ópticos entre racks y superpods de hasta 128 racks y 12.288 aceleradores.
- Maia 200: ya atiende cargas de producción y, según el comunicado oficial, rinde hasta 1,7 veces más tokens por watt en funciones de IA integradas.
¿Cuánto mejora Maia 300 frente a Maia 200 y a las GPU?
Microsoft proyecta hasta 7 veces el throughput de tokens de Maia 200 a escala de rack y 40% más tokens por megavatio que los sistemas basados en GPU líderes, según el comunicado oficial. Son proyecciones de la empresa (el texto habla de rendimiento “esperado”) y no hay benchmarks independientes.
Tokens por megavatio mide cuánta salida de texto genera un centro de datos por cada megavatio que consume. Importa porque la potencia eléctrica disponible limita cuánta IA se puede servir desde un edificio.
Con las especificaciones que publica StorageReview, el 7x no sale solo del hardware. El pico de FP4 por rack sube de 485 a 1.324 POPS (unas 2,7 veces) y el ancho de banda HBM del rack, de 341 a 1.728 TB/s (5,1 veces). ¿Y de dónde sale el resto? Ninguna fuente lo explica. Es inferencia nuestra, no dato de Microsoft. Esto se conecta con lo que analizamos en el peso de Azure en los ingresos de Microsoft.
Por chip el cambio es más modesto en cómputo: el pico FP4 sube 37% (de 10,1 a 13,8 POPS) mientras la memoria crece 2,5 veces. Es un chip pensado para la fase de decode, donde el cuello de botella es alimentar las unidades de cálculo.
Dicho esto, Microsoft no aclara contra qué GPU se midió el 40%, con qué modelo, con qué longitud de contexto ni con qué latencia objetivo. Además, Maia corre solo dentro de Microsoft y nadie de afuera puede repetir la prueba, de modo que por ahora es una promesa de la empresa y no un resultado que vos puedas verificar.
¿Por qué Microsoft diseña chips para inferencia agéntica?
Porque Microsoft sostiene que los flujos agénticos (ejecución en varios pasos, decodificación con contexto largo y uso de herramientas) cambian el perfil computacional y la intensidad aritmética de la inferencia. Según el blog de Guthrie, Maia 300 tiene una arquitectura “inference-first” para cargas de contexto largo, intensivas en memoria y con mucho decode.
El enfoque se parece a los racks que ya desarrolló Nvidia y a Helios de AMD, que según The Register también integran silicio y software propios. Hay un giro de discurso. En 2024, Microsoft publicó sus “AI Access Principles”, que destacaban las alianzas, y le planteó a las autoridades de competencia de la Comisión Europea que Google tenía ventaja por su integración vertical. Hoy Microsoft tiene chips, racks y modelos MAI propios. No es incoherente (cada uno juega con lo que tiene), pero el cambio se nota. En certificaciones de Azure según tu rol profesional profundizamos sobre esto.
¿Cuándo llega Maia 300 y qué es un despliegue multi-gigavatio?
Los despliegues de producción de Maia 300 empiezan en 2027, y Microsoft dice que escalará Azure Maia a “multi-gigawatt deployments” desde ese año. Al 13 de octubre de 2026, Maia 300 no está disponible. Un gigavatio son 1.000 megavatios de potencia eléctrica, y el término mide el tamaño de una infraestructura por la energía que consume, no por la cantidad de servidores.
Guthrie lo resumió así, según StorageReview y Converge Digest (traducción nuestra): “Vamos a escalar nuestra familia Azure Maia a despliegues multi-gigavatio a partir de 2027, y Maia será el principal sistema de inferencia para los productos y servicios de Microsoft”.
Una cuenta de servilleta para dimensionarlo: 1 GW dividido 167 kW por rack da casi 6.000 racks, o unos 575.000 aceleradores. Es hipotética y generosa, porque supone que toda la potencia va a racks y el edificio también gasta en refrigeración y red. Sirve de orden de magnitud, nada más.
The Register pidió comentarios a Microsoft y su texto no reproduce respuesta. Las fuentes tampoco traen precios, regiones ni acceso para clientes. Maia 200, por su parte, se despliega en Estados Unidos, Europa y Australia. Relacionado: desplegar máquinas virtuales en Azure con Terraform.
¿Qué cambia para quienes usan Azure y Copilot en Argentina y Latinoamérica?
Hoy no cambia nada en costos ni en arquitectura para un equipo en Argentina: Maia 300 llega en 2027 y las fuentes no informan disponibilidad regional, precios ni qué servicios correrán sobre el chip. Según StorageReview, Microsoft tampoco ofrece Maia como tipo de instancia alquilable.
Como criterio práctico (propuesta editorial, no de Microsoft), cuando salgan los detalles de Ignite 2026 conviene chequear:
- Regiones: si Maia llega a regiones cercanas o queda en las tres de Maia 200.
- Instancias: si se alquila o queda detrás de Copilot y Foundry.
- Modelos y software: qué modelos corren y si hay que adaptar código.
- Benchmark: si el 40% nombra GPU, modelo, contexto y latencia objetivo.
Si lo tuyo es un sitio o una app con hosting o servidores en Argentina, esto no te cambia el plan. Mirá opciones locales como donweb.com.
¿Qué está confirmado y qué falta saber de Maia 300?
Confirmado por Microsoft o su blog
- Anuncio de Maia 300 y escala multi-gigavatio desde 2027.
- Maia será el sistema principal de inferencia de sus productos.
- Hasta 96 aceleradores por rack, ocho pilas HBM4 y hasta 18 TB/s por chip.
- Maia 200 ya corre cargas de producción.
Sin confirmar
- El 7x y el 40%: no hay medición independiente ni configuración de prueba.
- Nodo N2P, 288 GB y 167 kW: vienen de medios secundarios.
- Precios, regiones y acceso de clientes.
Errores comunes al leer el anuncio de Maia 300
- Creer que ya se puede usar. La producción empieza en 2027 y hoy el que corre es Maia 200.
- Leer el 7x como mejora por chip. Es throughput a escala de rack contra Maia 200. Por chip, el pico FP4 sube 37% según StorageReview.
- Tomar el 40% como benchmark. Es una proyección de Microsoft que no nombra la GPU comparada.
- Pensar que reemplaza a Nvidia. StorageReview indica que Nvidia y AMD siguen en la flota de entrenamiento, y Converge Digest aclara que Microsoft no abandona aceleradores de terceros.
Preguntas Frecuentes
¿Qué es Azure Maia 300?
Azure Maia 300 es el acelerador de IA de tercera generación de Microsoft, diseñado para inferencia. Se despliega en racks de hasta 96 aceleradores con memoria HBM4 y está pensado para contextos largos y tareas agénticas.
¿Cuándo llega Maia 300 a producción?
Los despliegues de producción de Maia 300 están planificados para 2027. Microsoft dará más detalles en Ignite 2026, en noviembre de 2026 en San Francisco. Te puede servir nuestra cobertura de conectarte por SSH a tus VM de Azure.
¿Cuánto más rápido es Maia 300 que Maia 200?
Microsoft proyecta hasta 7 veces el throughput de tokens de Maia 200 a escala de rack. Por chip, StorageReview reporta 37% más cómputo pico en FP4 y 2,5 veces más ancho de banda de memoria.
¿Maia 300 reemplaza a las GPU de Nvidia en Azure?
No hay anuncio de reemplazo. Maia será el sistema principal de inferencia de los productos de Microsoft, pero según StorageReview Nvidia y AMD siguen en la flota de entrenamiento.
¿Qué significa despliegue multi-gigavatio en un centro de datos?
Significa una infraestructura que consume del orden de miles de megavatios de potencia eléctrica, ya que 1 gigavatio equivale a 1.000 megavatios. Es una medida de escala por energía, no por cantidad de servidores.
Conclusión
Microsoft confirmó que Maia pasa a ser su motor principal de inferencia, con escala multi-gigavatio desde 2027. Para el lector común no hay decisión que tomar hoy. Lo que sí vale mirar es la memoria: el ancho de banda por chip crece mucho más que el cómputo, una apuesta clara por el decode. Esperá a Ignite en noviembre y exigí que el 40% y el 7x vengan con GPU, modelo y configuración nombrados.