Búsqueda vectorial en DynamoDB con AWS CDK, paso a paso
En pocas palabras: Se construye combinando DynamoDB vector search (disponible desde el 5 de agosto de 2026) con AWS CDK: se generan embeddings de 512 dimensiones con Amazon Titan Text Embeddings V2, se indexan con distancia coseno usando la API SearchVectors, y un Lambda combina esos resultados semánticos con búsqueda léxica en paralelo.
AWS anunció la disponibilidad general de la búsqueda vectorial en DynamoDB el 5 de agosto de 2026, según el blog oficial de AWS, disponible en todas las regiones comerciales y en AWS GovCloud (US). Un desarrollador publicó un proyecto de ejemplo con AWS CDK que combina embeddings de Titan V2 y búsqueda léxica para resolver el problema clásico del buscador por prefijo que no encuentra sinónimos.
La búsqueda vectorial DynamoDB es un tipo de índice que AWS sumó a su base de datos NoSQL para ejecutar búsquedas de similitud semántica sobre datos operacionales, sin replicarlos a una base vectorial aparte. Funciona generando embeddings (arreglos numéricos que representan el significado de un texto) con modelos como Titan Text Embeddings V2, y usando la API SearchVectors para encontrar los vectores más cercanos según distancia coseno, euclidiana o producto punto.
En este artículo:
- En 30 segundos
- ¿Qué es DynamoDB Vector Search y por qué se convirtió en noticia en 2026?
- ¿Cómo funciona la búsqueda vectorial en DynamoDB paso a paso?
- ¿Cómo se define un índice vectorial en DynamoDB usando AWS CDK?
- ¿Por qué combinar búsqueda semántica con búsqueda léxica en lugar de usar solo vectores?
- ¿Cuándo conviene sumar esto y cuándo no vale la pena?
- ¿Qué implica esto en costos y requisitos técnicos para implementarlo en la práctica?
- Funciones de distancia disponibles en DynamoDB Vector Search
- Errores comunes al implementar búsqueda vectorial en DynamoDB
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- La búsqueda vectorial en DynamoDB llegó a disponibilidad general el 5 de agosto de 2026, en todas las regiones comerciales y en GovCloud (US).
- El índice vectorial soporta hasta 4096 dimensiones y tres funciones de distancia: coseno, euclidiana y producto punto.
- La API SearchVectors devuelve hasta 100 resultados por consulta, con filtros inline opcionales por atributo.
- AWS CDK todavía no tiene soporte nativo para crear el índice: hay que resolverlo con un custom resource sobre UpdateTable.
- Un proyecto de ejemplo combina búsqueda semántica (Titan V2, 512 dimensiones) con búsqueda léxica por prefijo, ejecutadas en paralelo desde un mismo Lambda.
¿Qué es DynamoDB Vector Search y por qué se convirtió en noticia en 2026?
DynamoDB Vector Search es la función que permite crear un índice de tipo vectorial sobre un atributo de una tabla existente, para buscar por similitud semántica en vez de por coincidencia exacta. AWS la llevó a disponibilidad general el 5 de agosto de 2026, con latencia de milisegundos de un solo dígito y recall superior al 99%, según el anuncio oficial.
El caso de uso que motivó el proyecto de ejemplo publicado en dev.to es bastante común: un buscador de artículos de ayuda que solo hacía matching léxico por prefijo. Si el usuario escribía una palabra que no coincidía exactamente con el texto indexado, el resultado era cero coincidencias, aunque el artículo correcto existiera. Cualquiera que haya armado un buscador interno con LIKE o autocompletado básico se topó con este problema alguna vez, y hasta ahora la solución típica era resignarse a un buscador mediocre o meter una base vectorial aparte solo para eso.
Antes de esta función, si tu operación ya vivía en DynamoDB y querías sumar búsqueda semántica, tenías que copiar los datos a una base vectorial separada y mantener un pipeline de sincronización. Eso suma costo operativo, costo de movimiento de datos y otra pieza más para que se rompa un viernes a la tarde. Ahora los vectores y los datos operacionales comparten la misma infraestructura serverless y el mismo modelo de precio por request. Lo que cambia acá no es la técnica de embeddings en sí —eso ya existía— sino que deja de ser necesario duplicar infraestructura solo para tener búsqueda semántica.
¿Cómo funciona la búsqueda vectorial en DynamoDB paso a paso?
La búsqueda vectorial en DynamoDB funciona convirtiendo cada texto en un embedding, guardando ese embedding junto con los datos del ítem, y comparando distancias entre vectores cuando llega una consulta. El proyecto de ejemplo usa el modelo amazon.titan-embed-text-v2:0 con 512 dimensiones y normalización habilitada, mientras que el tutorial oficial de AWS usa 1024 dimensiones con el mismo modelo. Que ambas fuentes usen configuraciones distintas para el mismo modelo confirma algo importante: no hay una cantidad de dimensiones “correcta” universal, sino un trade-off entre precisión y espacio de almacenamiento que cada proyecto resuelve según su catálogo.
Titan Text Embeddings V2 soporta 256, 512 y 1024 dimensiones, según la documentación de Amazon Bedrock. El punto crítico acá es mantener consistencia: todos los embeddings (productos y consultas) tienen que usar el mismo modelo, la misma cantidad de dimensiones y el mismo criterio de normalización. Si cambiás uno solo de esos parámetros a mitad de camino, la comparación deja de tener sentido matemático, no es un detalle cosmético.
Para el ranking, el autor eligió distancia coseno, donde 0 representa vectores idénticos y valores más bajos indican mayor similitud. Como ese número no es intuitivo para ordenar resultados de mayor a menor relevancia, lo convierte en un score de similitud con la fórmula score = 1 - distancia coseno / 2, acotado entre 0 y 1. Una distancia de 0 da un score de 1 (match perfecto); una distancia de 2 da un score de 0 (nada que ver).
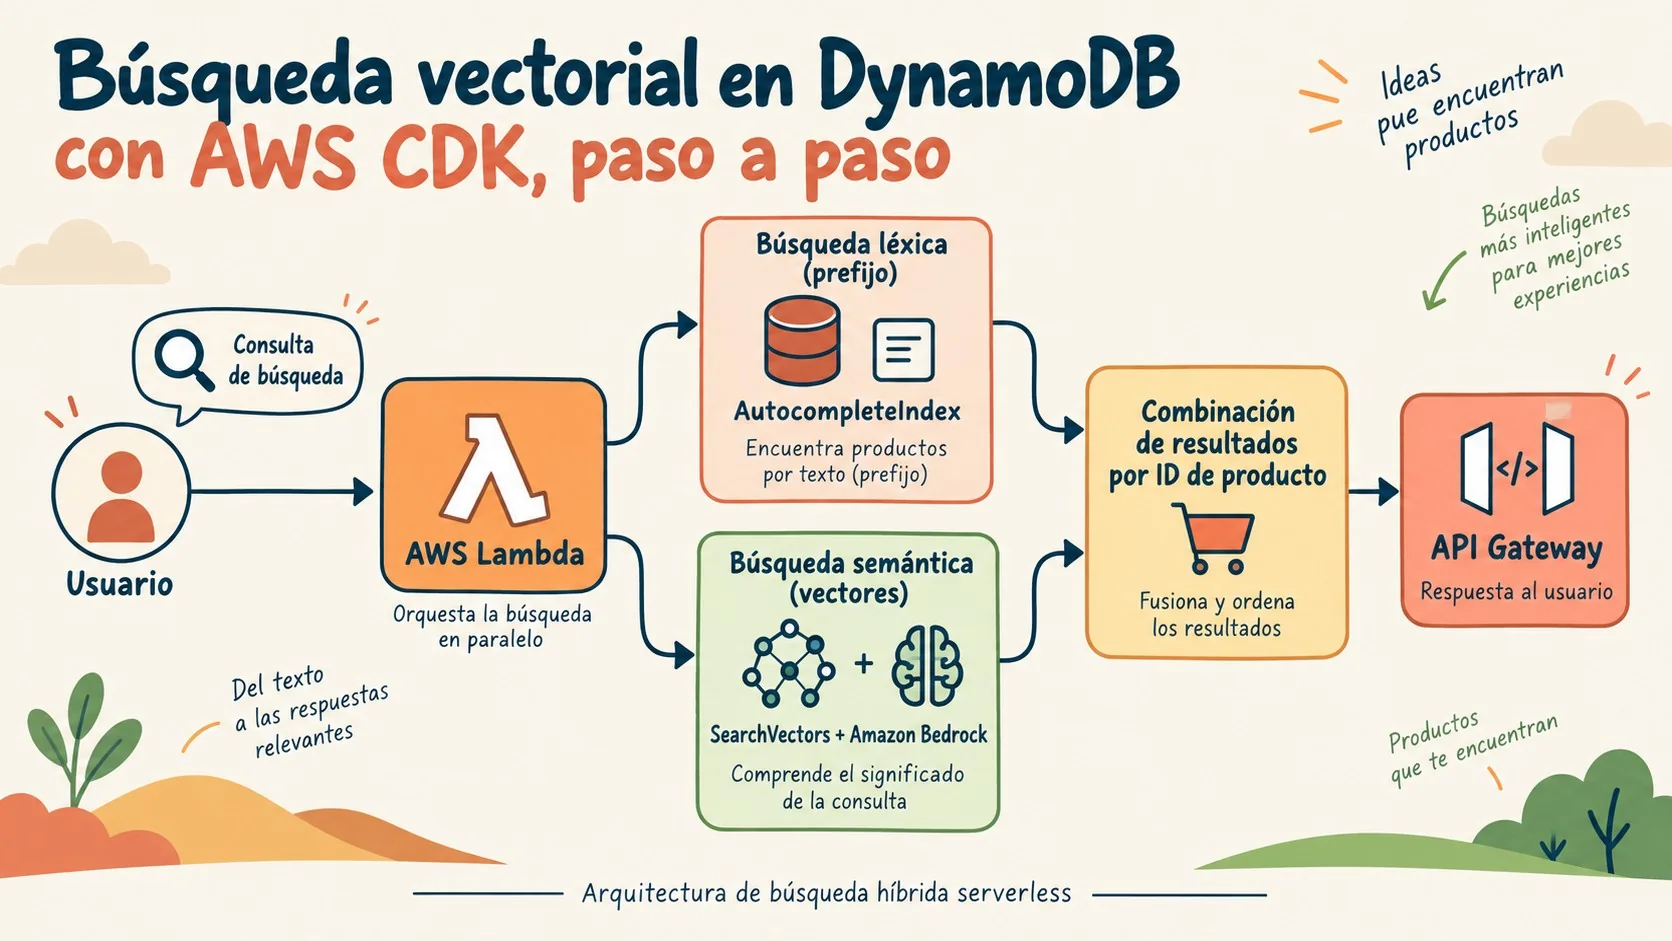
La API SearchVectors acepta un vector de consulta, la cantidad de resultados a devolver (hasta 100) y condiciones de filtro opcionales. En el proyecto de ejemplo, el Lambda pide un TopK de 25 candidatos semánticos por cada búsqueda: un margen bastante generoso si después vas a devolver solo 5 o 10 resultados combinados, pero tiene sentido como colchón para que la fusión con los resultados léxicos tenga con qué trabajar.
¿Cómo se define un índice vectorial en DynamoDB usando AWS CDK?
AWS CDK todavía no tiene soporte nativo para crear índices vectoriales, así que hay que encapsular la llamada de bajo nivel en un custom resource de CloudFormation. La solución del proyecto es un construct reusable llamado DynamoDbVectorIndex que invoca UpdateTable con el parámetro VectorIndexUpdates, especificando el atributo vector, las dimensiones, la función de distancia y los atributos proyectados.
Acá aparece el detalle más interesante de toda la infraestructura: la creación del índice es asíncrona. Que UpdateTable devuelva una respuesta exitosa no significa que el índice ya esté listo para usarse. Si CloudFormation diera por completado el recurso en ese momento, el deploy seguiría de largo con un índice todavía a medio crear (spoiler: eso rompe todo lo que dependa de él).
Para evitar esa condición de carrera, el provider del custom resource llama a DescribeTable cada diez segundos y recién reporta éxito cuando el índice llega al estado ACTIVE. También maneja el borrado y el reemplazo cuando cambian propiedades inmutables del índice. Es el mismo patrón que vale la pena guardar en el cajón de herramientas: cuando CDK todavía no expone una función nueva de forma directa, encapsulás la API de bajo nivel dentro de un construct propio, con un handler que arranca la operación y otro que la audita hasta que termina. Es más trabajo de plomería que de lógica de negocio, pero es exactamente el tipo de trabajo que evita sorpresas en producción.
Sobre la proyección de atributos: devolver los campos del producto directamente desde SearchVectors evita una lectura adicional, pero cada atributo proyectado consume espacio del índice vectorial. Por eso conviene proyectar solo lo que la respuesta realmente necesita, en vez de tirar ALL por comodidad.
Ejemplo hipotético: cuándo el índice asíncrono te muerde
Este es un escenario hipotético para ilustrar el problema de timing descrito arriba, no un caso documentado en las fuentes. Supongamos un pipeline de CI/CD que hace cdk deploy y, apenas termina, dispara automáticamente el script de carga de datos (seed.ts) contra la tabla recién creada. Si el custom resource no esperara a que el índice llegue a ACTIVE —es decir, si solo confiara en la respuesta de UpdateTable—, el deploy se daría por exitoso mientras el índice todavía está construyéndose. El script de carga podría entonces intentar poblar embeddings contra un índice que todavía no acepta escrituras completas, y el primer resultado visible sería un error intermitente y difícil de reproducir, porque a veces el índice ya estaría listo para cuando llegue la carga y a veces no. El polling cada diez segundos que describe el autor es, justamente, lo que evita que este escenario ocurra.
¿Por qué combinar búsqueda semántica con búsqueda léxica en lugar de usar solo vectores?
Porque la similitud semántica sola puede fallar justo en los casos donde el usuario escribió casi textualmente el nombre del producto. El ejemplo que usa el autor es contundente: si alguien busca “cloud run” y el catálogo tiene un producto llamado “Cloud Runner Shoes”, ese producto debería aparecer arriba de todo, aunque otro ítem resulte más cercano semánticamente según el embedding.
La solución del proyecto es correr las dos búsquedas en paralelo desde el mismo Lambda: una Query léxica contra un índice secundario (AutocompleteIndex) que busca por prefijo sobre el nombre normalizado del producto, y un SearchVectors semántico contra el índice vectorial. Después combina los candidatos por ID de producto y calcula un score final mezclando ambas señales.
¿Y si te olvidás del componente léxico y confiás todo a los vectores? Ahí es donde el buscador empieza a devolver resultados “razonables” pero no los que el usuario esperaba ver primero. La búsqueda tradicional sigue siendo muy efectiva para coincidencias casi exactas, y descartarla de una porque ahora existe la opción semántica sería tirar una herramienta que funciona bien.
¿Cuándo conviene sumar esto y cuándo no vale la pena?
Ni el anuncio de AWS ni el proyecto de ejemplo responden esta pregunta de forma directa, pero cruzando ambas fuentes se pueden armar algunos criterios razonables para decidir si esta arquitectura tiene sentido en un caso concreto:
- Tu catálogo o dataset ya vive en DynamoDB. Si los datos operacionales están en otra base (PostgreSQL, MySQL, un data lake), el ahorro de “no sincronizar a una base vectorial aparte” no aplica igual: de todos modos vas a mover datos hacia DynamoDB.
- El volumen justifica un índice dedicado. La propia documentación de AWS aclara que las características de recall del ANN se notan a partir de millones de vectores; para un catálogo de unos pocos cientos de ítems, un filtro léxico bien armado probablemente resuelva el problema sin necesidad de embeddings.
- Necesitás combinar filtros exactos con similitud semántica. Los filtros inline de
SearchVectors(como filtrar por categoría o marketplace en el ejemplo de AWS) tienen sentido cuando la búsqueda no es solo “encontrame lo más parecido”, sino “encontrame lo más parecido dentro de este subconjunto”. - Tu equipo puede sostener el custom resource de CDK. Como no hay soporte nativo, alguien tiene que mantener ese construct cuando AWS actualice el servicio. Si el equipo no tiene margen para eso, quizás conviene esperar a que CDK lo soporte de forma nativa antes de meterlo en producción.
¿Qué implica esto en costos y requisitos técnicos para implementarlo en la práctica?
El anuncio oficial de AWS no publicó tarifas puntuales para la búsqueda vectorial: remite directamente a la página de precios de DynamoDB para el detalle. Lo que sí queda claro es que los vectores comparten la misma infraestructura serverless y el mismo modelo de pago por request que ya usa el resto de la tabla, sin un servicio aparte que facturar por separado.
En cuanto a requisitos técnicos, el proyecto de ejemplo pide:
- Node.js 22 o superior y npm 11 o superior, para correr el CDK app y los scripts de carga.
- Permisos IAM para DynamoDB, Lambda, API Gateway, CloudFormation, IAM y la acción
bedrock:InvokeModel. - Un entorno con CDK bootstrap ya inicializado en la cuenta y región donde vayas a desplegar.
- Acceso habilitado a Titan Text Embeddings V2 en Amazon Bedrock, que se otorga por cuenta y por región.
Un detalle que se presta a confusión, según la documentación oficial de AWS: dynamodb:SearchVectors es una acción IAM nueva, así que las políticas existentes de solo lectura no la incluyen automáticamente. Tampoco alcanza con AWS CLI vieja: el soporte para vectores se sumó en la actualización del modelo de servicio del 4 de agosto de 2026, así que necesitás AWS CLI 2.36.16 o superior (o botocore 1.43.64 o superior si usás un SDK).
No hace falta experiencia previa en machine learning para seguir el tutorial. Con manejo de TypeScript y conceptos básicos de AWS alcanza, dice el propio autor del proyecto, lo cual tiene sentido porque toda la complejidad de generación de embeddings queda delegada en Bedrock.
Funciones de distancia disponibles en DynamoDB Vector Search
| Función de distancia | Cuándo conviene usarla | Cómo se lee el score |
|---|---|---|
| Coseno | Comparar el significado de textos con embeddings normalizados | Valores bajos = mayor similitud; 0 = vectores idénticos |
| Euclidiana | Cuando la magnitud del vector importa, por ejemplo agrupar por cantidad de compras | Valores bajos = mayor similitud |
| Producto punto | Recomendaciones que ponderan dirección e intensidad de interés juntas | Valores altos = mayor similitud |
La recomendación general de AWS es que la función de distancia del índice coincida con la que usó el modelo de embeddings al entrenarse. Titan V2 funciona bien con coseno cuando los vectores están normalizados, que es justo la configuración que eligió el autor del proyecto.
Errores comunes al implementar búsqueda vectorial en DynamoDB
- Esperar solo a que la tabla esté ACTIVE. El waiter
table-existsde AWS CLI miraTable.TableStatus, que puede pasar a ACTIVE mientras el índice vectorial todavía está en CREATING. Buscar contra un índice que no llegó a ACTIVE devuelveValidationException, no resultados parciales. - No abrir el hostname de búsqueda en el VPC endpoint.
SearchVectorsresuelve contra un endpoint dedicado (search-dynamodb.región.amazonaws.com), distinto del endpoint estándar de DynamoDB. Si tu red filtra tráfico saliente,CreateTabley las escrituras funcionan bien y solo falla la búsqueda, con un error de conexión que no explica la causa real. - Mezclar dimensiones entre productos y consultas. Si indexaste con 512 dimensiones y generás la consulta con 1024, la comparación no tiene sentido matemático. El modelo, las dimensiones y la normalización tienen que ser idénticos en ambos lados siempre.
- Asumir que los permisos de lectura ya alcanzan.
dynamodb:SearchVectorses una acción nueva. Una política de IAM armada antes de agosto de 2026 casi seguro no la tiene incluida, y el error de permisos denegados no siempre es obvio a primera vista.
Preguntas Frecuentes
¿Qué es DynamoDB Vector Search y desde cuándo está disponible?
DynamoDB Vector Search es un tipo de índice que permite buscar por similitud semántica sobre datos ya almacenados en una tabla de DynamoDB. AWS lo llevó a disponibilidad general el 5 de agosto de 2026, en todas las regiones comerciales y en AWS GovCloud (US).
¿Cómo se crea un índice vectorial en DynamoDB con AWS CDK?
Como CDK todavía no soporta esta función de forma nativa, se crea con un custom resource de CloudFormation que invoca UpdateTable con el parámetro VectorIndexUpdates. Ese custom resource hace polling con DescribeTable cada diez segundos hasta que el índice llega al estado ACTIVE, para evitar que el deploy avance con el índice a medio crear.
¿Qué diferencia hay entre búsqueda semántica y búsqueda léxica?
La búsqueda léxica compara texto exacto o por prefijo, mientras que la búsqueda semántica compara el significado de los textos a través de embeddings. En la práctica conviene combinar ambas: la léxica prioriza coincidencias casi textuales (como un nombre de producto) y la semántica encuentra resultados relevantes aunque no compartan las mismas palabras.
¿Cuánto cuesta usar la búsqueda vectorial en DynamoDB?
AWS no publicó tarifas específicas para la búsqueda vectorial en el anuncio de disponibilidad general y remite directamente a la página oficial de precios de DynamoDB. Lo confirmado es que los vectores comparten la infraestructura serverless y el modelo de pago por request de la tabla, sin un servicio aparte.
¿Necesito experiencia en machine learning para usar DynamoDB Vector Search?
No. Según el autor del proyecto de ejemplo, alcanza con conocimientos básicos de AWS y de TypeScript para seguir el tutorial completo, porque la generación de embeddings queda delegada en Amazon Bedrock a través de la API InvokeModel.
Conclusión
Lo que cambió en agosto de 2026 es concreto: si tu operación ya vive en DynamoDB, ya no necesitás sincronizar datos a una base vectorial aparte para sumar búsqueda semántica. Eso saca una pieza entera de infraestructura de la ecuación, con su pipeline de sincronización y su factura por separado.
Ahora bien, la parte que no está resuelta de fábrica es CDK: todavía tenés que armar un custom resource a mano para crear el índice, con su propio manejo de estados asíncronos. No es un detalle menor ni algo que se resuelva copiando el ejemplo tal cual: implica que alguien en el equipo entienda por qué el polling contra DescribeTable es necesario y qué pasa si se lo saltea. Si estás evaluando este stack para producción, probá primero el custom resource en un ambiente de staging, mirá cuánto tarda el índice en pasar a ACTIVE con tu volumen real de datos, y recién después metelo en tu pipeline de CDK. Y si el proyecto entero corre en infraestructura propia además de AWS, para el resto de tu stack (hosting, dominios, cloud en Argentina) tenés la opción de donweb.com.