Errores silenciosos n8n: el éxito que no era real
En pocas palabras: En n8n, un workflow en estado “success” no garantiza que la acción real haya ocurrido: un código 202 significa que la API aceptó la solicitud, no que la aplicó. La solución es agregar un nodo de verificación que lea el dato de vuelta por su clave de negocio después de cada escritura crítica.
Un workflow de n8n terminó con todos los nodos en verde, estado final “success”, y el registro del lead nunca existió en el CRM. La causa: la API respondió con un código 202 (aceptado), el proveedor encoló la solicitud, la cola la descartó y nadie se enteró hasta dos días después, cuando el cliente preguntó por qué no hubo seguimiento.
Un error silencioso en n8n es una ejecución que termina en estado “success” en todos los nodos sin que la acción real (crear un registro, mandar un email, escribir una fila) haya pasado en el sistema de destino. El workflow hizo la llamada, la API respondió sin arrojar error, pero el efecto esperado en el mundo real nunca se concretó. Ese es el núcleo de los errores silenciosos en n8n: la respuesta describe la llamada, no el resultado.
En este artículo:
- En 30 segundos
- Qué es un efecto secundario en un workflow (y por qué el verde no lo garantiza)
- 202, 200 y la trampa de confundir respuesta con resultado
- Tres formas en que un “éxito” en n8n puede ser falso
- El nodo de verificación: leer el dato de vuelta por su clave de negocio
- Verified, failed, pending-review: qué hacer con cada estado
- Criterios para decidir qué verificar (y qué dejar fire-and-forget)
- Cómo evitar que la verificación cuelgue el workflow
- Cómo cambia el reporte final de ejecución
- Errores comunes al tratar con errores silenciosos en n8n
- Preguntas frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un workflow con todos los nodos verdes creó un lead en apariencia, pero el CRM nunca tuvo el registro porque la API devolvió un 202 (“aceptado”) y la cola interna del proveedor lo descartó sin avisar, según relata el artículo original sobre side effects en n8n.
- Hay tres formas de “éxito falso”: aceptado pero no aplicado, aplicado en el destino equivocado (credencial mal apuntada) y absorbido por deduplicación silenciosa del proveedor.
- El fix propuesto es un nodo extra después de cada escritura crítica: leer el dato de vuelta por su clave de negocio (email o lead id), nunca por el id que devolvió la API.
- El patrón define tres estados: verified, failed y pending-review, y este último nunca debe auto-reintentarse para no duplicar el efecto.
- Synergy Web identificó además cinco causas típicas de fallo silencioso en producción, desde campos vacíos hasta flujos corriendo en modo test sin que nadie lo note, según el análisis de Synergy Web.
Qué es un efecto secundario en un workflow (y por qué el verde no lo garantiza)
Un efecto secundario es el cambio real que un workflow produce afuera de sí mismo: un registro que aparece en el CRM, un email que llega a la bandeja, una fila que se escribe en una hoja. Un nodo verde solo confirma que la llamada no lanzó una excepción. Nada más que eso.
Esa distinción quedó clara en el caso documentado por este artículo de build-in-public sobre templates de n8n en producción: un workflow tomaba un lead nuevo, lo enriquecía y creaba un registro en el CRM. El log de ejecución estaba limpio, cada nodo en verde, status final success. Dos días después el cliente preguntó por qué nunca se hizo seguimiento del lead. El CRM no tenía ningún registro de esa persona.
Nada explotó, y ese es justo el problema. Una caída es ruidosa, salta a la vista en cualquier dashboard. Un efecto secundario faltante es silencioso porque el workflow hizo exactamente lo que se le pidió: llamó a la API y la API dijo que todo bien. La brecha está entre “la llamada tuvo éxito” y “el mundo cambió”, y ahí es donde vive la mayoría de los bugs de producción que describe el autor original.
202, 200 y la trampa de confundir respuesta con resultado
Un 202 significa “aceptado”, no “aplicado”: el proveedor tomó tu request y lo metió en una cola, pero eso no garantiza que esa cola lo procese. Un 200 tampoco alcanza si lo que valida el nodo es la respuesta HTTP y no el estado final del recurso. Cubrimos ese tema en detalle en cuando el workflow marca éxito sin ejecutar nada.
Ponele que tu nodo de HTTP Request manda la creación de un lead y recibe un job id o un ticket de cola como respuesta. Ese identificador no describe el estado del dato, describe el hecho de que alguien lo anotó en una lista de pendientes. Si la cola se cae, si un worker crashea, si el retry expira, nada de eso le llega de vuelta a tu workflow. n8n no tiene forma de saberlo con la sola respuesta HTTP, porque nunca le pediste que mirara más allá de esa respuesta.
Tres formas en que un “éxito” en n8n puede ser falso
Hay tres patrones concretos: aceptado pero no aplicado, éxito en el destino equivocado y éxito absorbido por deduplicación. Los tres comparten la misma raíz: el workflow confió en la respuesta en vez de chequear el mundo real.
- Aceptado pero no aplicado. Un 202, un webhook en cola, un job id asíncrono significan que el proveedor tomó tu pedido, no que lo ejecutó. Las colas se caen, los workers crashean, los retries expiran. Si tu workflow termina en el accept, verificaste la entrega, no el efecto.
- Éxito en el destino equivocado. La llamada le pegó a una cuenta sandbox, a una lista de staging o al workspace de un compañero, porque una variable de entorno o una credencial apuntaba a un lugar distinto del que el dashboard que vos revisás te muestra. El efecto pasó, solo que no donde nadie lo va a encontrar. Siempre es un valor de configuración, nunca un bug de código.
- Éxito absorbido por deduplicación. El proveedor aceptó el registro, lo comparó contra uno existente y lo fusionó o descartó como duplicado en silencio. Tu workflow creó algo, el sistema decidió que ya lo tenía. Sin error, sin registro al que puedas apuntar, sin seguimiento posible.
El nodo de verificación: leer el dato de vuelta por su clave de negocio
El criterio práctico es simple: después de cada escritura que importa, agregá un nodo que lea el dato de vuelta por su clave de negocio, nunca por el id que devolvió la API de creación. Ese id puede ser un ticket de cola y no dice nada sobre qué quedó guardado.
Para un CRM, eso significa consultar el registro por el email o el id propio del lead, no por el id de respuesta del create. Para un email, significa chequear el estado del mensaje en el proveedor, no confiar en el 200 del send. Para una fila de sheet, significa leer la fila de vuelta y comparar los campos que escribiste, no asumir que el append llegó entero. Es el patrón que propone el autor del caso original, y tiene sentido: solo un read-back describe el efecto, una respuesta describe la llamada.
Ejemplo hipotético (ilustrativo, no un caso real): imaginá un workflow que recibe un formulario de contacto, crea el lead en el CRM y después manda un email de bienvenida. Si el nodo de creación responde con un id de proceso en vez de un id de registro, el workflow no tiene cómo saber si el lead quedó guardado. Agregando un nodo que, un segundo después del create, busque ese lead por su email en el CRM, el workflow pasa a tener tres salidas posibles en vez de una: el lead aparece con los datos correctos (verified), el CRM devuelve un error de validación conocido (failed, va a revisión), o todavía no aparece porque el proveedor tarda en indexar (pending-review, se reintenta la lectura una vez más y después se frena). Ninguna de esas tres salidas existía cuando el workflow solo miraba el código HTTP del create.
Verified, failed, pending-review: qué hacer con cada estado
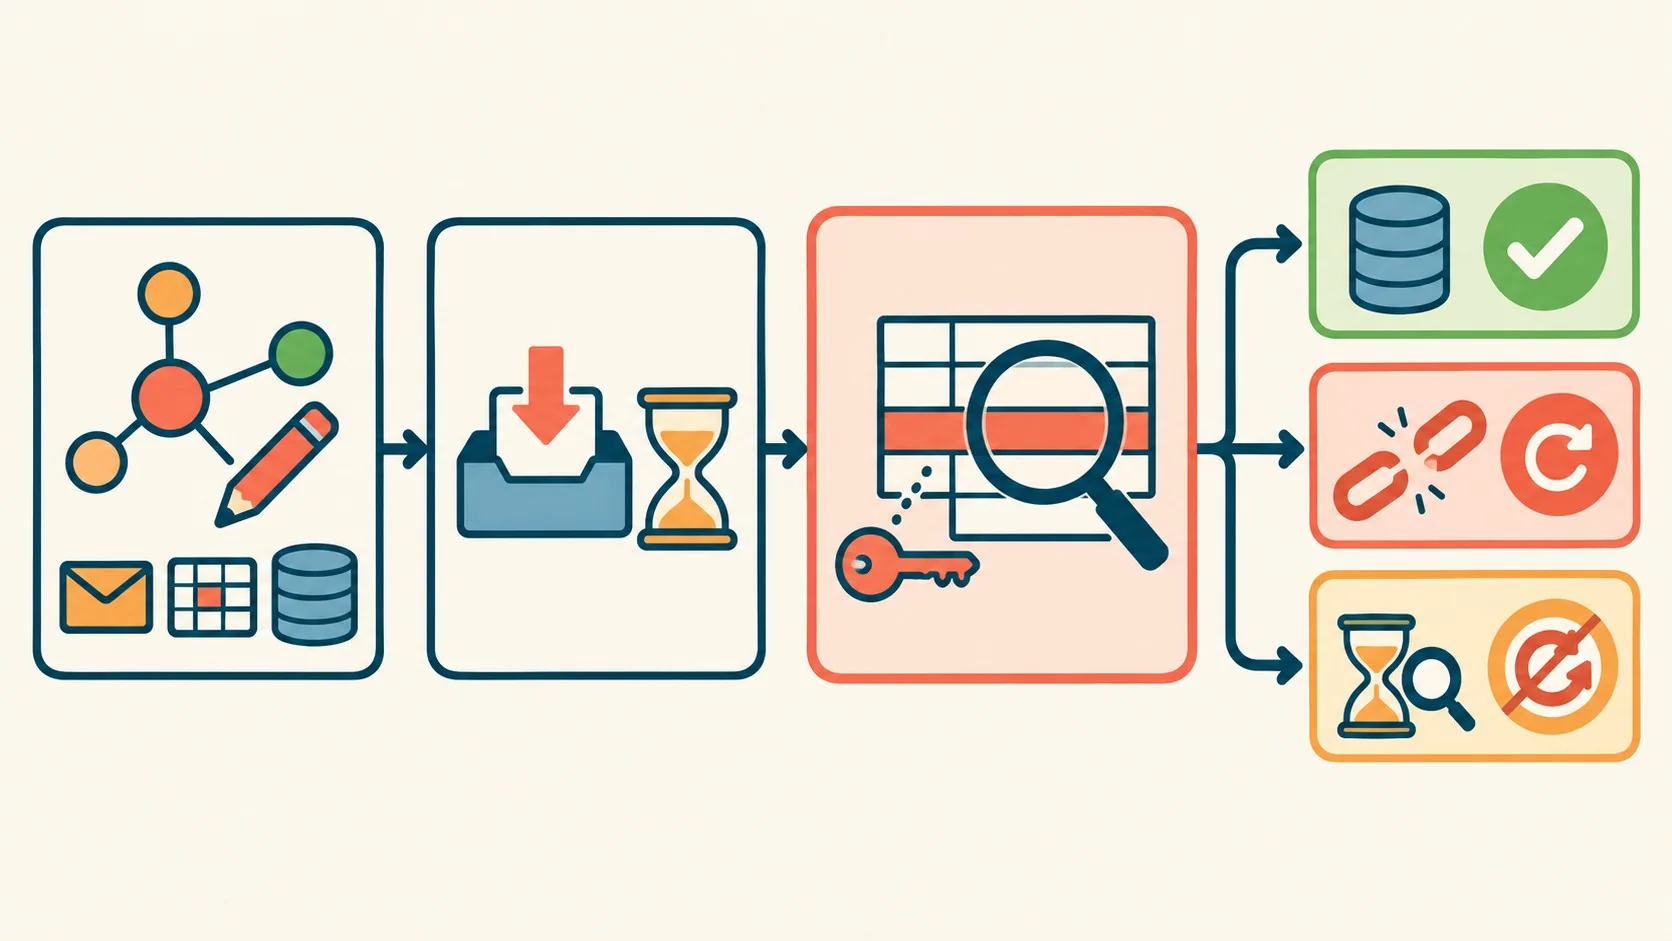
El read-back tiene tres salidas posibles: verified cuando la lectura coincide con lo esperado, failed cuando la lectura confirma que el efecto no existe por una causa conocida, y pending-review cuando el resultado es ambiguo. Cada bucket se trata distinto. Tema relacionado: usando expresiones para validar datos de salida.
Verified significa que el dato leído matchea lo que se intentó escribir, fin del asunto. Failed implica una causa identificable (un payload rechazado, un error de validación), así que el registro va a una lista de dead-letter para reintentarse de forma controlada. Pending-review es el bucket delicado: el proveedor está lento, el registro todavía no es visible, o el estado es confuso. Esa categoría nunca debe auto-reintentarse, porque reenviar un efecto que no podés confirmar es exactamente cómo un lead termina convertido en dos.
Criterios para decidir qué verificar (y qué dejar fire-and-forget)
No todo nodo necesita un read-back, y meterlo en todos lados solo agrega latencia y ruido. La fuente original resume el corte así: si una persona podría quedar engañada por un falso éxito, se verifica; si no, puede seguir siendo fire-and-forget. Esa regla se puede desarmar en preguntas concretas antes de agregar el nodo extra:
- ¿El efecto toca plata o un compromiso con un cliente? Un pago, una factura, un email de confirmación de pedido entran acá casi siempre.
- ¿Alguien se va a enterar solo porque falló algo después, y no porque vos lo detectaste primero? Si la respuesta es sí (como en el caso del lead que tardó dos días en notarse), conviene verificar.
- ¿El proveedor de esa integración es conocido por devolver códigos “aceptado” en vez de confirmación inmediata (202, webhooks asíncronos, colas)? Si sí, el riesgo de éxito falso sube bastante.
- ¿Existe una clave de negocio clara para hacer el read-back (email, id propio, número de orden)? Si no hay forma simple de buscar el dato de vuelta, el verify se vuelve más caro que el riesgo que mitiga, y ahí vale la pena repensar el diseño antes de forzarlo.
Un log de debug o una notificación interna que nadie va a reclamar si falla, en cambio, puede quedar fuera de este chequeo sin culpa.
Cómo evitar que la verificación cuelgue el workflow
Dos reglas resuelven esto. Primero, verificá con una espera y un número acotado de chequeos, nunca con un loop sin límite: una lectura inmediata, una segunda después de una espera corta, y si ninguna confirma, directo a pending-review. Un loop de verificación sin tope convierte un proveedor lento en un workflow colgado.
Subís el workflow, lo probás en local, funciona bárbaro, lo mandás a producción y de repente el nodo de verificación arranca a chequear cada log intermedio, agrega latencia donde no hace falta y el equipo termina apagando la verificación entera porque “molesta”, que es exactamente lo contrario de lo que se buscaba. Por eso conviene fijar de antemano, antes de tocar un solo nodo, cuáles son las dos o tres escrituras que realmente necesitan este chequeo.
Cómo cambia el reporte final de ejecución
El resumen de ejecución deja de decir solo “success: 50” y pasa a mostrar “verified: 48, failed: 1, pending-review: 1”. Ese número de pending-review es justo el dato que antes se descubría dos días después, cuando el cliente llamaba a preguntar. En al verificar escrituras reales en Airtable profundizamos sobre esto.
¿Y qué pasa con ese 1 pending-review? Se queda a la vista en el dashboard, chico y accionable, en vez de escondido detrás de un “success” general. El principio que resume el autor es directo: el trabajo de un workflow no es hacer llamadas, es cambiar el mundo de la forma que le pediste. Hasta que no leés el mundo de vuelta, solo probaste que preguntaste con educación.
| Patrón de error handling | Qué detecta o previene | Qué NO resuelve |
|---|---|---|
| Error Trigger node | Errores que n8n puede capturar cuando un nodo explota | Efectos que nunca ocurrieron sin lanzar error (202, dedupe silencioso) |
| Continue on Fail + IF | Fallos en nodos no críticos sin frenar todo el flujo | No confirma si el nodo marcado como exitoso escribió algo de verdad |
| Retry on Fail | Fallos transitorios: rate limit, timeout, red caída | Reintentar sobre un efecto ambiguo puede duplicar el registro |
| Validación de inputs | Campos vacíos o con formato distinto antes de procesar | No detecta fallos posteriores al envío, como una cola que se pierde |
| Read-back por clave de negocio | Confirma si el efecto se aplicó en el sistema de destino real | Exige un nodo extra y lógica de espera acotada para no colgar el flujo |
Errores comunes al tratar con errores silenciosos en n8n
- Confiar en el id que devuelve el create. Ese id suele ser un ticket de cola, no una confirmación de que el dato quedó guardado. Hay que verificar siempre por la clave de negocio (email, lead id), no por el id de respuesta.
- Armar un loop de verificación sin límite. Si el read-back no tiene tope de intentos ni espera definida, un proveedor lento transforma tu workflow en una ejecución colgada indefinidamente.
- Reintentar un pending-review automáticamente. Es la forma más directa de duplicar un lead o un pago: si el estado es ambiguo, se manda a revisión manual, no a un retry automático.
- No distinguir entre flujo de test y flujo activado en producción. Según el análisis de Synergy Web, un workflow puede mostrar ejecuciones limpias usando datos de prueba mientras el trigger de producción nunca se activó con datos reales.
- No configurar un Error Workflow en Settings. Sin un flujo de error centralizado que alerte por Slack o email, un fallo puede quedar invisible hasta que lo note un cliente, no tu propio dashboard.
Preguntas frecuentes
Mi workflow muestra éxito pero la acción no se ejecutó, ¿por qué?
Porque n8n marca “success” cuando ningún nodo lanza una excepción, no cuando la acción real se completó en el sistema de destino. Si la API devolvió un código de aceptación (como un 202) o el dato llegó vacío por un formato distinto al esperado, el workflow termina limpio sin que el efecto haya pasado.
Verificar que un registro quedó bien creado en el CRM
Se logra agregando un nodo después del create que consulte el CRM por la clave de negocio del lead (email o id propio), nunca por el id que devolvió la llamada de creación. Si la consulta encuentra el registro con los datos correctos, está verificado; si no, hay que mandarlo a una lista de revisión en vez de asumir que todo salió bien.
La diferencia entre un 202 y que la acción se haya aplicado de verdad
Un 202 confirma que el proveedor aceptó la solicitud y la puso en una cola de procesamiento, no que la ejecutó. La acción solo se considera aplicada cuando una lectura posterior del recurso (el registro, el mensaje, la fila) confirma que el cambio existe en el sistema real. Te puede servir nuestra cobertura sobre cómo revisar las respuestas del nodo HTTP Request.
¿Vale la pena verificar todas las escrituras de un workflow?
No necesariamente. Un log interno o una notificación que nadie va a reclamar si falla puede seguir siendo fire-and-forget. El criterio práctico es verificar lo que un humano podría dar por hecho erróneamente: pagos, registros de CRM, emails a clientes. Lo demás, mejor dejarlo liviano.
Conclusión
El caso documentado deja un punto concreto: un workflow en n8n puede reportar éxito en cada nodo y, al mismo tiempo, no haber cambiado nada en el sistema de destino. La solución propuesta (un nodo de read-back por clave de negocio, con buckets de verified, failed y pending-review) es un criterio editorial razonable, no un resultado medido ni una garantía universal: cada integración tiene su propia forma de confirmar un efecto, y hay proveedores donde ese chequeo es más barato que en otros.
Lo que sí queda claro es la pregunta que hay que hacerse antes de dar por cerrado cualquier workflow crítico: ¿la respuesta que recibiste describe la llamada o describe el mundo? Si no podés responder eso con un dato concreto, todavía no terminaste de construir el flujo.
Fuentes
- Your Workflow Said Success and Nothing Happened: Verifying Side Effects in n8n – artículo original sobre el caso del CRM y el patrón de verificación
- Tu flujo de n8n muestra éxito pero no funciona – análisis de Synergy Web sobre las cinco causas más habituales
- n8n Error Handling Best Practices – guía sobre Error Trigger, Continue on Fail y Retry on Fail