Kubernetes: por qué se pierden archivos y se cae la API
En pocas palabras: Los archivos se pierden porque el pod los guardó en el filesystem del contenedor en vez de un PersistentVolumeClaim, que desaparece al reiniciar. Así se perdieron 1.240 adjuntos en Contoso tras un deploy de rutina. La solución: montar un PVC y usar Services por nombre DNS, nunca la IP del pod.
Un lunes, un deploy de rutina en el portal de soporte de Contoso borró 1.240 archivos adjuntos subidos en los nueve días previos. La causa: los pods guardaban esos archivos en el filesystem del contenedor, no en un volumen persistente. El jueves de la misma semana, un drenado de nodo cambió la IP del pod de la API de pedidos y tiró el checkout durante 35 minutos, sin que nadie hiciera un deploy.
Kubernetes networking y storage es el conjunto de mecanismos que define cómo se comunican los pods entre sí (red) y cómo persisten los datos que escriben (almacenamiento). A diferencia de una VM tradicional, en Kubernetes tanto la IP de un pod como su disco local son descartables por diseño: desaparecen cuando el pod se reinicia, se reprograma o se reemplaza en un deploy.
En este artículo:
- En 30 segundos
- ¿Por qué Kubernetes borra los archivos subidos al reiniciar un pod?
- ¿Por qué una API deja de responder sin que nadie haga un deploy?
- ¿Cómo evitar que las IPs de los pods rompan la conectividad?
- ¿Cómo se guardan datos que sobreviven al reinicio de un pod en kubernetes networking y storage?
- ¿Por qué todos los pods pueden hablar entre sí por defecto y cómo bloquearlo?
- ¿Cuánto cuesta tener almacenamiento persistente en vez de perder datos?
- ¿Cómo comprobar que los datos y la red están realmente protegidos?
- Errores comunes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un deploy en Contoso borró 1.240 archivos porque estaban en el filesystem del contenedor, no en un PersistentVolumeClaim.
- Un drenado de nodo (sin deploy) cambió la IP de un pod y rompió el checkout durante 35 minutos.
- Un disco Azure Standard SSD E10 de 128 GiB cuesta USD 9,60/mes; el equivalente en AWS EBS gp3 sale unos USD 10,24/mes.
- Kubernetes no tiene restricciones de red por defecto: todos los pods pueden hablar con todos, salvo que apliques una NetworkPolicy default-deny.
- Solo Calico y Cilium hacen cumplir las NetworkPolicy; Flannel y el bridge default de minikube las ignoran en silencio.
¿Por qué Kubernetes borra los archivos subidos al reiniciar un pod?
Porque el filesystem del contenedor muere con el pod, exactamente como está diseñado. No es un bug: es el comportamiento esperado de cualquier Deployment sin volumen persistente configurado. Complementá con diferencias entre Microsoft y GitHub.
En el caso documentado por el post original de CD’s DevOps Wiki, la app de Contoso escribía los adjuntos en una carpeta dentro del contenedor. Un deploy normal actualiza los pods (los reemplaza por versiones nuevas) y esa carpeta, con sus 1.240 archivos, se va con el pod viejo. Nadie tocó una base de datos ni borró nada a mano. El problema es que, en una VM, el disco es la máquina y dura años; en Kubernetes, el disco del contenedor es lo más efímero que hay. Esa inversión (lo que en una VM es permanente, en un pod es descartable) es la raíz de la mayoría de los incidentes de primer año con este sistema.
¿Por qué una API deja de responder sin que nadie haga un deploy?
Porque la IP de un pod cambia cada vez que se reprograma, y algo en el sistema seguía apuntando a una IP vieja. El jueves del caso Contoso, nadie desplegó nada: un nodo se drenó para aplicar parches, el pod de la API de pedidos se movió a otro nodo y recibió una IP nueva.
El problema fue que el tier web tenía esa IP hardcodeada en un archivo de configuración, copiada tres meses antes con kubectl get pods -o wide “porque lo del Service era confuso”. ¿Alguien se dio cuenta antes de que explotara en producción? No, hasta que los pedidos dejaron de procesarse. Guardar una IP de pod en un runbook o un config file es, según el post de CD’s DevOps Wiki, exactamente lo que el sistema no espera que hagas: cada pod tiene su propia IP y esa IP no es tuya para conservar.
¿Cómo evitar que las IPs de los pods rompan la conectividad?
Hablando con los Services por nombre DNS, nunca por IP de pod. Un Service obtiene una ClusterIP estable y, a través de CoreDNS, un nombre fijo como orders-api.contoso-shop.svc.cluster.local (o simplemente orders-api desde el mismo namespace), mientras kube-proxy reescribe el tráfico hacia los pods que matchean en cada momento.
| Tipo de Service | Alcance | Uso típico | Costo |
|---|---|---|---|
| ClusterIP | Solo dentro del cluster | Comunicación interna web → API → DB | Sin costo |
| NodePort | IP del nodo:30000-32767 | Labs, o detrás de tu propio load balancer | Sin costo |
| LoadBalancer | IP pública en la nube | Una app, un punto de entrada público | USD 18 a 25/mes por IP |
| Ingress / Gateway API | HTTP por host y path | Varias apps detrás de un mismo load balancer | Comparte el costo del LoadBalancer |
Ojo con esto: Ingress NGINX fue retirado en marzo de 2026, así que la opción recomendada es la Gateway API o un controller mantenido activamente, compartiendo un solo load balancer entre varias apps en vez de pagar uno por cada una. Te puede servir nuestra cobertura de conectarte por SSH a tu VM.
¿Cómo se guardan datos que sobreviven al reinicio de un pod en kubernetes networking y storage?
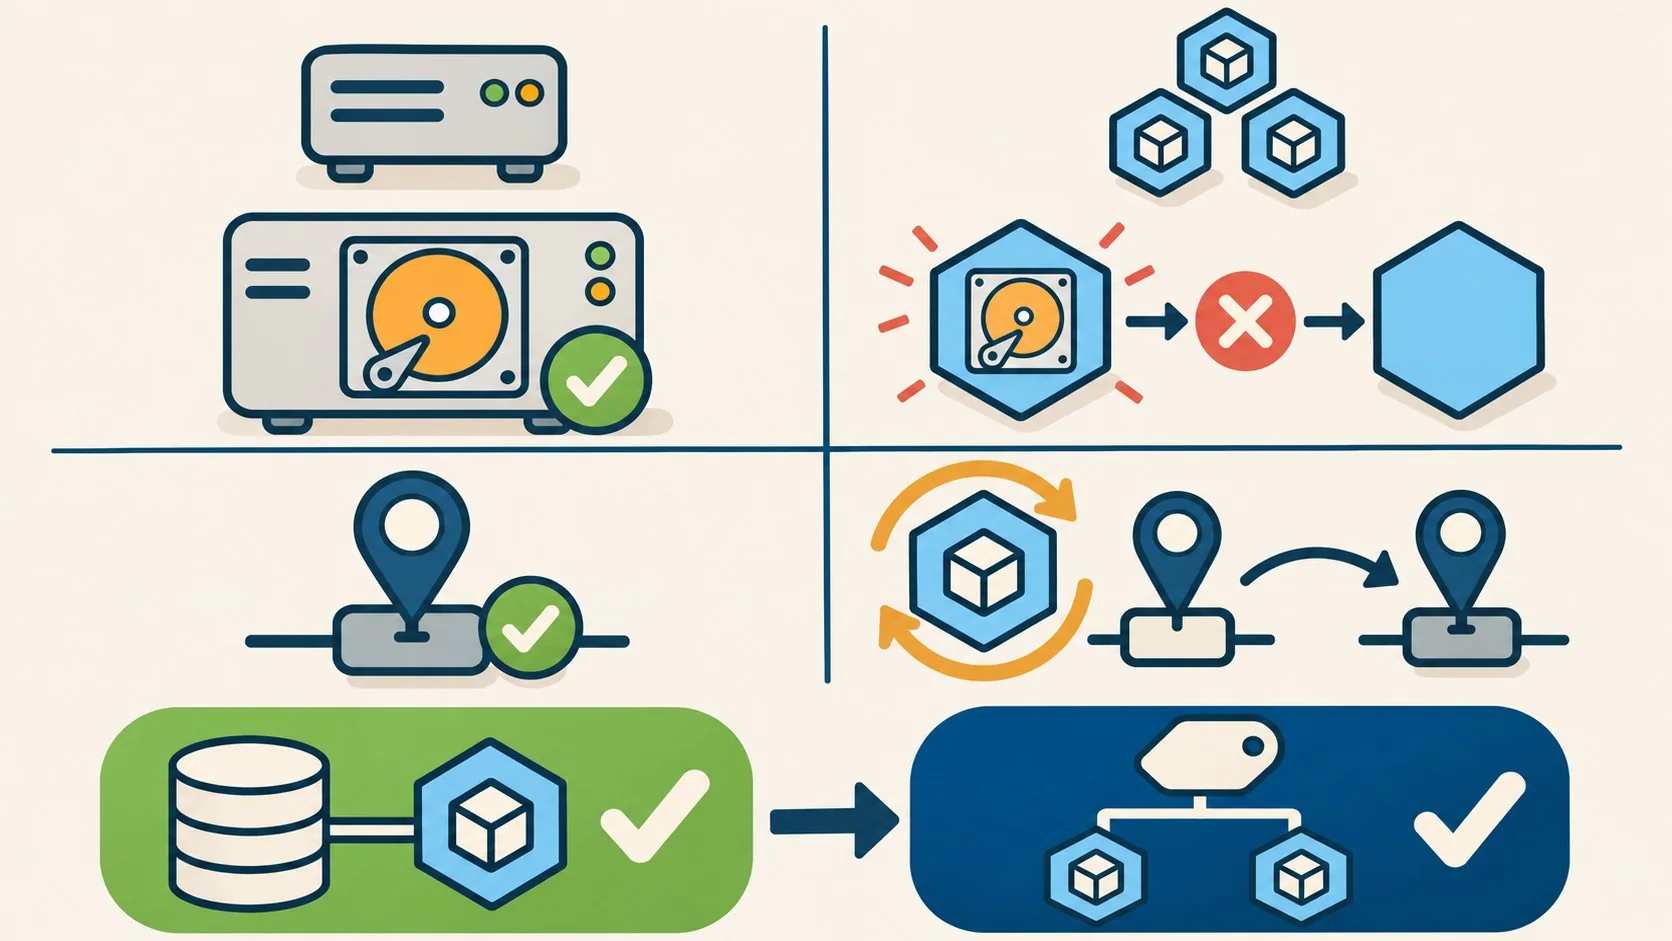
Con una PersistentVolumeClaim (PVC), que es el pedido formal de un pod por un disco que sigue existiendo después de que el pod muere. Según la documentación oficial de Persistent Volumes, un PersistentVolume (PV) es el recurso real de almacenamiento (provisto a mano por un admin o de forma dinámica vía StorageClass), y la PVC es el formulario de pedido: tamaño, modo de acceso y clase de storage.
emptyDir y el filesystem del contenedor son solo para cache: son los que mataron los 1.240 archivos del lunes. Para uploads servidos por varios pods web en distintos nodos (como el caso Contoso), hace falta ReadWriteMany (RWX), que soportan NFS, Azure Files o EFS; el modo ReadWriteOnce (RWO), el disco de nube típico, solo sirve a un nodo a la vez. Si armás tu propio share NFS en una VM que ya tenés corriendo, el costo adicional es cero; si esa VM la alquilás en la nube, en donweb.com hay planes de cloud que sirven bien para ese rol.
¿Por qué todos los pods pueden hablar entre sí por defecto y cómo bloquearlo?
Porque Kubernetes viene sin restricciones de red por defecto: cualquier pod puede abrir conexión con cualquier otro, sin NAT, sin firewall de por medio. Eso significa que si un pod web se compromete, puede conectarse directo a la base de datos.
La solución es una NetworkPolicy con podSelector: {} vacío y sin reglas, que según la documentación oficial de NetworkPolicies funciona como el interruptor de “negar todo en este namespace”, seguida de reglas explícitas de allow para lo que sí necesita comunicarse. El tema es que esto solo tiene efecto real si el plugin de red lo hace cumplir: Calico y Cilium hacen cumplir las NetworkPolicy, pero Flannel y el bridge default de minikube la ignoran en silencio (podés aplicarla con kubectl apply y no pasa absolutamente nada). Un detalle que se olvida seguido: el deny-all también bloquea DNS, así que hace falta una regla de egress explícita hacia kube-system en el puerto 53, o ningún nombre se resuelve y parece que la red está caída.
¿Cuánto cuesta tener almacenamiento persistente en vez de perder datos?
Entre USD 5,89 y USD 19,71 por mes para un disco de 128 GiB, según el nivel de performance que necesites. Estos son precios de lista verificados el 28 de octubre de 2026 por CD’s DevOps Wiki.
| Opción | Precio | Para qué sirve |
|---|---|---|
| Azure Standard HDD S10 (128 GiB) | USD 5,89/mes | Backups, archivos fríos |
| Azure Standard SSD E10 (128 GiB) | USD 9,60/mes | Uploads, bases chicas |
| Azure Premium SSD P10 (128 GiB) | USD 19,71/mes | Bases que necesitan IOPS |
| AWS EBS gp3 (128 GB) | ~USD 10,24/mes | Equivalente a Standard SSD |
| NFS en una VM propia | Sin costo adicional | Storage compartido RWX para labs o equipos chicos |
Compará eso contra lo que salió el incidente del lunes: dos días de trabajo de ingeniería para confirmar que los 1.240 archivos eran irrecuperables, más un mail de disculpas a los clientes. Un disco de USD 9,60 mensuales y un PVC bien configurado hubieran evitado todo eso. Para la referencia histórica de qué pasa cuando se ignora esta diferencia a mayor escala: el mismo post menciona el post mortem público de AdGuard VPN sobre un incidente del 2 de diciembre de 2025, donde un StatefulSet de Redis recreado para corregir un drift de tamaño de disco provocó 50 minutos de caída porque no había probes de startup ni readiness configurados.
¿Cómo comprobar que los datos y la red están realmente protegidos?
Borrando el pod y viendo qué sobrevive. Si después de kubectl delete pod los archivos siguen en el PVC, el DNS sigue respondiendo y una conexión bloqueada por NetworkPolicy da timeout en vez de conectar, la configuración está funcionando de verdad.
Como propuesta práctica de verificación (no como algo que probamos nosotros, sino como criterio reproducible que cualquiera puede correr en su cluster): montá un pod descartable con kubectl run probe --rm -it --image=busybox:1.36, hacé wget contra el nombre del Service para confirmar que DNS resuelve, y después un nc -zv db 27017 sin el label correcto para confirmar que el default-deny bloquea la conexión. Si en cambio el nc conecta sin problema, la NetworkPolicy no se está aplicando (probablemente porque el CNI no la hace cumplir), y conviene revisarlo antes de confiar en que “ya está resuelto”. Ya lo cubrimos antes en certificarte en Azure según tu rol.
Errores comunes
- Guardar la IP de un pod en un config file o runbook. Esa IP cambia en el próximo reinicio, drenado o deploy; usá siempre el nombre DNS del Service.
- Confiar en una NetworkPolicy sin verificar que el CNI la hace cumplir. Con Flannel o el bridge default de minikube,
kubectl applyda éxito pero la política no hace nada. - Usar RWO con réplicas en varios nodos. Si tenés tres pods web en tres nodos distintos con una claim ReadWriteOnce, dos quedan en
Pendingpara siempre; hace falta RWX. - Dejar el reclaim policy en
Deletepor defecto. Si borrás la PVC por error, el disco dinámicamente provisto desaparece con ella; para datos que importan, hay que setearRetain. - Olvidar la regla de egress a DNS en un default-deny. El deny-all bloquea también la resolución de nombres hacia
kube-system, y el síntoma se confunde con “la red está caída”.
Preguntas Frecuentes
¿Por qué se pierden los archivos subidos cuando se reinicia un pod en Kubernetes?
Porque el filesystem del contenedor se destruye junto con el pod cuando este se reinicia, reprograma o reemplaza. Si la app escribe los archivos en una carpeta local del contenedor en vez de un PersistentVolumeClaim, esos datos se pierden en el próximo ciclo de vida del pod, como pasó con los 1.240 archivos del caso Contoso.
¿Cómo se guardan datos persistentes en Kubernetes?
Montando una PersistentVolumeClaim en el pod, que queda vinculada a un PersistentVolume real (un disco de nube, un share NFS) con una vida independiente del pod. El pod referencia la PVC en su sección volumes y la monta en un path con volumeMounts, así los datos sobreviven aunque el pod se borre.
¿Qué es una NetworkPolicy y por qué es necesaria por defecto?
Una NetworkPolicy es un recurso que define qué tráfico de red puede entrar o salir de un grupo de pods, según la documentación oficial de Kubernetes. Es necesaria porque sin ella todos los pods de un cluster pueden hablar entre sí sin restricción, lo que significa que un pod comprometido puede conectarse directo a bases de datos u otros servicios internos.
¿Qué diferencia hay entre ClusterIP, NodePort y LoadBalancer?
ClusterIP solo es alcanzable dentro del cluster y sirve para comunicación interna entre servicios. NodePort abre un puerto fijo en cada nodo (rango 30000-32767) pensado para labs o detrás de un balanceador propio. LoadBalancer provisiona una IP pública en la nube, con un costo aproximado de USD 18 a 25 por mes por IP en los proveedores grandes.
¿Cuánto cuesta un disco persistente en Azure o AWS?
Un disco de 128 GiB en Azure va de USD 5,89 al mes (Standard HDD S10) a USD 19,71 (Premium SSD P10), según el nivel de performance. En AWS, un volumen EBS gp3 equivalente de 128 GB cuesta alrededor de USD 10,24 al mes, con 3.000 IOPS incluidas.
Conclusión
Los dos incidentes de Contoso no fueron bugs de Kubernetes: fueron consecuencia de tratar un pod como si fuera una VM, con IP fija y disco permanente. Lo que cambia la ecuación es barato: un PersistentVolumeClaim de USD 9,60 al mes y hablar por nombre DNS en vez de IP hardcodeada hubieran evitado tanto los 1.240 archivos perdidos como los 35 minutos de checkout caído.
Si administrás un cluster propio, el checklist es corto: nada de IPs de pod en configs, una NetworkPolicy default-deny con egress a DNS confirmada contra el CNI real que usás, y cada path que la app escribe montado como PVC. Correr la verificación de la última sección después de cada upgrade del cluster no cuesta nada y evita la sorpresa del próximo lunes.