LSM-Tree: por qué escribe más rápido que un B-Tree
En pocas palabras: Las bases con muchas escrituras usan LSM-Trees porque nunca modifican el disco en el lugar: guardan cada escritura en una MemTable en RAM y la vuelcan como SSTable inmutable, de forma secuencial. Así evitan la amplificación de escritura de 160x a 320x de los B-Trees.
Una base de datos con LSM-Tree escribe rápido porque nunca modifica el disco en el lugar: recibe cada escritura en memoria, la ordena y la vuelca como archivo inmutable en forma secuencial. RocksDB, Cassandra, ScyllaDB, ClickHouse, TiKV y BadgerDB funcionan así, según un artículo técnico publicado el 7 de octubre de 2026.
El LSM-Tree (Log-Structured Merge-Tree) es una estructura de almacenamiento que trata escrituras, actualizaciones y borrados como agregados secuenciales a archivos inmutables. Se usa en bases de datos con ingesta intensiva, como telemetría, logs de transacciones, métricas y colas de eventos. Su diseño original salió en 1996 en un paper de la revista Acta Informatica, así que no es una novedad de 2026.
En este artículo:
- En 30 segundos
- ¿Por qué los B-Trees se complican con muchas escrituras por segundo?
- ¿Cómo guarda una escritura un LSM-Tree en una base de datos?
- ¿Qué es un SSTable y cómo evitan los Bloom filters leer decenas de archivos?
- ¿Qué es la compactación y por qué borrar datos aumenta el espacio en disco?
- ¿Cuándo conviene un LSM-Tree y cuándo un B-Tree?
- Errores comunes con motores LSM
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El problema del B-Tree: para cambiar 50 bytes reescribe una página de 8 a 16 KB, una amplificación de escritura de 160x a 320x según la fuente.
- La escritura en LSM: se agrega al WAL en disco y a la MemTable en RAM, que se vuelca como SSTable al llegar a unos 64 o 128 MB.
- La lectura: los Bloom filters descartan archivos sin tocar el disco; con 10 bits por clave, la fuente habla de menos de 1% de falsos positivos.
- El borrado: un DELETE agrega un tombstone, así que el disco crece hasta que la compactación elimina los datos viejos.
¿Por qué los B-Trees se complican con muchas escrituras por segundo?
Un B-Tree actualiza en el lugar: para cambiar un registro de 50 bytes, el motor reescribe la página completa de 8 o 16 KB en su posición física. Según la fuente, eso equivale a una amplificación de escritura de 160x a 320x, y además genera I/O aleatorio.
El flujo es siempre el mismo. El motor recorre el árbol hasta la página con la clave, la modifica en el buffer pool, la marca como dirty y un proceso de fondo la escribe de vuelta. PostgreSQL, MySQL InnoDB y SQLite siguen este modelo.
El segundo problema está más abajo. Un SSD no sobrescribe bytes: borra bloques NAND enteros (la fuente los ubica entre 2 y 8 MB) y el Flash Translation Layer hace garbage collection sin parar cuando las escrituras caen dispersas.
Ojo con un detalle: los 50.000 registros por segundo que menciona la fuente son un escenario ilustrativo, no un benchmark medido. Sirven para ver el orden de magnitud del problema, no para dimensionar tu infraestructura.
Y el B-Tree no es el villano. Cada clave vive en una sola página predecible, y por eso leer es simple.
¿Cómo guarda una escritura un LSM-Tree en una base de datos?
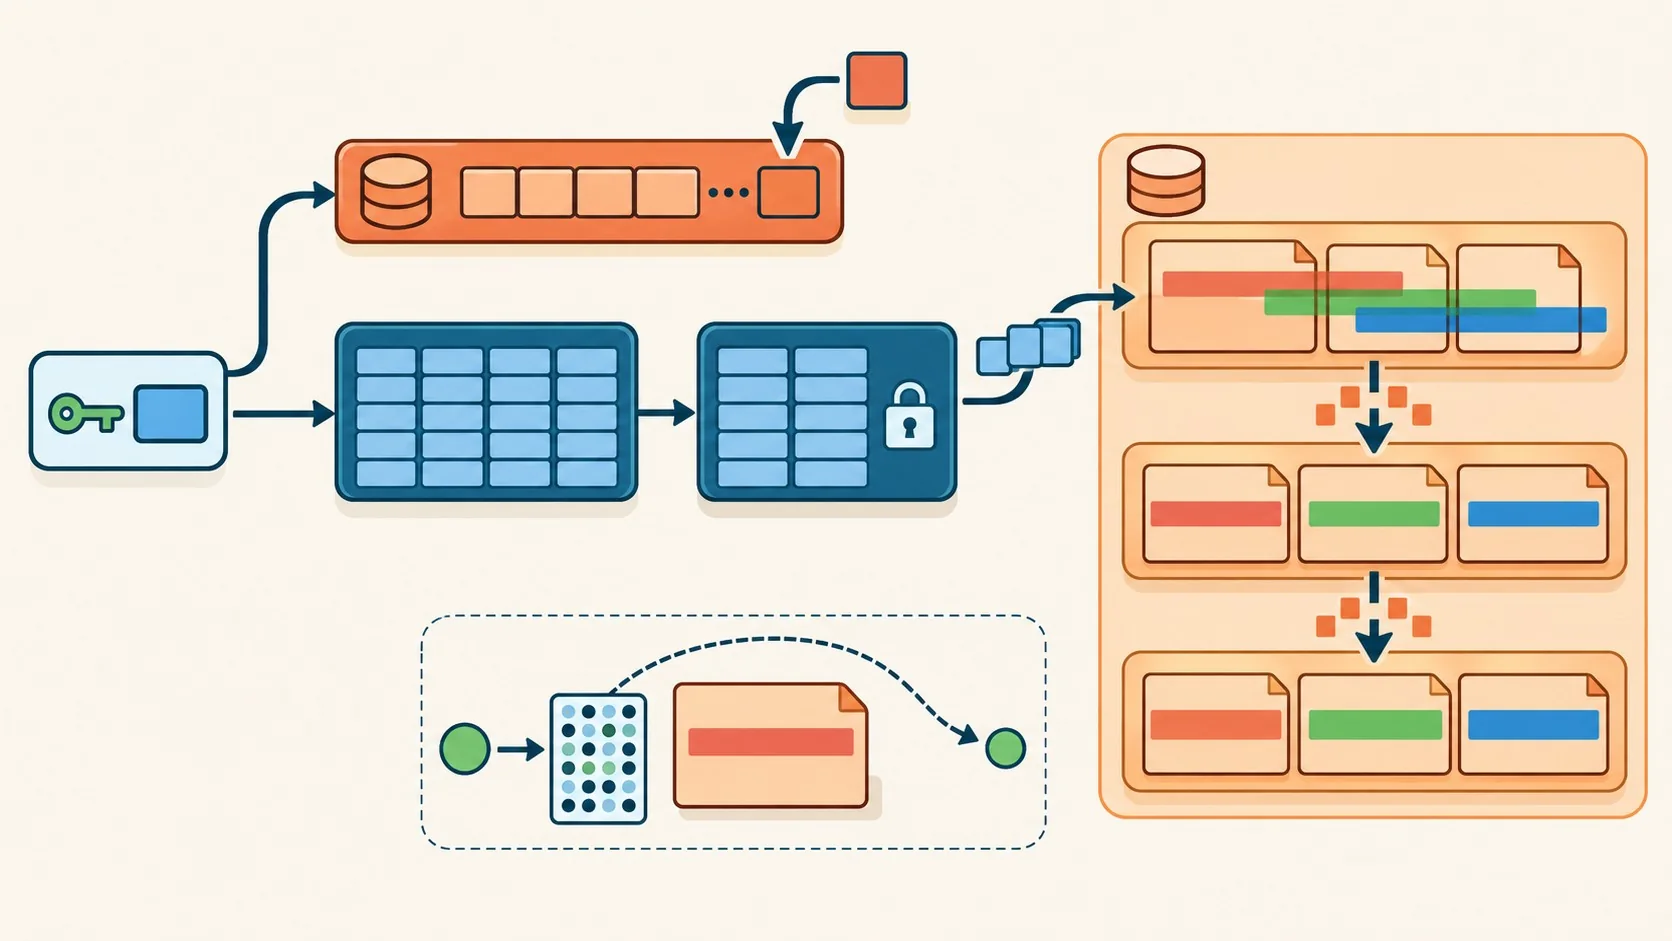
Un LSM-Tree guarda cada escritura en tres pasos: la agrega al Write-Ahead Log (WAL) en disco, la inserta en la MemTable ordenada en RAM y responde al cliente. No toca ninguna página existente. El volcado a disco ocurre después, en segundo plano. En un cliente nativo para explorar bases de datos en Mac profundizamos sobre esto.
- Append al WAL: escritura secuencial en un log de solo agregado, que protege los datos si se cae el proceso antes del volcado.
- Inserción en la MemTable: un buffer ordenado en memoria.
- Respuesta al cliente: sin buscar páginas, sin reescribir bloques y sin bloquear nodos de un árbol.
Una aclaración sobre la fuente: dice que el WAL garantiza la durabilidad de ACID. Eso depende de cuándo el motor fuerza el fsync. Si confirma antes de forzarlo, una caída del sistema puede perder las últimas operaciones. Revisá esa política en tu motor antes de dar la durabilidad por hecha.
¿Qué es una MemTable y por qué suele ser una SkipList?
Una MemTable es un buffer en memoria que guarda las escrituras recientes con las claves siempre ordenadas. RocksDB y LevelDB la implementan como SkipList, porque un árbol rojo-negro necesita rotaciones y rebalanceos que bloquean partes del árbol y estorban la concurrencia.
La SkipList usa listas enlazadas probabilísticas con punteros atómicos CAS (Compare-And-Swap), de modo que varios hilos de lectura y escritura trabajan sin un mutex global. Cuando la MemTable llega al umbral de write_buffer_size (típicamente 64 o 128 MB), pasa a inmutable y el motor crea una vacía.
La secuencia completa, tal como la describe la fuente, es esta: llenás la MemTable, pasa a inmutable, un hilo de fondo empieza a volcarla, las escrituras nuevas entran a la MemTable vacía sin pausa, nadie espera a nadie y recién cuando termina el flush aparece el SSTable en el nivel L0.
¿Qué es un SSTable y cómo evitan los Bloom filters leer decenas de archivos?
Un SSTable (Sorted String Table) es un archivo ordenado e inmutable en disco, que se escribe de una sola pasada desde una MemTable. Un Bloom filter es una estructura probabilística en RAM que dice si una clave definitivamente no está en ese archivo, y así el motor lo saltea sin hacer I/O.
Según la fuente, un SSTable se organiza en bloques:
- Data blocks: chunks de 4 a 64 KB con pares clave-valor ordenados, comprimidos con ZSTD o Snappy.
- Filter block: el Bloom filter de todas las claves del archivo.
- Index block: la clave inicial de cada data block y su offset.
- Footer: punteros al índice y al filtro.
Para leer una clave, el motor hace búsqueda binaria en el índice y descomprime un solo bloque. Más contexto en errores de CI guardados en una base consultable.
¿Cómo ayuda un Bloom filter a leer más rápido?
Al volcar el SSTable, cada clave pasa por k funciones hash que marcan k bits de un arreglo. Al buscar, si algún bit está en 0, la clave no existe en ese archivo. Si todos están en 1, la clave puede estar y recién ahí se lee el índice.
Con unos 10 bits por clave, la fuente afirma que los falsos positivos quedan por debajo de 1%. Es un dato de divulgación, no una medición propia, y vale para su configuración.
¿En qué orden busca un LSM-Tree una clave?
Busca de lo más nuevo a lo más viejo y se detiene en el primer resultado. Tomemos un GET(“order_883”), ejemplo ilustrativo basado en el esquema de la fuente:
- MemTable activa e inmutables: si la clave está ahí, es la escritura más reciente.
- Nivel L0: los archivos son volcados directos de MemTables y sus rangos se solapan, así que se revisan los filtros de más nuevo a más viejo.
- Niveles L1 a LN: los rangos no se solapan, por lo que una búsqueda binaria entre archivos deja un único candidato por nivel.
¿Qué es la compactación y por qué borrar datos aumenta el espacio en disco?
Borrar en un LSM-Tree no elimina nada: agrega un tombstone, un registro nuevo con marca de borrado. Por eso el uso de disco sube en vez de bajar. Los valores viejos recién desaparecen cuando la compactación fusiona los niveles mediante un merge sort multi-vía.
Según la fuente, borrar un millón de filas aumenta de inmediato el uso de disco. Una lectura encuentra primero el tombstone en el SSTable más nuevo y devuelve “no encontrado”, pero las versiones anteriores siguen físicamente en archivos más viejos.
La compactación resuelve tres problemas: el espacio ocupado por versiones obsoletas y tombstones vencidos, las lecturas lentas por buscar en muchos SSTables y la acumulación de archivos en L0. En el esquema de la fuente, L0 se compacta hacia L1, que ya tiene rangos sin solapamiento, y L1 hacia L2. Complementá con por qué una GPU perdió contra la CPU.
El texto de dev.to se corta justo en este punto, así que no trae cifras de amplificación de lectura, escritura o espacio, y no las vamos a inventar. Para el detalle, la wiki de RocksDB sobre compactación y la de leveled compaction, que es el estilo por defecto, son el lugar correcto.
Una propuesta editorial para verificarlo vos (no sale de la fuente y no la ejecutamos): cargá un conjunto de claves en un RocksDB de prueba, medí el tamaño del directorio de datos, borrá todas las claves y medí de nuevo. Después forzá una compactación manual y medí por tercera vez. Si el tamaño no baja hasta ese último paso, viste el tombstone en acción. En Cassandra, revisá además el parámetro gc_grace_seconds de tu versión, que condiciona cuándo se purgan los tombstones. Cobertura relacionada: cómo proteger la base de datos de WordPress.
¿Cuándo conviene un LSM-Tree y cuándo un B-Tree?
El LSM-Tree conviene cuando la carga está dominada por escrituras, como telemetría, logs de transacciones, métricas o colas de eventos. El B-Tree conviene cuando importa que cada clave viva en una página predecible y que la lectura sea directa. Cada uno cobra su costo en otro lado.
| Aspecto | B-Tree | LSM-Tree |
|---|---|---|
| Escritura | Actualización en el lugar: reescribe la página entera | Agregados secuenciales a archivos inmutables |
| Lectura | Cada clave en una página predecible | MemTable y luego L0 a LN; los Bloom filters descartan archivos |
| Borrado | Misma mecánica de actualización en el lugar | Tombstone; el espacio se libera al compactar |
| Trabajo de fondo | Flush de páginas dirty y checkpoints | Flush de MemTables y compactación |
| Ejemplos (según la fuente) | PostgreSQL, MySQL InnoDB, SQLite | RocksDB, Cassandra, ScyllaDB, ClickHouse, TiKV, BadgerDB |
Mi lectura: si tu aplicación es un CRUD con mayoría de lecturas, migrar a LSM “porque escala” es comprarte deuda de compactación sin necesitarla. La fuente no incluye benchmarks comparativos, es un post técnico de divulgación, así que no alcanza para decidir. Lo que sí permite es saber qué medir: proporción de escrituras, crecimiento del disco tras borrados masivos y latencia de lectura mientras corre la compactación.
Errores comunes con motores LSM
- Esperar que un DELETE libere espacio al instante. Agrega un tombstone y el espacio vuelve con la compactación. Si necesitás liberar disco, planificá la compactación (o una manual).
- Dar por hecha la durabilidad porque existe el WAL. Depende de la política de fsync. Verificá cuándo confirma tu motor.
- Tomar las cifras de la fuente como benchmark. El 160x a 320x sale de dividir páginas de 8 o 16 KB por un registro de 50 bytes, y los 50.000 registros por segundo son ilustrativos.
- Leer un “sí” del Bloom filter como confirmación. Significa “puede estar”. Hay falsos positivos y el motor igual tiene que leer el bloque.
Preguntas Frecuentes
¿Qué es un LSM-Tree y para qué sirve?
Un LSM-Tree es una estructura de almacenamiento que convierte todas las escrituras en agregados secuenciales a archivos inmutables. Sirve para bases de datos con ingesta masiva de escrituras, como RocksDB, Cassandra o ScyllaDB.
¿Por qué un LSM-Tree escribe más rápido que un B-Tree?
Porque no reescribe páginas enteras en posiciones aleatorias del disco. Acumula las escrituras en una MemTable ordenada y las vuelca de forma secuencial, evitando la amplificación de 160x a 320x que la fuente atribuye al B-Tree.
¿Qué es un SSTable?
Un SSTable (Sorted String Table) es un archivo ordenado e inmutable en disco que se genera al volcar una MemTable. Tiene data blocks, un filter block con el Bloom filter, un index block y un footer, y solo se elimina durante la compactación.
¿Cómo ayuda un Bloom filter a leer más rápido en una base de datos?
Descarta archivos sin tocar el disco: si algún bit consultado está en 0, la clave no está en ese SSTable. Con unos 10 bits por clave, la fuente indica una tasa de falsos positivos menor a 1%.
¿Por qué borrar datos en Cassandra o RocksDB no libera espacio de inmediato?
Porque los SSTables son inmutables y el borrado se escribe como un tombstone nuevo. Las versiones viejas se eliminan cuando la compactación fusiona los niveles, no en el momento del DELETE.
Conclusión
El LSM-Tree cambia escrituras aleatorias costosas por escrituras secuenciales baratas, y paga la diferencia con compactación y lecturas en varios niveles. Nada de eso es nuevo (el paper es de 1996), pero sigue siendo la base de varios motores muy usados. Antes de elegir, medí tu proporción de escrituras, verificá la política de fsync y probá cuánto disco recuperás después de un borrado masivo y una compactación. Con esos tres datos decidís mejor que con cualquier tabla de divulgación.