Migrar a Azure Database for PostgreSQL: guía técnica 2026
En pocas palabras: Se migra a Azure Database for PostgreSQL con downtime de segundos usando replicación lógica en vez de pg_dump/pg_restore: se publican los cambios desde el origen, se sincroniza el destino y se corta la conexión recién cuando el lag llega a cero.
Migrar una base de datos productiva a Azure Database for PostgreSQL sin voltear la aplicación es un problema resuelto desde hace rato, pero casi nadie lo hace bien a la primera. Según un tutorial técnico publicado el 17 de septiembre de 2026 en dev.to, la diferencia entre horas de downtime y segundos de corte pasa por un solo mecanismo: el write-ahead log (WAL) de PostgreSQL, usado para replicación, backup y recuperación ante fallos.
Azure Database for PostgreSQL Flexible Server es el servicio administrado de Microsoft para bases PostgreSQL en la nube, con alta disponibilidad zone-redundant o same-zone, réplicas de lectura, point-in-time restore y autenticación con Microsoft Entra en vez de contraseña estática. Todo el servicio corre sobre el WAL: el registro de cada cambio que PostgreSQL escribe antes de tocar el disco.
En este artículo:
- En 30 segundos
- ¿Qué método de migración conviene según el downtime que podés tolerar?
- Cómo migrar con pg_dump y pg_restore
- Cómo migrar con downtime casi cero usando replicación lógica
- Cómo configurar alta disponibilidad zone-redundant o same-zone
- Réplicas de lectura vs alta disponibilidad: no son lo mismo
- Cómo funcionan los backups y el restore a un punto en el tiempo
- Cómo detectar y resolver una query lenta en PostgreSQL
- Cómo asegurar el acceso: identidad y red en Azure PostgreSQL
- Errores comunes al migrar y configurar Azure Database for PostgreSQL
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- La replicación lógica reduce el downtime de migración a segundos, contra minutos u horas con pg_dump/pg_restore.
- Azure Database for PostgreSQL Flexible Server tiene HA zone-redundant (protege contra caída de zona) y same-zone (menor latencia, sin esa protección).
- El backup con retención configurable de 7 a 35 días funciona independiente de la alta disponibilidad.
- Un índice creado con
CREATE INDEX CONCURRENTLYbajó una query de 892 ms a 0.058 ms en el caso documentado por la fuente. - La autenticación con Microsoft Entra reemplaza la contraseña estática para conectarse a la base.
¿Qué método de migración conviene según el downtime que podés tolerar?
Depende de cuánto downtime bancás. Si tenés una base chica y una ventana de mantenimiento posible, pg_dump/pg_restore alcanza. Si necesitás cortar producción por segundos, no minutos, la única opción real es replicación lógica.
Azure Database Migration Service en modo offline queda en el medio: es un servicio “gestionado” (Azure te saca el trabajo manual de encima), pero el tiempo de corte termina siendo parecido al de un pg_dump normal, según el tutorial de dev.to. No resuelve el problema del downtime, solo te ahorra escribir los comandos.
| Método | Downtime | Para qué sirve |
|---|---|---|
| pg_dump / pg_restore | Minutos a horas, según el tamaño | Bases chicas, ventana de mantenimiento aceptable |
| Azure Database Migration Service (offline) | Similar a pg_dump, pero gestionado | Bases medianas, se quiere un job administrado |
| Replicación lógica | Segundos (solo el cutover) | Producción donde el downtime extendido no es opción |
Lo que la fuente no aclara, y que conviene tener presente: la replicación lógica exige que el esquema ya exista en destino (se crea antes con un pg_dump --schema-only) y que cada tabla tenga clave primaria, porque sin eso la sincronización de updates y deletes no funciona bien. Ese detalle no aparece en ningún lado hasta que te explota en medio de la migración.
Cómo migrar con pg_dump y pg_restore
El comando base es pg_dump -Fc contra el servidor origen y pg_restore --no-owner --no-acl contra el destino. El formato custom (-Fc) conviene por sobre SQL plano porque viene comprimido, permite restore paralelo con -j 4 y deja restaurar una sola tabla sin volver a correr todo el dump.
--no-owner --no-acl saca del dump los roles y permisos que probablemente no existen igual en destino. Sin esas flags, el restore se corta apenas encuentra un rol que falta. Después se definen los permisos a mano, en el destino, con los roles que corresponden. Para más detalles técnicos, mirá certificaciones de Azure según tu rol.
Cómo migrar con downtime casi cero usando replicación lógica
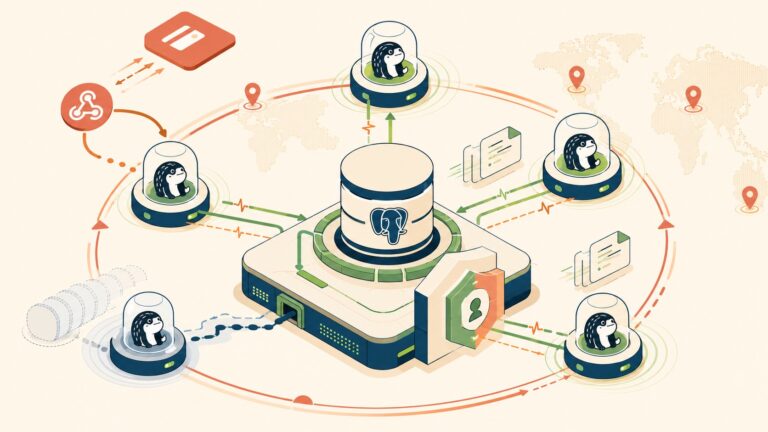
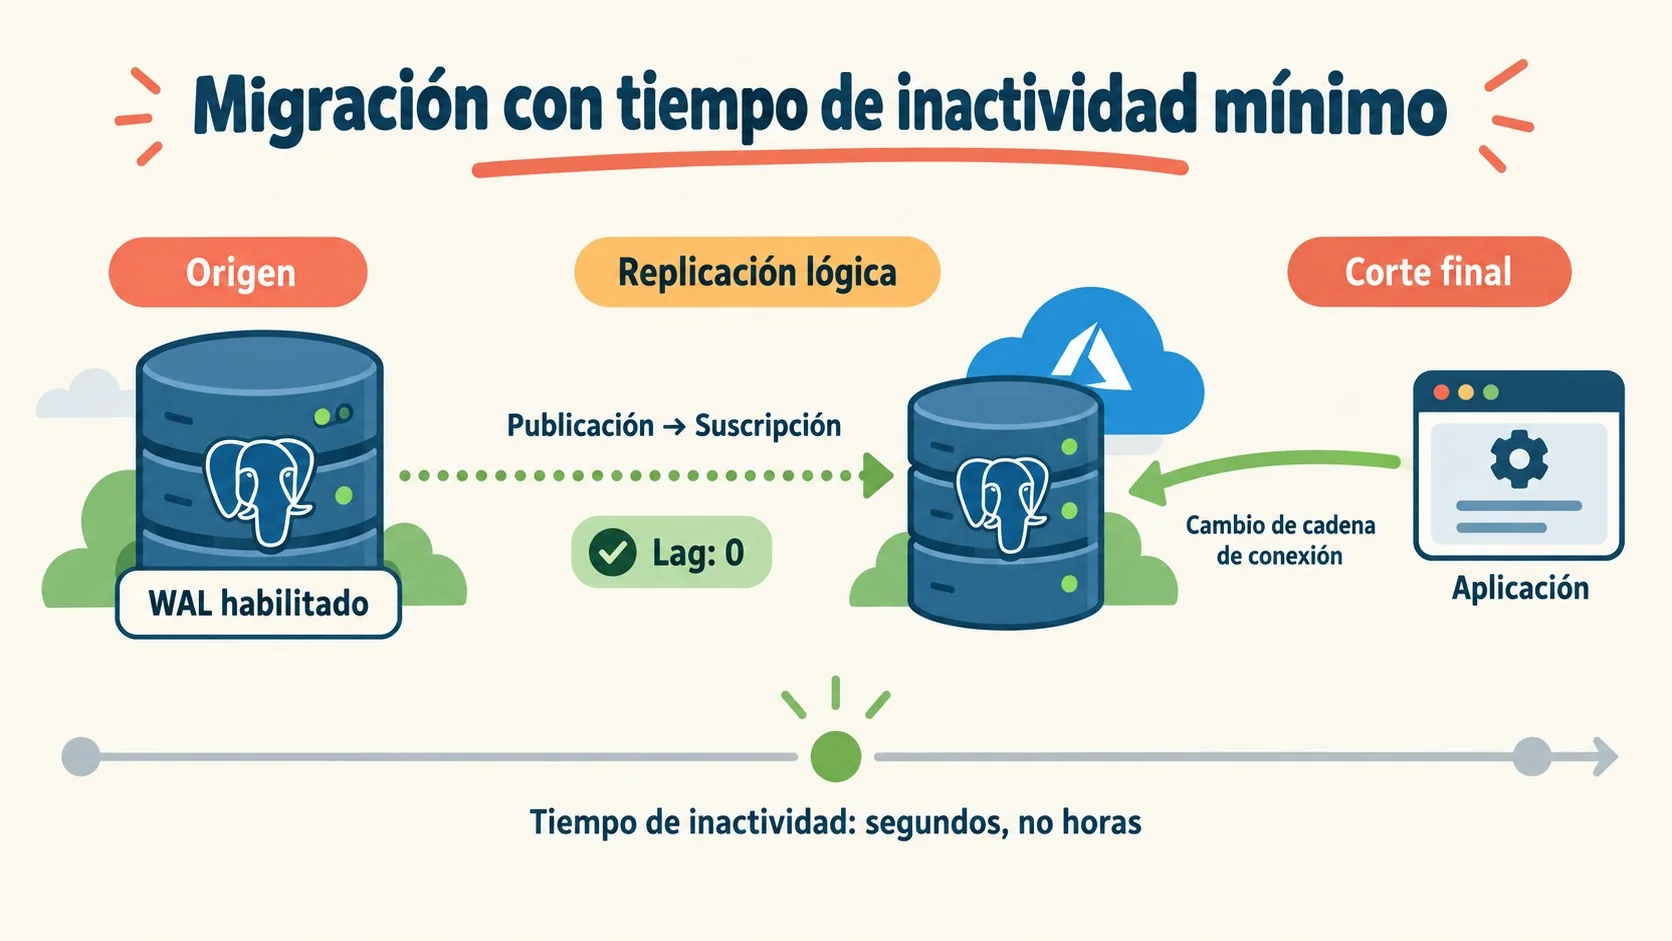
El mecanismo es simple: el servidor origen publica cambios, el destino se suscribe, se mantienen sincronizados el tiempo que haga falta y recién ahí se corta. Primero se activa wal_level = logical en el origen (requiere reinicio), después se crea la publicación con CREATE PUBLICATION migration_pub FOR ALL TABLES y en destino la suscripción con CREATE SUBSCRIPTION apuntando a esa conexión.
El lag se mira con una query sobre pg_replication_slots, comparando el LSN actual contra el restart_lsn. Cuando ese lag llega a cero, ahí es el momento: cambiás el connection string de la aplicación, verificás que las escrituras nuevas caigan en el destino y recién después borrás la suscripción. Subís el esquema, activás la publicación, esperás que el lag baje, probás que todo escriba donde tiene que escribir, cambiás la cadena de conexión y listo, con el corte real limitado a lo que tarda ese último paso (segundos, no horas).
Cómo configurar alta disponibilidad zone-redundant o same-zone
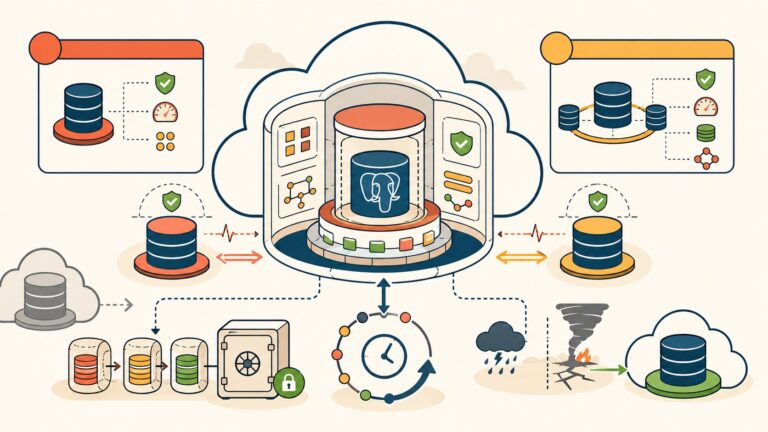
Zone-redundant pone el standby en una zona de disponibilidad distinta a la del primario; same-zone lo pone en la misma zona. La diferencia es simple: zone-redundant sobrevive a una caída completa de zona pero agrega latencia de red entre zonas en cada commit, porque el primario espera la confirmación del standby antes de reconocer la escritura.
El comando es az postgres flexible-server update --zonal-resiliency Enabled --standby-zone 2. Sin el flag --allow-same-zone el standby cae en zona distinta (zone-redundant); con ese flag, se fuerza same-zone. El failover es automático: si el primario deja de responder, el standby se promueve solo y el DNS apunta ahí.
Un criterio simple para verificar esto en tu propio entorno: antes de dar por buena la configuración, corré un failover forzado en un servidor que no sea producción (az postgres flexible-server restart --failover Forced) y cronometrá el tiempo real hasta que la app vuelve a responder, en vez de confiar en el SLA publicado. El número documentado y el que te va a tocar en tu región, con tu tráfico, no siempre coinciden. Sobre eso hablamos en otros servicios de almacenamiento en Azure.
Réplicas de lectura vs alta disponibilidad: no son lo mismo
Una réplica de lectura es una copia asincrónica, separada de la HA, pensada para sacarle carga de lecturas al primario (reportes, analytics), no para reemplazar la alta disponibilidad. La diferencia clave: al ser asincrónica, la réplica puede atrasarse y no garantiza tener el último dato confirmado.
Se crea con az postgres flexible-server replica create --source-server pg-prod-primary. Las conexiones de reporting apuntan al hostname propio de la réplica; las escrituras de la app siguen yendo al primario. ¿Qué pasa si la réplica se atrasa sin que nadie lo note? El reporte del lunes muestra datos del viernes, y nadie se entera hasta que el número no cierra. Por eso conviene monitorear el lag con now() - pg_last_xact_replay_timestamp().
Cómo funcionan los backups y el restore a un punto en el tiempo
Los backups protegen contra un error humano (un DELETE mal escrito, una migración que salió mal), algo que la alta disponibilidad no cubre porque replicaría ese mismo error al standby sin chistar. El backup geo-redundante solo se define al crear el servidor, no hay un flag de update para activarlo después.
La retención sí es editable en cualquier momento, entre 7 y 35 días, con az postgres flexible-server update --backup-retention 35. Si nunca activaste geo-redundancia, la salida es un geo-restore hacia un servidor nuevo (que puede quedar en otra región), no un toggle in-place. El point-in-time restore usa az postgres flexible-server restore --restore-time con una marca de tiempo exacta, y siempre crea un servidor nuevo en vez de pisar el original (spoiler: eso significa que después hay que verificar a mano que el dato restaurado es el correcto antes de repuntar nada).
Cómo detectar y resolver una query lenta en PostgreSQL
Ponele que un reporte que antes tardaba dos segundos ahora tarda un minuto entero. La respuesta está en EXPLAIN ANALYZE: en el caso documentado, un Seq Scan sobre la tabla orders filtrando por customer_email recorría 1.239.988 filas para encontrar 12, con un tiempo de ejecución de 892.201 ms. Relacionado: el crecimiento de la nube de Microsoft.
La solución fue un índice: CREATE INDEX CONCURRENTLY idx_orders_customer_email ON orders (customer_email). El flag CONCURRENTLY construye el índice sin bloquear escrituras, más lento de crear pero sin frenar tráfico productivo. El resultado después del índice: 0.058 ms de ejecución, contra los 892 ms de antes. Mismo tipo de bug, mismo tipo de arreglo, el clásico de siempre.
Para el problema de las conexiones, Flexible Server trae PgBouncer integrado. Se activa con az postgres flexible-server parameter set --name pgbouncer.enabled --value true, en vez de dejar que la aplicación abra una conexión cruda por request (el overhead de memoria por conexión inactiva se nota rápido con tráfico real).
Cómo asegurar el acceso: identidad y red en Azure PostgreSQL
La autenticación con Microsoft Entra reemplaza la contraseña estática por un token de acceso, sin credencial de larga vida para filtrar. Se configura con az postgres flexible-server microsoft-entra-admin create apuntando al object-id de un grupo de Entra.
En red, la recomendación es deshabilitar el acceso público con --public-access Disabled y llegar al servidor solo por un Private Endpoint dentro de la VNet. Una base de datos es justo el tipo de recurso que no debería estar expuesto a internet en primer lugar. A nivel de roles, la fuente sugiere crear app_readwrite y reporting_readonly en vez de que todo se conecte con el usuario admin del servidor, algo que suena obvio pero que en la práctica casi nadie hace hasta que audita accesos y encuentra tres aplicaciones distintas usando la misma cuenta.
Errores comunes al migrar y configurar Azure Database for PostgreSQL
- Confiar en el SLA de failover sin medirlo. El tiempo documentado de failover automático no siempre coincide con el que vas a tener en tu configuración específica; probarlo en un entorno de test es la única forma de saber el RTO real.
- Usar réplica de lectura como si fuera HA. La réplica es asincrónica y puede atrasarse; si el primario cae, esa réplica no te salva de perder escrituras recientes.
- Migrar con replicación lógica sin clave primaria en las tablas. Sin clave primaria, la sincronización de updates y deletes no se replica bien, y el problema aparece recién en el cutover.
- Dejar el acceso público habilitado “por las dudas”. Si el servidor no necesita ser accesible desde internet, no debería serlo; el Private Endpoint existe justamente para eso.
- No monitorear el lag de replicación. Un replica silenciosamente atrasada por horas rompe reportes sin que nadie lo note hasta que un número no cierra.
Preguntas Frecuentes
¿Cómo migrar una base de datos PostgreSQL a Azure con downtime mínimo?
Con replicación lógica: activás wal_level=logical en el origen, creás una publicación para todas las tablas, suscribís el destino y esperás a que el lag llegue a cero. El único downtime real es el que tarda el cambio del connection string, típicamente segundos. Complementá con automatizar despliegues con Azure DevOps.
¿Qué diferencia hay entre alta disponibilidad zone-redundant y same-zone en Azure PostgreSQL?
Zone-redundant pone el standby en una zona de disponibilidad distinta, protege ante una caída completa de zona y agrega latencia de red entre zonas en cada commit. Same-zone pone el standby en la misma zona, tiene menor latencia, pero no protege si toda la zona cae.
¿Cómo configurar una réplica de lectura en Azure Database for PostgreSQL?
Se crea con az postgres flexible-server replica create --source-server apuntando al servidor primario. Es una copia asincrónica pensada para reporting y analytics, no un reemplazo de la alta disponibilidad, y conviene monitorear su lag con una query sobre pg_last_xact_replay_timestamp().
¿Cómo hacer un point-in-time restore en Azure PostgreSQL?
Con az postgres flexible-server restore --restore-time indicando la marca de tiempo exacta antes del incidente. El restore siempre crea un servidor nuevo, nunca sobrescribe el original, así que conviene verificar los datos restaurados antes de repuntar cualquier aplicación.
¿Cómo autenticar Azure PostgreSQL con Microsoft Entra en vez de contraseña?
Configurando un administrador de Entra con az postgres flexible-server microsoft-entra-admin create, apuntando al object-id de un grupo. Las conexiones de la aplicación después usan un token de acceso de Entra en vez de una contraseña fija almacenada en algún lado.
Conclusión
Nada de lo que describe la guía es exótico por separado: un plan de migración, un standby, una política de backup, un índice, un endpoint privado. Lo que cambia es tenerlo todo armado desde el arranque en vez de ir parcheando después de un incidente. Si estás por migrar a Azure Database for PostgreSQL, la decisión más importante no es qué comando corrés, es cuánto downtime tu negocio puede bancarse, porque de ahí sale el método, la topología de HA y hasta la política de backup que te conviene.