Cómo kubernetes mantiene apps vivas si un nodo se cae
En pocas palabras: Kubernetes usa heartbeats periódicos del kubelet: si un nodo no responde dentro del node-monitor-grace-period, el Node Controller lo marca NotReady y el ReplicaSet Controller reprograma automáticamente los pods afectados en nodos sanos, sin intervención manual.
Cuando un nodo se cae en un cluster de kubernetes, el control plane no espera que un humano se entere: detecta el fallo por heartbeats vencidos, marca el nodo como NotReady y reprograma los pods afectados en máquinas sanas, según describe el artículo técnico publicado en dev.to el 20 de septiembre de 2026.
Un orquestador de contenedores es un sistema que automatiza el despliegue, el escalado y la recuperación de aplicaciones empaquetadas en contenedores, distribuidas en varios servidores. Kubernetes es el orquestador de código abierto más usado para esa tarea: compara sin parar el estado que vos declarás (cuántas réplicas querés, qué recursos necesita cada una) contra el estado real del cluster, y corrige automáticamente cualquier diferencia.
En este artículo:
- En resumen
- ¿Qué es un orquestador de contenedores y cómo detecta kubernetes que un nodo se cayó?
- Estado deseado vs. estado real: el motor de kubernetes
- Qué componentes forman el control plane de kubernetes
- Cómo decide el scheduler dónde ubicar un pod
- Liveness, readiness y startup probes: cómo kubernetes chequea la salud real de la app
- Ejemplo hipotético: una noche de guardia sin llamados
- Qué pasa con los pods y los volúmenes cuando un nodo muere
- Cómo evita kubernetes el downtime durante una actualización
- Criterios para calibrar maxUnavailable, maxSurge y timeouts de probes
- Requests, limits y autoscaling: cómo kubernetes reparte recursos finitos
- Matriz de fallas comunes en producción
- Qué significa esto para equipos en Latinoamérica
- Errores comunes al operar kubernetes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En resumen
- Kubernetes detecta nodos caídos mediante heartbeats periódicos del kubelet; si no responden dentro del node-monitor-grace-period, el Node Controller marca el nodo como NotReady.
- El control plane compara el estado deseado, definido en manifiestos YAML, contra el estado real del cluster en un loop de reconciliación continuo.
- El scheduler decide dónde correr cada pod en dos fases: filtering (descarta nodos que no cumplen requisitos) y scoring (rankea los que sí sirven).
- Las liveness probes reinician contenedores colgados; las readiness probes sacan pods del balanceador hasta que están listos para recibir tráfico.
- Los rolling updates usan maxUnavailable y maxSurge para actualizar aplicaciones sin downtime, con rollback automático si algo falla.
¿Qué es un orquestador de contenedores y cómo detecta kubernetes que un nodo se cayó?
Un orquestador de contenedores mantiene aplicaciones disponibles pese a fallas de hardware, caídas de nodos y particiones de red, evaluando sin parar el estado deseado contra la realidad del cluster. En kubernetes, cada worker node manda heartbeats periódicos desde el kubelet hacia el API server; si esos heartbeats no llegan dentro del node-monitor-grace-period configurado, el Node Controller marca el nodo como NotReady.
Ponele que estás corriendo un cluster de diez nodos y uno se cae por un kernel panic a las 3 de la mañana. Nadie te despierta con una alerta manual (spoiler: vos ni te enterás hasta la mañana siguiente, si todo salió bien). El sistema ya arrancó el proceso de reemplazo antes de que termines el café.
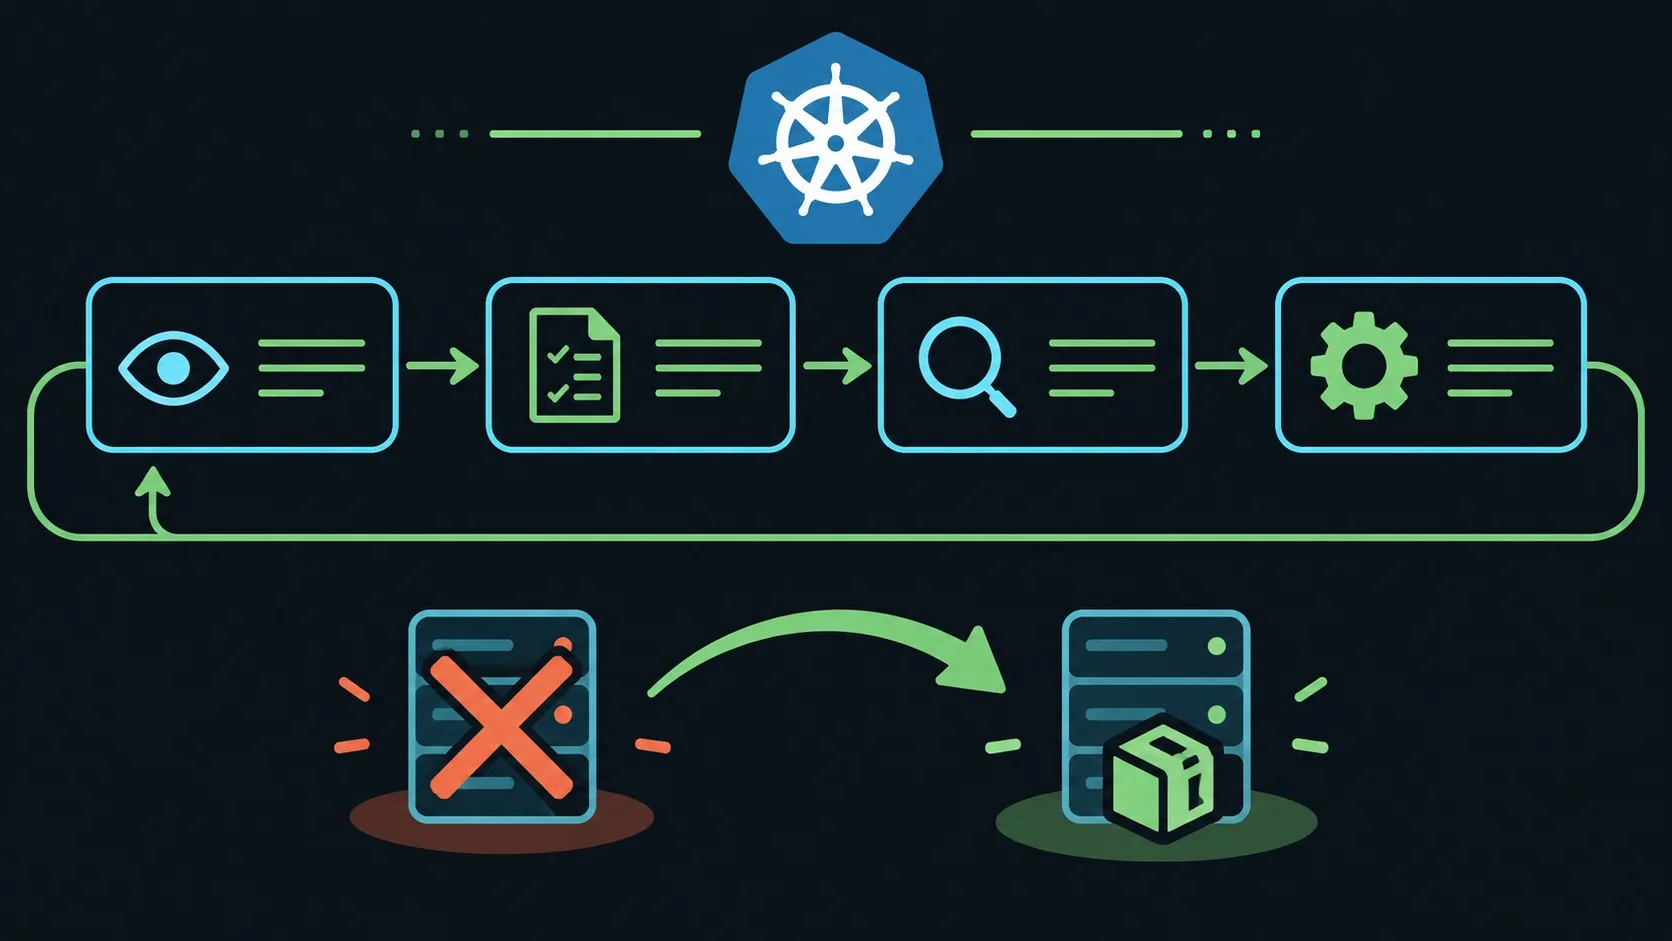
El famoso “self-healing” de kubernetes no es magia. Es un loop que corre cada pocos segundos, evalúa telemetría real y actúa sin pedirte permiso.
Estado deseado vs. estado real: el motor de kubernetes
El corazón de kubernetes es un control loop: en vez de ejecutar comandos puntuales tipo “arrancá tres contenedores ahora”, vos declarás el estado deseado en un manifiesto YAML, por ejemplo un Deployment con tres réplicas, y el control plane lo compara sin parar contra lo que realmente está corriendo en el cluster. Cubrimos ese tema en detalle en un dashboard liviano para gestionar Docker.
Subís el manifiesto, el control plane lo guarda en etcd, el scheduler asigna los pods a nodos disponibles, el kubelet los arranca y desde ese momento el sistema no para de comparar lo que declaraste contra lo que efectivamente hay corriendo, así que si un pod muere, el ReplicaSet Controller lo nota y pide uno nuevo sin que vos toques una tecla. Esa es la diferencia central entre un script imperativo y un orquestador declarativo: el primero ejecuta una vez, el segundo vigila para siempre.
Qué componentes forman el control plane de kubernetes
El control plane de kubernetes tiene cuatro piezas centrales: el API Server, etcd, el scheduler y los controllers. Cada worker node, por su lado, corre kubelet, un container runtime y los plugins de red y storage.
- API Server (kube-apiserver): el front-end central que expone todas las operaciones REST, valida requests y funciona como hub de datos para el resto de los componentes.
- etcd: un key-value store distribuido que implementa el algoritmo de consenso Raft. Ahí vive la fuente de verdad de toda la configuración del cluster.
- kube-scheduler: vigila pods recién creados sin nodo asignado, evalúa requisitos de hardware y elige el mejor worker node según restricciones y afinidad.
- Controllers: loops de control en background (Node Controller, ReplicaSet Controller, EndpointSlice Controller) que empujan el estado actual hacia el estado deseado.
Del lado de los worker nodes, el kubelet registra el nodo ante el API server y monitorea los pods asignados. El container runtime (containerd o CRI-O) descarga imágenes y ejecuta los contenedores usando namespaces y cgroups. Las CNI asignan IPs ruteables a los pods; las CSI adjuntan volúmenes persistentes entre nodos.
Vale la pena marcar por qué se separan así las responsabilidades: si el API Server y el scheduler vivieran en el mismo proceso que decide dónde corren los pods, una sobrecarga de scheduling podría tumbar también la capacidad de leer o escribir estado del cluster. Separar “quién guarda la verdad” (etcd), “quién la expone” (API Server) y “quién decide ubicaciones” (scheduler) es lo que permite que, por ejemplo, el cluster siga aceptando consultas de estado aunque el scheduler esté momentáneamente saturado procesando una ola de pods nuevos.
Cómo decide el scheduler dónde ubicar un pod
El scheduler ubica cada pod en dos fases: primero descarta nodos que no cumplen requisitos mínimos (filtering) y después rankea los que sobreviven ese filtro (scoring). Recién ahí escribe el binding en el API server.
En la fase de filtering, el scheduler chequea si el CPU y la memoria disponibles alcanzan, si los puertos requeridos están libres, y si los taints y tolerations del nodo permiten esa carga. En la fase de scoring entran variables más finas: balance de recursos, image locality (si el nodo ya tiene cacheada la imagen del contenedor, arranca más rápido) y reglas de afinidad o anti-afinidad. El nodo con mejor puntaje gana y ahí el kubelet arranca el contenedor. Sobre eso hablamos en correr contenedores sin depender de Docker.
Liveness, readiness y startup probes: cómo kubernetes chequea la salud real de la app
Un proceso corriendo dentro de un contenedor no garantiza que la app adentro responda. Kubernetes usa tres tipos de probes para verificar eso de forma independiente: liveness, readiness y startup.
¿Y si el proceso está corriendo pero colgado en un deadlock? Ahí entra la liveness probe: si falla repetidas veces por un thread trabado o un memory leak infinito, el kubelet mata el contenedor y lo reinicia. La readiness probe es distinta: determina cuándo el contenedor puede recibir tráfico, y hasta que no devuelve un código de éxito, el orquestador saca la IP del pod de los endpoints del balanceador. La startup probe protege apps de arranque lento: desactiva liveness y readiness hasta que termina la inicialización, así no te mata un proceso que todavía está cargando.
Ejemplo hipotético: una noche de guardia sin llamados
Ejemplo hipotético, sin datos de un incidente real, solo para ilustrar cómo se encadenan los mecanismos descritos arriba.
Imaginá un servicio de checkout con seis réplicas repartidas en tres nodos, dos pods por nodo. A las 3:14 de la mañana, uno de esos nodos pierde conectividad de red por completo. Así se vería la secuencia, pieza por pieza:
- 3:14:00 — El kubelet del nodo caído deja de mandar heartbeats al API Server.
- 3:14:00 a 3:14:40 (aprox.) — El Node Controller espera a que se cumpla el node-monitor-grace-period configurado. Durante esa ventana, el nodo todavía figura como sano en el estado del cluster: es el costo de no reaccionar ante un simple pico de latencia de red.
- Al vencer el grace period — El nodo pasa a NotReady. El ReplicaSet Controller nota que de las seis réplicas declaradas, solo cuatro siguen corriendo en nodos sanos.
- Reprogramación — El scheduler corre su pipeline de filtering y scoring sobre los dos nodos restantes, y si tienen headroom de CPU y memoria, ubica ahí los dos pods faltantes.
- Verificación — Las readiness probes de los pods nuevos tienen que devolver éxito antes de que el balanceador les mande tráfico real. Si el arranque de la app es lento, la startup probe evita que el kubelet los mate antes de tiempo.
El punto que vale la pena remarcar de este ejemplo es que la resiliencia no depende de un solo mecanismo, sino de la cadena completa: si el node-monitor-grace-period estuviera mal calibrado (demasiado corto), un simple pico de latencia dispararía reprogramaciones innecesarias; si estuviera mal calibrado (demasiado largo), el checkout tardaría más de lo tolerable en recuperar capacidad completa. Ese tipo de trade-off aparece una y otra vez en la operación de kubernetes, y es la base de los criterios que siguen.
Qué pasa con los pods y los volúmenes cuando un nodo muere
Cuando el Node Controller marca un nodo como muerto, el ReplicaSet controller nota que la cantidad de réplicas activas cayó por debajo del estado deseado y programa pods de reemplazo en nodos sanos. Para cargas con volúmenes persistentes, el proceso tiene un paso extra: el storage control plane tiene que desmontar el volumen del nodo caído antes de montarlo en el nuevo, para evitar corrupción por split-brain.
Las apps stateless escalan clonando réplicas idénticas. Las apps con estado, como bases de datos o key-value stores distribuidos, necesitan primitivas específicas: Persistent Volume Claims (PVC) para que los datos sobrevivan a un reinicio del contenedor, y StatefulSets para garantizar identificadores de red estables y un mapeo 1:1 entre pod y almacenamiento.
Cómo evita kubernetes el downtime durante una actualización
Kubernetes evita el downtime en actualizaciones reemplazando pods viejos por nuevos de forma incremental, controlado por dos parámetros: maxUnavailable y maxSurge. El primero limita cuántos pods pueden estar offline durante la ventana de actualización; el segundo, cuántos pods extra se pueden crear por encima de la cantidad deseada mientras dura la transición. Relacionado: cómo se comporta el heap de la JVM en microservicios.
Si la imagen nueva falla las readiness probes o tira excepciones persistentes, el orquestador frena el rollout y vuelve a la revisión estable anterior. Eso sí: el rollback no es instantáneo ni mágico, depende de que las probes estén bien configuradas para detectar el problema a tiempo.
Criterios para calibrar maxUnavailable, maxSurge y timeouts de probes
Ni maxUnavailable ni maxSurge ni el node-monitor-grace-period tienen un valor universal correcto: la elección depende de qué es peor para tu servicio, si perder capacidad temporalmente o consumir recursos extra. Algunos criterios que se desprenden directamente de cómo funcionan estos mecanismos:
- Si el servicio no tolera perder ni una réplica (por ejemplo, un servicio con poca cantidad de instancias donde cada una carga bastante tráfico), conviene priorizar maxSurge por sobre maxUnavailable: el cluster arranca pods nuevos antes de apagar los viejos, a costa de necesitar más CPU y memoria disponibles durante el rollout.
- Si el cluster tiene poco margen de recursos y no puede darse el lujo de correr pods extra durante la actualización, hay que aceptar un maxUnavailable mayor y absorber esa reducción temporal de capacidad, siempre que el servicio pueda sostenerla sin degradarse.
- Si la red del cluster es inestable (heartbeats que se pierden ocasionalmente sin que el nodo esté realmente caído), un node-monitor-grace-period corto va a generar reprogramaciones innecesarias de pods sanos. Ese es justamente uno de los errores comunes que se detalla más abajo.
- Si la app tarda en levantar (frameworks con inicialización pesada, cachés que hay que precalentar), el timeout de la readiness probe tiene que ser mayor al tiempo real de arranque; de lo contrario, el pod queda marcado como no listo en un loop permanente aunque esté funcionando bien.
Ninguno de estos ajustes reemplaza al monitoreo real del cluster: son puntos de partida razonables a partir de cómo está diseñado el mecanismo, no valores fijos que sirvan para cualquier carga de trabajo.
Requests, limits y autoscaling: cómo kubernetes reparte recursos finitos
Los recursos de un worker node son finitos, así que kubernetes usa requests y limits para repartirlos entre inquilinos. Los requests son la reserva garantizada que el scheduler considera al ubicar un pod; los limits son el techo duro que impone el kernel vía cgroups.
Si un contenedor supera su límite de memoria, el kernel de Linux dispara el OOM killer y mata el proceso al instante. Si supera el límite de CPU, el kernel lo throttlea, lo que sube la latencia de las requests. Para manejar carga variable sin intervención manual, kubernetes tiene tres capas de autoescalado: el Horizontal Pod Autoscaler (HPA) ajusta la cantidad de réplicas según métricas de CPU o telemetría custom; el Vertical Pod Autoscaler (VPA) modifica los requests y limits de los pods corriendo; y el Cluster Autoscaler provisiona nuevas máquinas virtuales cuando hay pods pendientes que no entran en el cluster actual.
Matriz de fallas comunes en producción
El artículo de dev.to resume las fallas más frecuentes en clusters de producción y cómo se resuelven de forma automática. Estas tres son las más documentadas:
| Modo de falla | Causa raíz | Síntoma principal | Remediación automática |
|---|---|---|---|
| Sobrecarga del scheduler | Alto churn en la API, exceso de pods sin asignar | Cola de pods pendientes creciendo, picos de latencia | Rate limiting, sharding del scheduler, optimización de webhooks |
| Caída del control plane | Agotamiento de I/O de disco en etcd, pérdida de líder | Timeouts del API server, imposibilidad de modificar estado | Recuperación de quorum, escalado del storage, compactación del WAL |
| Falla de nodo | Crash de hardware, kernel panic, falla del hypervisor | Nodo en estado NotReady, heartbeats caídos | Eviction de pods, rescheduling automático |
Qué significa esto para equipos en Latinoamérica
Si tu equipo corre un cluster propio en vez de un servicio gestionado, la resiliencia de kubernetes depende en última instancia de la infraestructura de abajo: disco rápido para etcd, red estable entre nodos, y VPS o servidores dedicados que no se caigan justo cuando el orquestador necesita reprogramar. Para eso, contar con un proveedor de infraestructura confiable en la región, como donweb.com, simplifica bastante el punto de partida antes de meterte con la complejidad de un cluster propio.
Errores comunes al operar kubernetes
- No definir limits de memoria. Sin un límite explícito, un contenedor con un memory leak puede consumir toda la RAM del nodo y arrastrar a otros pods con él antes de que el OOM killer actúe.
- Confundir liveness con readiness. Configurar la misma probe para ambos casos hace que kubernetes reinicie contenedores que en realidad solo necesitaban unos segundos más para calentar, no un restart.
- Tratar apps con estado como stateless. Escalar una base de datos con un Deployment común, sin PVC ni StatefulSet, termina en pérdida de datos apenas un pod se reprograma en otro nodo.
- Ignorar el node-monitor-grace-period por defecto. En clusters con red inestable, un valor de detección demasiado agresivo genera reprogramaciones innecesarias por falsos positivos.
Preguntas Frecuentes
¿Cómo detecta kubernetes que un nodo falló?
Kubernetes detecta la falla cuando el kubelet del nodo deja de mandar heartbeats al API server dentro de la ventana configurada como node-monitor-grace-period. Pasado ese tiempo, el Node Controller marca el nodo como NotReady y arranca el proceso de eviction de los pods afectados.
¿Qué es el control plane de kubernetes?
El control plane es el conjunto de componentes que gobierna el cluster: API Server, etcd, kube-scheduler y los controllers. Se encarga de persistir el estado deseado, decidir dónde corre cada pod y corregir cualquier diferencia con el estado real. Para más detalles técnicos, mirá empaquetar funciones Lambda usando contenedores.
¿Cómo reprograma kubernetes los pods cuando una máquina se cae?
El ReplicaSet controller detecta que la cantidad de réplicas activas bajó del número declarado en el Deployment y crea pods nuevos en nodos sanos. Si había volúmenes persistentes, el storage control plane los desmonta del nodo caído antes de montarlos en el reemplazo.
¿Qué diferencia hay entre liveness probe y readiness probe?
La liveness probe determina cuándo reiniciar un contenedor que quedó colgado o en deadlock. La readiness probe determina cuándo un contenedor puede recibir tráfico: hasta que no responde bien, kubernetes lo saca del balanceador aunque el proceso siga corriendo.
¿Cómo se pronuncia kubernetes?
Se pronuncia “cube-er-NÉ-tis”, con acento en la penúltima sílaba. El nombre viene del griego antiguo y significa timonel o piloto, en referencia a quien dirige un barco, que es justamente la metáfora detrás del logo del timón del proyecto.
Conclusión
Kubernetes no evita que las máquinas fallen. Evita que esa falla se convierta en un incidente que te saque de la cama. La combinación de heartbeats, control loops, probes de salud y rescheduling automático es lo que separa un cluster resiliente de un conjunto de servidores frágiles conectados con suerte.
Si estás por meter kubernetes en producción, la lista de chequeo mínima es corta: definí requests y limits en cada workload, separá bien liveness de readiness, decidí de entrada si tu app es stateful o stateless antes de escribir el primer manifiesto, y calibrá maxUnavailable/maxSurge según qué te duele más, perder capacidad temporal o gastar recursos de más durante el rollout. Esas cuatro decisiones evitan la mayoría de los incidentes que terminan en un post-mortem largo.