Por qué más conexiones a la base NO son más velocidad
En pocas palabras: Subir el pool de conexiones a cientos no acelera Postgres: provoca context switching y lock contention, alarga cada query y, con autoescalado en Kubernetes, puede disparar el error ‘too many clients already’. La solución es usar PgBouncer o AWS RDS Proxy y dimensionar el pool según la fórmula de HikariCP.
Es una lógica habitual en entrevistas de diseño de sistemas y en sesiones de firefighting en producción: si los threads de Hibernate están famélicos de conexiones, subir el pool a 1000 debería significar más paralelismo. En producción pasa lo contrario: el pool de conexiones base de datos gigante provoca context switching y lock contention en Postgres, y si además tenés Kubernetes con autoescalado, podés terminar con el error “FATAL: sorry, too many clients already” y una caída total.
Un pool de conexiones a base de datos es el conjunto de conexiones abiertas y reutilizables que una aplicación mantiene contra su motor de datos, en vez de abrir y cerrar una conexión por cada consulta. Herramientas como HikariCP, PgBouncer o AWS RDS Proxy gestionan ese pool para que las conexiones físicas reales contra Postgres se mantengan bajas y eficientes, aunque la capa de aplicación tenga cientos de hilos pidiendo datos.
En este artículo:
- En 30 segundos
- ¿Por qué agrandar el connection pool empeora la latencia en vez de mejorarla?
- ¿Cómo un pool de conexiones gigante termina generando una cola de pedidos más larga?
- ¿Cómo el autoescalado de Kubernetes puede convertir una lentitud en una caída total?
- Ejemplo hipotético: dimensionar el pool antes de que el HPA haga de las suyas
- ¿Qué es PgBouncer y cómo evita que un pool de conexiones colapse la base?
- ¿Cómo calcular el tamaño ideal del connection pool según el hardware de la base de datos?
- Criterios para decidir si necesitás un proxy, CQRS o ambos
- ¿Qué es CQRS y cómo separar lecturas y escrituras evita saturar el pool principal?
- Errores comunes al dimensionar un pool de conexiones
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un servidor Postgres de 8 cores no procesa más rápido con cientos de conexiones simultáneas: entra en context switching y cache thrashing, según el análisis técnico publicado en Dev.to.
- El escenario descrito muestra 8 pods con 100 conexiones cada uno intentando abrir 800 conexiones contra un límite de max_connections de 200 en Postgres.
- El resultado documentado es el error “FATAL: sorry, too many clients already”, que convierte una lentitud en una caída total.
- La fórmula de HikariCP para dimensionar el pool es Conexiones = (Núcleos × 2) + Spindles efectivos.
- PgBouncer y AWS RDS Proxy multiplexan 800 conexiones de cliente hacia apenas 20 a 30 conexiones físicas reales contra la base.
¿Por qué agrandar el connection pool empeora la latencia en vez de mejorarla?
Porque un servidor de base de datos no tiene paralelismo infinito: tiene cores físicos, y cuando cientos de conexiones compiten por esos cores, la CPU deja de procesar queries y empieza a hacer malabares entre hilos. En un servidor Postgres de 8 cores, meter cientos de conexiones activas no multiplica el trabajo útil, lo entorpece.
Ponele que tenés ese servidor de 8 cores y le mandás cientos de conexiones simultáneas ejecutando queries pesadas. El sistema operativo empieza a gastar sus ciclos de CPU en tres cosas que no procesan nada: context switching entre cientos de hilos compitiendo, lock contention esperando candados a nivel fila o tabla, y cache thrashing, que arruina la localidad de la caché L1/L2 del procesador. Ninguna de esas tres cosas es “trabajo” en el sentido de resolver tu query. Es overhead puro. Sobre eso hablamos en analizar errores a escala con una base consultable por IA.
El mito de la paralelización infinita asume que más conexiones es sinónimo de más throughput. No lo es. Es como pensar que agregar más autos a una avenida de dos carriles la hace más rápida: en algún punto, lo único que lográs es un embotellamiento.
¿Cómo un pool de conexiones gigante termina generando una cola de pedidos más larga?
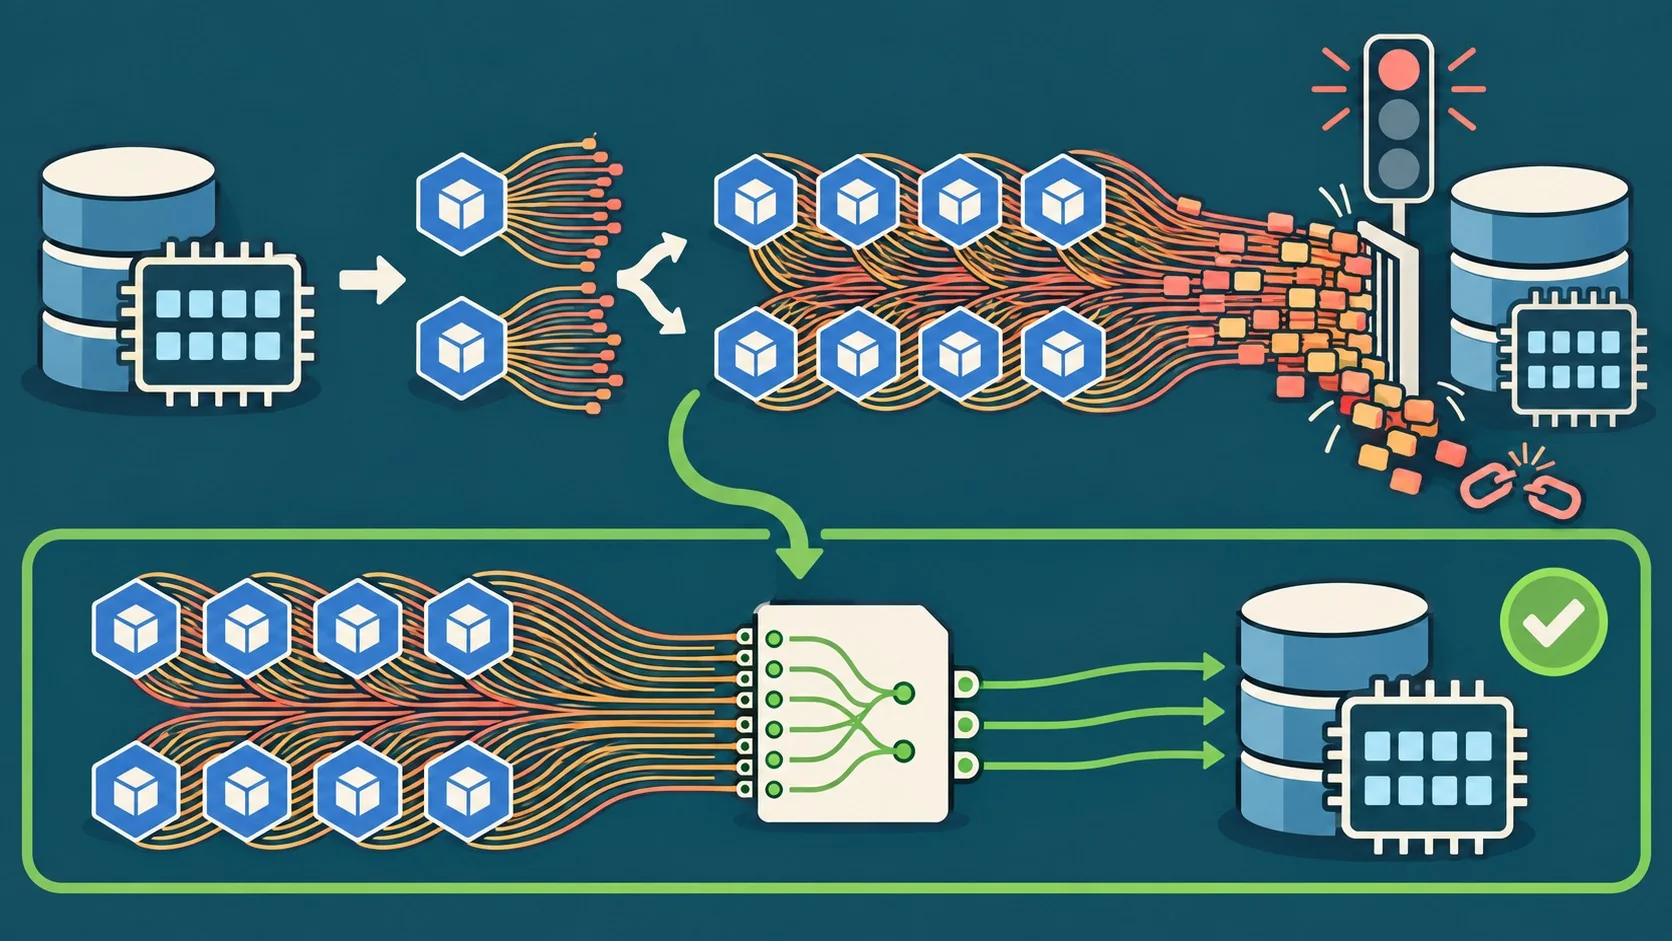
El pool gigante no elimina la cola, la mueve de lugar: en vez de esperar en la base, los pedidos se acumulan en la aplicación mientras cada query tarda más por el thrashing de CPU. Subís el pool, lo probás en un ambiente de staging con poca carga, funciona bárbaro, lo mandás a producción con tráfico real y ahí es donde el context switching empieza a comerse los ciclos de CPU, cada query individual tarda más en terminar, las conexiones quedan ocupadas más tiempo del esperado y las nuevas solicitudes entrantes se amontonan en la cola de la aplicación esperando turno.
¿Aumentaste el throughput real del sistema? No. Lo que hiciste fue convertir una base de datos de alto rendimiento en un embotellamiento con mejor marketing.
- Query individual más lenta: cada consulta compite por CPU en vez de ejecutarse directo.
- Conexión ocupada más tiempo: como la query tarda más, la conexión no se libera para el siguiente pedido.
- Cola de aplicación creciendo: los requests nuevos esperan porque no hay conexiones libres, aunque “en teoría” hay 1000 disponibles.
¿Cómo el autoescalado de Kubernetes puede convertir una lentitud en una caída total?
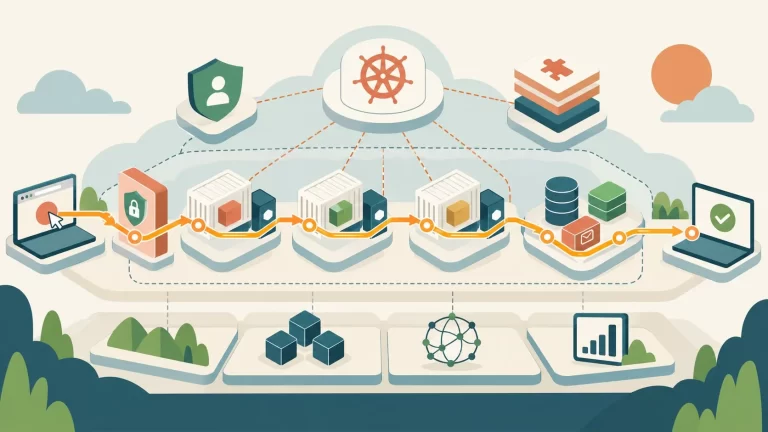
El Horizontal Pod Autoscaler ve latencia alta, interpreta que falta capacidad de cómputo y escala pods, pero cada pod nuevo abre su propio pool de conexiones completo contra la misma base ya saturada. El resultado, según el escenario descrito en el artículo de Dev.to, es una secuencia de eventos bastante concreta.
La base empieza a sufrir el thrashing de CPU que vimos antes. Como las queries tardan más, los tiempos de respuesta de la aplicación se disparan. El HPA detecta esa latencia (o el uso de CPU) en los pods de la app y dispara un scale-out “para salvar el día”, pasando de 2 pods a 8 pods. Si cada pod tiene un pool directo de 100 conexiones, el despliegue completo intenta abrir 800 conexiones de cliente simultáneas (8 pods × 100 conexiones) contra un Postgres configurado con un max_connections de 200. Tema relacionado: centralizar la visibilidad de tus bases multi-cloud.
El autoescalado que debía salvar la aplicación termina siendo el tiro de gracia. Postgres responde con “FATAL: sorry, too many clients already” y el sistema pasa de una lentitud molesta a una caída dura de producción. El tema es que nadie diseñó el pool pensando en el techo de pods máximo, sino en el mínimo cómodo del día a día.
Ejemplo hipotético: dimensionar el pool antes de que el HPA haga de las suyas
Ejemplo hipotético, no corresponde a un caso real reportado por las fuentes: imaginemos un equipo que corre un servicio de checkout sobre un servidor Postgres con 16 cores y disco SSD. Si usan la fórmula de HikariCP y asumen un valor conservador de 1 para los spindles efectivos (típico en SSD, donde el I/O de disco deja de ser el cuello de botella dominante), el cálculo sería:
Conexiones = (16 × 2) + 1 = 33
Ese 33 es el presupuesto total de conexiones físicas que la base puede sostener sin entrar en el thrashing descripto antes. Ahora bien: si el equipo sabe que su HPA puede escalar hasta un máximo de 6 pods en un pico de tráfico, dividir 33 entre 6 pods directos daría apenas 5 o 6 conexiones por pod, un número probablemente insuficiente para absorber picos cortos de latencia dentro de cada instancia.
Ahí es donde, siguiendo la lógica del artículo original, un proxy como PgBouncer cambia la ecuación: en vez de repartir ese presupuesto de 33 conexiones físicas directamente entre los pods, cada pod podría abrir un pool más generoso (digamos, 50 conexiones de cliente) contra el proxy, y el proxy sería el único responsable de mantener ese tope de ~30 conexiones reales contra Postgres, sin importar cuántos pods decida agregar el HPA. El número exacto de spindles efectivos y el tope real de conexiones dependen del hardware concreto de cada equipo; este ejercicio solo ilustra el orden de magnitud del cálculo, no un valor universal.
¿Qué es PgBouncer y cómo evita que un pool de conexiones colapse la base?
PgBouncer es un connection pooler que se para entre tu aplicación y Postgres, y multiplexa cientos de conexiones de cliente hacia un número mucho más chico de conexiones físicas reales contra el motor de base de datos. AWS RDS Proxy cumple el mismo rol para quienes corren en RDS.
Con esta arquitectura, tus 8 pods de Kubernetes pueden abrir tranquilamente 100 conexiones cliente cada uno hacia el proxy (800 en total), mientras PgBouncer multiplexa esas peticiones hacia un pool ajustado de apenas 20 a 30 conexiones físicas reales contra el motor Postgres. La base nunca ve 800 conexiones. Ve las 20 o 30 que puede manejar bien, y el proxy hace de colchón para todo lo demás.
Para microservicios altamente escalables, la recomendación del artículo original es casi categórica: casi nunca conviene conectar esas instancias directamente contra la base de datos principal. El proxy no es un lujo arquitectónico, es la pieza que impide que el autoescalado se transforme en un arma contra tu propia base. Cubrimos ese tema en detalle en versionar los cambios de esquema de forma ordenada.
¿Cómo calcular el tamaño ideal del connection pool según el hardware de la base de datos?
El tamaño del pool se calcula en base al hardware del servidor de base de datos, no a la cantidad de pods que tengas corriendo. La fórmula estándar de la industria, establecida por HikariCP, es: Conexiones = (Núcleos × 2) + Spindles efectivos.
Los spindles efectivos representan la capacidad de I/O de disco subyacente, que varía según uses discos mecánicos o SSD. Esta fórmula marca el punto óptimo donde la base puede procesar tareas en simultáneo antes de que el bloqueo por I/O de disco se transforme en el thrashing destructivo de CPU que vimos más arriba.
Ese presupuesto total de conexiones es un techo global, no un número por pod. Hay que tomarlo y dividirlo con cuidado entre la cantidad máxima esperada de réplicas, nunca al revés. Si calculás primero cuántos pods “querés” tener y después multiplicás por conexiones por pod, terminás con el mismo problema del escenario de Kubernetes: un número que suena razonable por pod, pero que explota cuando el autoescalado hace lo suyo.
Criterios para decidir si necesitás un proxy, CQRS o ambos
No todos los sistemas necesitan las tres soluciones a la vez. Estos son criterios prácticos, derivados de la lógica del artículo original, para decidir dónde conviene empezar:
- Si tu HPA puede escalar a más de 3 o 4 pods y cada pod abre conexiones directas: empezá por el proxy (PgBouncer o RDS Proxy). Es la pieza que absorbe la multiplicación de conexiones antes de que llegue a Postgres, sin importar cuánto escale el autoescalado.
- Si nunca calculaste el pool contra la fórmula de HikariCP: hacelo antes de tocar cualquier otra cosa. Un proxy mal dimensionado por detrás sigue siendo un proxy mal dimensionado; el techo real lo pone el hardware de la base, no la cantidad de pods.
- Si el tráfico de lectura (dashboards, reportes, fetches masivos) y el de escritura compiten por el mismo pool: ahí es donde CQRS, separando réplicas de lectura del pool primario, resuelve algo que ni el proxy ni la fórmula resuelven solos.
- Si el problema es ocasional y el tráfico de lectura no es masivo: probablemente no necesites CQRS todavía. Agregar separación de lecturas y escrituras sin tráfico que lo justifique es complejidad extra sin beneficio claro.
¿Qué es CQRS y cómo separar lecturas y escrituras evita saturar el pool principal?
CQRS, en este contexto, es separar los pools de conexión de lectura y escritura para que el tráfico pesado de consultas no compita con las transacciones críticas de tu base principal. Si tu aplicación necesita de verdad 1000 conexiones paralelas para sostener tráfico de lectura agresivo (dashboards de reporting, fetches masivos de perfiles de usuario), la respuesta no es mandarlas todas al mismo lugar que las escrituras. Ya lo cubrimos antes en asegurarte de que tus backups estén bien protegidos.
- Réplicas de lectura dedicadas: todo el tráfico de consultas pesadas se enruta a un clúster distribuido de read replicas.
- Pool primario liviano: la base de escritura queda con un pool chico, rápido, dedicado exclusivamente a mutaciones de estado.
- Aislamiento de fallas: si el reporting se satura, no arrastra con él a las transacciones críticas de negocio.
Esta separación resuelve algo que ni PgBouncer ni la fórmula de HikariCP resuelven solos: el conflicto entre dos tipos de carga completamente distintos compitiendo por el mismo recurso físico. Cobertura relacionada: reforzar la seguridad de tu base de datos en WordPress.
Errores comunes al dimensionar un pool de conexiones
- Configurar el pool por intuición en vez de por hardware: poner 500 o 1000 porque “suena seguro” en vez de aplicar la fórmula de HikariCP contra los cores reales del servidor.
- Multiplicar el pool por pod sin pensar en el máximo de réplicas: dejar que cada pod tenga 100 conexiones sin calcular qué pasa cuando el HPA escala a 8 o 10 instancias.
- Conectar microservicios directo a Postgres sin proxy: saltarse PgBouncer o RDS Proxy pensando que es “una capa más” innecesaria, cuando es justamente la pieza que absorbe el pico de conexiones de cliente.
- Mezclar tráfico de lectura pesado con el pool transaccional: mandar dashboards de reporting y escrituras críticas al mismo pool, saturando ambos casos de uso al mismo tiempo.
Preguntas Frecuentes
¿Por qué más conexiones a la base de datos no significa más velocidad?
Porque un servidor de base de datos tiene cores físicos limitados, y cuando cientos de conexiones compiten por esos cores, la CPU gasta ciclos en context switching, lock contention y cache thrashing en vez de procesar queries. El resultado es que cada consulta individual tarda más, no menos.
¿Qué es el error “too many clients already” en Postgres?
Es el mensaje que tira Postgres cuando se supera el límite configurado en max_connections. Ocurre típicamente cuando varias réplicas de una aplicación, sumadas, intentan abrir más conexiones simultáneas de las que el motor tiene permitido aceptar, como en el escenario de 800 conexiones contra un límite de 200.
¿Cómo calcular el tamaño correcto de un connection pool?
Se usa la fórmula de HikariCP: Conexiones = (Núcleos × 2) + Spindles efectivos, donde los spindles efectivos reflejan la capacidad de I/O de disco del servidor. Ese número total es el presupuesto global de conexiones, que después se divide entre la cantidad máxima esperada de réplicas.
¿Qué es PgBouncer y para qué sirve?
PgBouncer es un connection pooler que multiplexa cientos de conexiones de cliente hacia un número reducido de conexiones físicas reales contra Postgres. Sirve como buffer entre microservicios escalables y la base de datos, evitando que cada réplica nueva de la aplicación abra conexiones directas contra el motor principal.
¿Por qué el autoescalado de Kubernetes puede tirar abajo mi base de datos?
Porque el Horizontal Pod Autoscaler reacciona a la latencia escalando más pods, y cada pod nuevo suma su propio pool de conexiones completo contra la misma base ya saturada. Si la suma de conexiones de todos los pods supera el max_connections de Postgres, el resultado es una caída total en vez de una mejora.
Conclusión
El dato duro de este caso es simple: un pool de conexiones base de datos más grande no es una base de datos más rápida. Un pool chico, bien dimensionado contra el hardware real, con un proxy multiplexor delante y las lecturas separadas de las escrituras, rinde mejor que un pool gigante peleándose a sí mismo por CPU.
Lo que las fuentes muestran es un escenario técnico concreto: 8 cores, 800 conexiones intentadas, 200 permitidas, un error de Postgres. Lo que no muestran es tu configuración particular, así que antes de tocar max_connections o el tamaño del pool en producción, valdría la pena simular el escenario de autoescalado máximo en un ambiente de staging con carga real, no solo con tráfico liviano. El ejercicio hipotético de más arriba —aplicar la fórmula de HikariCP contra tu propio hardware y dividirla por tu propio techo de réplicas— es un buen punto de partida antes de confiar en que “más conexiones” va a resolver algo.