Rollback de Kubernetes: cuando revertir el pod no alcanza
kubectl rollout undo deployment/orders-api -n production devuelve los Pods a la plantilla anterior. Nada más. No revierte la migración que cambió el esquema, no retira los mensajes que ya están en la cola, no deshace un pago autorizado ni rompe el contrato que otro servicio empezó a usar. Esa distancia entre lo que se cree revertido y lo que efectivamente se revirtió es el eje de un artículo que Pradeep Kandepaneni, ingeniero de plataforma cloud y SRE, publicó el 17 de noviembre de 2026 en AWS Builder Center y replicó en dev.to.
Su ejemplo es reconocible. Una aplicación de pedidos corre como orders-api v1, con esquema v1, evento order-created v1 y un fulfillment-worker v1. La versión 2 agrega un campo no nulo en la base, cambia el payload del evento y despliega un worker nuevo. Todo parece sano durante unos minutos; después la API falla bajo una carga que solo existe en producción. El operador de guardia ejecuta el undo, Kubernetes reemplaza los Pods y vuelve la imagen vieja. Pero la base sigue con el esquema nuevo y con datos escritos por la v2, algunos mensajes ya salieron con el formato nuevo y el worker nuevo pudo haber creado un envío o autorizado un pago. El rollback del Deployment salió bien; la recuperación del servicio, no.
En este artículo:
- ¿Qué revierte kubectl rollout undo y qué deja sin tocar?
- Por qué un rollback de Kubernetes falla con cambios de estado
- ¿Cómo hago un rollback seguro si la release agregó una columna NOT NULL?
- Compatibilidad de esquema no es compatibilidad de datos
- ¿Cómo evito duplicar pagos cuando vuelvo a la versión anterior?
- ¿Cómo pruebo que la versión vieja funciona con los datos nuevos?
- Rollback de tráfico, rollback de estado y backups no son lo mismo
- Fuentes
¿Qué revierte kubectl rollout undo y qué deja sin tocar?
Restaura una revisión anterior del Deployment: imagen, variables, probes, cantidad de réplicas. Deja intacto todo lo que el release cambió fuera de esa plantilla —esquema y datos persistidos, mensajes ya publicados en un broker, mutaciones en APIs de terceros— y no dice nada sobre si el código viejo entiende ese estado nuevo. Es una reversión de imagen, no una estrategia de recuperación.
El mecanismo es acotado y vale conocerlo: kubectl rollout history deployment/orders-api -n production lista las revisiones, kubectl rollout undo deployment/orders-api --to-revision=N permite elegir una en particular y kubectl rollout status confirma que los Pods levantaron. Los tres comandos pueden terminar en verde mientras la integridad de los datos se deteriora, porque ninguno mira la base, la cola ni los sistemas externos. Conviene usarlo cuando el cambio fue solo de código sin estado o cuando el estado nuevo sigue siendo compatible hacia atrás; no alcanza cuando la release escribió algo que la versión anterior no sabe interpretar. Lo explicamos a fondo en nuestra guía práctica para armar charts de Helm.
Por qué un rollback de Kubernetes falla con cambios de estado
La reversibilidad no es una propiedad de la release completa: es la propiedad de su dependencia menos reversible. Antes de discutir automatizaciones, Kandepaneni propone clasificar cada cambio que introduce el despliegue.
| Cambio | Propiedad de recuperación | Riesgo principal |
|---|---|---|
| Código de aplicación sin estado | Casi siempre reversible | Contratos externos modificados |
| Columna aditiva en la base | Compatible si es opcional | Lectores y escritores viejos |
| Renombrar o borrar una columna | Potencialmente rompiente | El código viejo espera el esquema eliminado |
| Reescritura de datos | Reversible de forma condicional | Pérdida de información o ambigüedad |
| Cambio de esquema de eventos | Depende del consumidor | Los mensajes sobreviven al despliegue |
| Efecto secundario en una API externa | Frecuentemente irreversible | Pago, email o mutación en terceros |
| Cambio de identidad de infraestructura | Depende de la semántica del recurso | Reemplazo y retención de datos |
De ahí salen cuatro categorías operativas: reversible (la versión vieja corre segura contra el estado actual), condicionalmente reversible (hace falta una acción documentada de compatibilidad o reparación), solo roll-forward (la conducta anterior no puede operar el estado nuevo) y recuperación manual (alguien tiene que reconciliar efectos o datos). Son insumos de política y cada uno necesita evidencia. La regla de oro: ninguna release es «rollback safe» porque la imagen lo sea; hereda el riesgo de su dependencia menos reversible.
Tampoco es teórico. El autor de un artículo en sre.wang relata un incidente que vivió en un proyecto de ride-hailing: el rollback del Deployment tardó 47 segundos y el servicio tardó 1 hora 23 minutos en recuperarse, porque una migración había cambiado la columna status de varchar(20) a tinyint y el código viejo no reconocía el tipo nuevo.
¿Cómo hago un rollback seguro si la release agregó una columna NOT NULL?
Esa columna condiciona todo. Si es NOT NULL y no tiene valor por defecto, el código anterior no puede insertar filas y el rollback queda bloqueado por la base, no por Kubernetes. Si es opcional o tiene default, la convivencia es posible, pero todavía falta que el código viejo sepa leer los valores nuevos. La salida práctica es no meter cambios destructivos dentro de la ventana de despliegue. Cubrimos ese tema en detalle en cómo KYAML busca reemplazar el YAML.
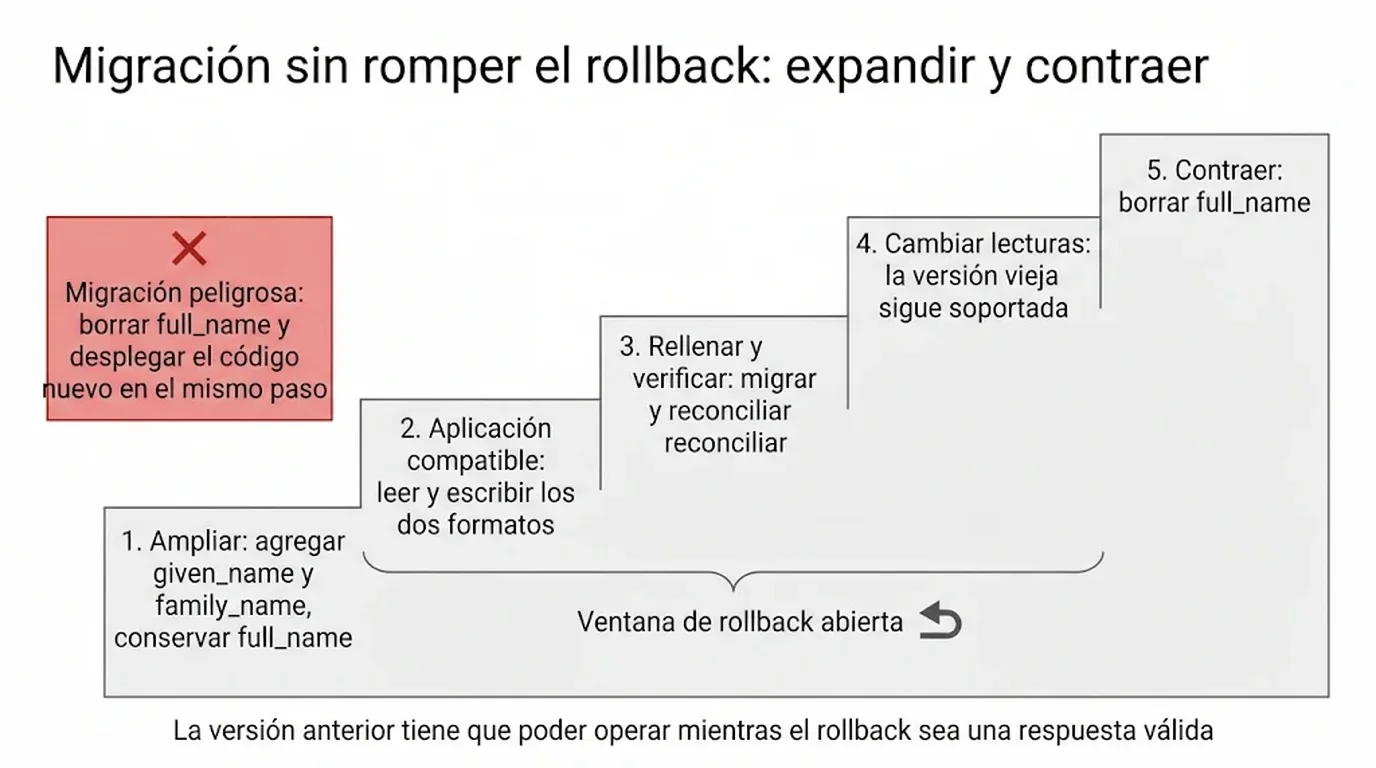
El caso típico: la v1 guarda el nombre del cliente en full_name; la v2 quiere given_name y family_name. Una migración que borra full_name y despliega el código nuevo deja a la v1 sin el campo que necesita si algo falla. El patrón expand and contract separa la parte estructural de la destructiva.
- Ampliar: agregar
given_nameyfamily_name, conservarfull_name. - Aplicación compatible: leer ambas representaciones y escribir las dos cuando corresponda.
- Rellenar y verificar: migrar los registros existentes y reconciliar discrepancias.
- Cambiar lecturas: las lecturas nuevas usan los campos nuevos; la versión vieja sigue soportada.
- Contraer: borrar
full_namerecién cuando cerró la ventana de rollback.
La invariante que sostiene el patrón es que la aplicación vieja tiene que seguir operando mientras el rollback sea una respuesta aprobada. Las escrituras duales no son gratis: si una escribe y la otra falla queda una inconsistencia, y hace falta una política de fallo, un proceso de reconciliación y observabilidad de la divergencia. Las vistas o triggers de compatibilidad agregan acoplamiento. El patrón no elimina el riesgo: saca las operaciones destructivas de la ventana inmediata de fallo.
Compatibilidad de esquema no es compatibilidad de datos
Que la columna vieja siga existiendo no garantiza que el binario viejo sepa qué hacer con lo que escribió el nuevo. Si la v2 agrega el estado PARTIALLY_FULFILLED y la v1 solo reconoce PENDING, AUTHORIZED y COMPLETE, el rollback devuelve un ejecutable válido que no puede procesar los pedidos creados después. Es una falla semántica, no de definición de esquema. Para cada transición de estado conviene preguntar:
- ¿La versión vieja puede leer los registros que escribió la nueva?
- ¿Puede actualizarlos sin destruir información nueva?
- ¿Preserva valores de enum desconocidos y campos opcionales?
- ¿Sus jobs de fondo reinterpretan o reejecutan estado más nuevo de forma incorrecta?
Por eso la prueba de compatibilidad va en la dirección inversa a la habitual: se puebla un entorno con datos producidos por la release candidata y se ejecuta la versión anterior contra ese estado. Probar datos viejos contra código nuevo no dice nada sobre el rollback. Esto se conecta con lo que analizamos en generar NetworkPolicies desde los flujos de Hubble.
Los mensajes sobreviven al despliegue
En un sistema asíncrono, el rollback del productor no borra los eventos ya publicados en Kafka, SQS o RabbitMQ: cuando el consumidor v1 vuelve a levantar, encuentra payloads que no existían cuando se compiló. Conviene evolucionar los eventos con campos aditivos y opcionales, versiones de esquema explícitas y consumidores tolerantes a campos desconocidos, y contemplar entrega demorada, reintentos, colas de mensajes muertos y replay: según la retención, la ventana de compatibilidad puede tener que durar horas o días después del rollout. El artículo propone un contrato de release legible por máquina —versión del productor, consumidores soportados, si el replay está soportado, si hay cambio destructivo de esquema— y aclara que es un documento de política, no un objeto nativo de Kubernetes.
¿Cómo evito duplicar pagos cuando vuelvo a la versión anterior?
No se evita desde Kubernetes. Un pago autorizado, un envío creado o un email enviado siguen existiendo después del undo, y reintentar la request por la versión vieja duplica el efecto salvo que el flujo use claves de idempotencia estables y deduplicación. Para operaciones con efectos externos, la recuperación suele ser una acción compensatoria, no un rollback técnico.
El reintegro no equivale a borrar el pago. La cancelación de un envío puede fallar si ya salió. Un email de corrección no retira el primero. Modelar esos flujos implica identificadores de idempotencia que sobrevivan a reintentos y despliegues, registro durable de los efectos completados, pasos de compensación con sus propios modos de fallo y escalado manual cuando compensar es inseguro. Por eso el rollback automático no debería habilitarse sin más en flujos con estado: sin clasificación de recuperación, el automatismo agrega un segundo cambio durante una ventana ya rota.
¿Cómo pruebo que la versión vieja funciona con los datos nuevos?
Poblando el entorno con datos de la release candidata y volviendo a desplegar la versión anterior encima. La secuencia concreta es desplegar v1, crear datos representativos, aplicar la migración aditiva, desplegar v2, ejecutar workflows que cambian estado, volver a desplegar v1 y validar lecturas, escrituras, eventos, jobs de fondo e invariantes. Casi ningún pipeline hace ese último tramo: la mayoría verifica que v2 arranque y sirva requests. Te puede servir nuestra cobertura de la demo Online Boutique de Google.
Los casos borde son los que rompen: valores de enum desconocidos, mensajes parcialmente procesados, reintentos, versiones viejas de consumidores y requests en vuelo. No todos los sistemas externos se pueden simular con fidelidad, y esa limitación conviene documentarla en lugar de taparla con un pipeline en verde. El release gate puede llevar metadata —tipo de cambio de estado, clasificación del rollback, si la versión anterior se probó, runbook de compensación— siempre que previous_version_tested: true signifique que el binario viejo corrió contra estado nuevo y hay evidencia capturada. Un motor de políticas automatiza los chequeos, pero no infiere compatibilidad semántica desde YAML.
Como propuesta editorial —no como conclusión de las fuentes—, un gate razonable para equipos con flujos stateful en Kubernetes podría pedir tres evidencias antes de habilitar el despliegue: el resultado de la prueba de reversión con datos de la release candidata; el inventario de efectos externos que la versión nueva puede producir y cómo se compensan; y las stop conditions definidas de antemano, con la decisión de rollback de tráfico separada de la de rollback de estado. Esas evidencias no permiten concluir que el rollback vaya a salir bien: cubren compatibilidad conocida, no la semántica completa del negocio ni los terceros que no se pueden simular.
Rollback de tráfico, rollback de estado y backups no son lo mismo
Ante un canary que falla, el primer movimiento es frenar la promoción y sacar tráfico de la versión nueva para limitar mutaciones adicionales; recién después se decide si la versión anterior es segura para reanudar. Un canary fallido no es automáticamente reversible si escribió estado compartido o publicó eventos: el porcentaje bajo reduce la exposición, no la elimina.
Los backups tampoco son un botón de rollback. Restaurar un snapshot anterior descarta transacciones legítimas posteriores —pedidos de las 12:07 tomados entre un snapshot de las 12:00 y una falla a las 12:09— mientras los sistemas de pago y fulfillment conservan sus efectos. El point-in-time recovery achica la brecha de datos, no reconcilia efectos entre sistemas. Los backups sirven para pérdida o corrupción; las migraciones compatibles, para la recuperación rutinaria de un despliegue.
Y un Deployment puede mostrar todas las réplicas Ready mientras la integridad se degrada. Las invariantes que importan son de negocio: pedidos aceptados contra pedidos persistidos, eventos publicados contra consumidos, intentos duplicados de efectos, crecimiento de reintentos y de la dead-letter, registros sin los campos nuevos requeridos, compensaciones fallidas.
Fuentes
- Kandepaneni, Pradeep. «Designing Safe Kubernetes Rollbacks When Stateful Changes Make Rollback Dangerous», AWS Builder Center, 17 de noviembre de 2026. builder.aws.com · dev.to
- AWS Builders’ Library. «Asegurar la seguridad en las reversiones durante las implementaciones». aws.amazon.com/es/builders-library
- sre.wang. «Rollback Made It Worse: 5-Layer CI/CD Auto-Rollback Architecture and 4 Production Pitfalls», 3 de octubre de 2026. sre.wang