Extraer texto de PDF sin OCR: el truco de PDF4me
PDF4me publicó la documentación de Extract Text by Expression, un endpoint que aplica regex sobre la capa de texto de PDFs nativos y devuelve los matches en JSON, sin pasar por OCR.

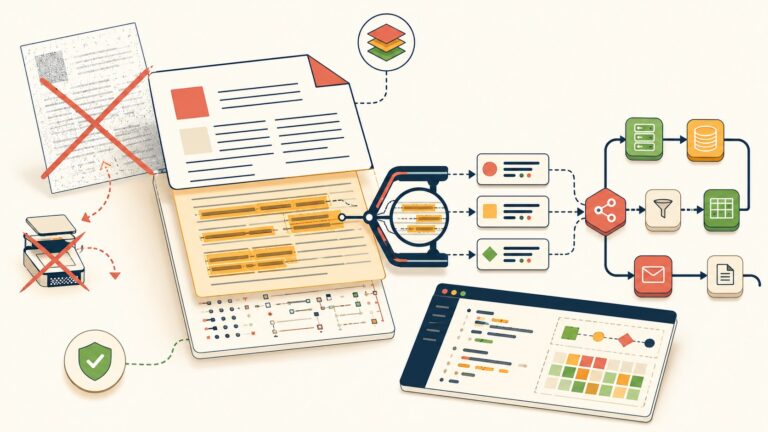
PDF4me publicó la documentación de Extract Text by Expression, un endpoint que aplica regex sobre la capa de texto de PDFs nativos y devuelve los matches en JSON, sin pasar por OCR.
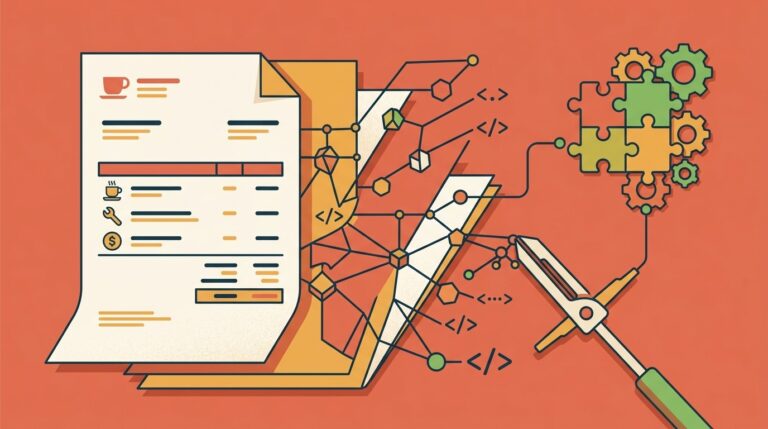
ZUGFeRD es el formato híbrido PDF/A-3 + XML exigido en Alemania para facturación B2B desde enero 2025. PDF4me lanzó en 2026 un nodo dedicado en n8n para automatizar la generación sin código. Te contamos cómo configurarlo, qué nivel de conformidad elegir y cómo evitar los errores más comunes.
End of content
End of content