Tests flaky en GitHub Actions: la evidencia ya está
Un test que falla y pasa con el mismo código ya dejó su rastro en GitHub Actions: está en el historial de intentos del workflow y, si el runner escribe JUnit XML, en los artefactos de cada intento. No hace falta un agente nuevo ni contratar un servicio: con la CLI gh, jq y la biblioteca estándar de Python se pasa de «el equipo sabe que la suite es inestable» a una lista con nombres de jobs y de tests. Conviene aclarar el marco: esto no es un anuncio de Microsoft ni una función recién lanzada de la plataforma. El artículo que originó esta nota usó el repositorio microsoft/vscode apenas como caso de prueba sobre datos públicos.
En este artículo:
- ¿Qué son los tests flaky y por qué fallan de forma intermitente?
- ¿Cómo detectar tests flaky en GitHub Actions con los datos que ya existen?
- Un script para listar los jobs que fallaron y después pasaron
- ¿Cómo guardo el reporte JUnit de cada intento para compararlos?
- Comparar los intentos test por test: el script en Python
- ¿Cuántas veces hay que repetir un test para saber si es flaky?
- Hasta dónde llega el método (y qué no permite concluir)
- Fuentes
¿Qué son los tests flaky y por qué fallan de forma intermitente?
Un test flaky es el que, ejecutado sobre el mismo código, devuelve resultados distintos: falla en una corrida y pasa en otra sin que haya cambiado una línea. Suele deberse a condiciones de carrera, dependencias de tiempo o de red, orden de ejecución o estado compartido entre pruebas. La consecuencia práctica es que el semáforo de integración continua deja de ser confiable: un rojo puede no señalar un bug y un verde puede taparlo. Lo que aporta el enfoque basado en datos es convertir esa sospecha difusa en evidencia con nombre propio.
¿Cómo detectar tests flaky en GitHub Actions con los datos que ya existen?
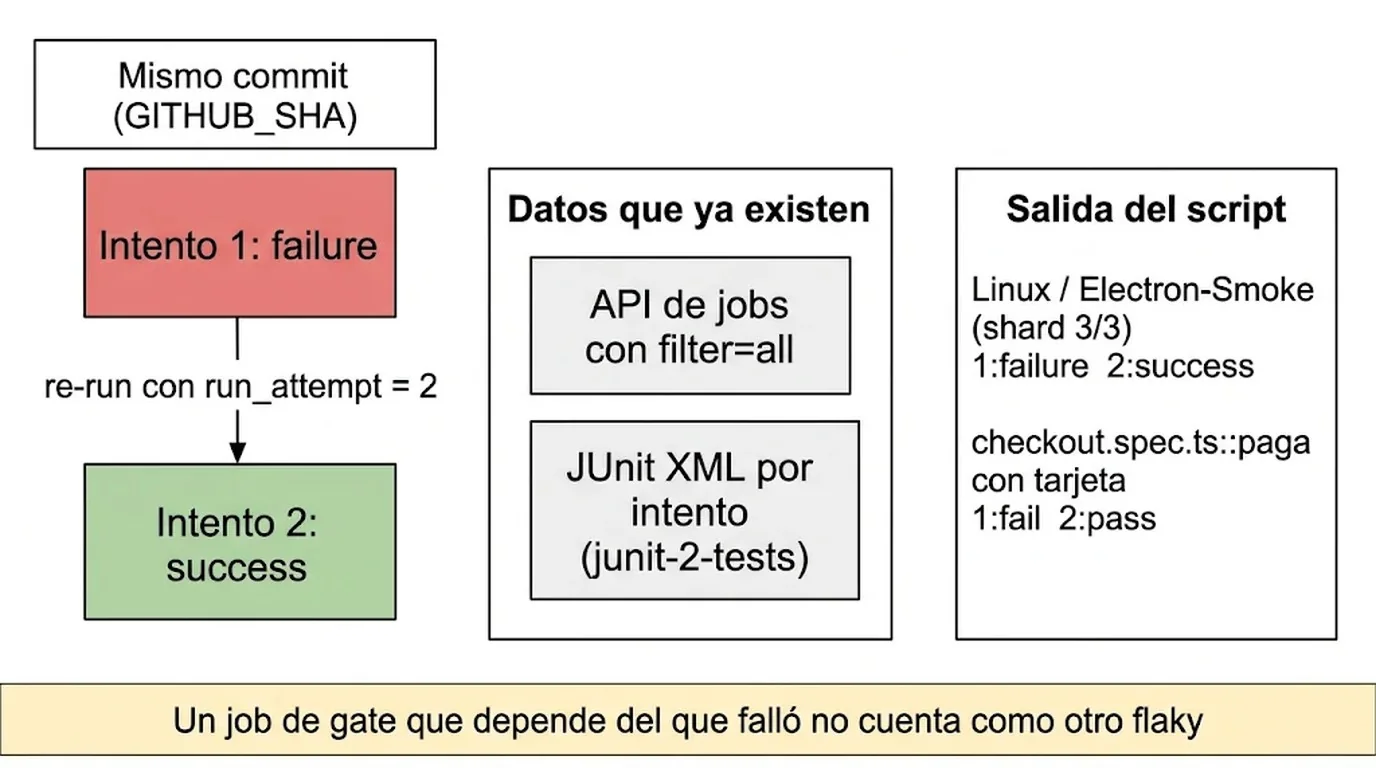
Buscá un patrón concreto: el mismo commit produciendo a la vez un fallo y una ejecución exitosa. GitHub documenta que los re-runs usan el mismo GITHUB_SHA y GITHUB_REF que el evento original, así que un job que falló en el intento 1 y pasó en el 2 corrió dos veces el mismo código y se contradijo. No hay que instrumentar nada nuevo: el dato ya está guardado. Solo hace falta consultarlo con gh y jq, las dos herramientas que el script necesita. Tema relacionado: cuánto cuestan realmente los tests flaky.
Los tres identificadores que sostienen la definición
| Identificador | Dónde se lee | En un re-run |
|---|---|---|
github.run_id | Contexto del workflow; id en el objeto REST del run | No cambia |
github.run_attempt | Contexto del workflow; run_attempt en runs y jobs | Arranca en 1 y suma uno por re-run |
GITHUB_SHA | Variable de entorno; head_sha en runs y jobs | No cambia; también une runs distintos del mismo commit |
El run_attempt es el que hace visible la repetición; el SHA es el que permite comparar un push con un pull request del mismo commit. Para mirarlo a mano alcanza con abrir el desplegable Latest a la derecha del nombre del run en la interfaz web, o usar gh run view <run-id> --attempt 1. Hay dos límites documentados que conviene tener presentes: un run se puede re-ejecutar hasta 50 veces y solo hasta 30 días después de la corrida inicial.
Por qué el listado de jobs por defecto esconde los fallos
El parámetro filter del endpoint de jobs vale latest por defecto y devuelve únicamente los jobs de la última ejecución. Por eso un run que falló y se re-ejecutó en verde parece limpio bajo el valor predeterminado. Con filter=all aparecen todos los intentos, cada job con su propio run_attempt y su conclusion. Cuatro endpoints de la API REST alcanzan para reconstruir la historia:
| Endpoint | Qué devuelve |
|---|---|
GET /repos/{owner}/{repo}/actions/runs?head_sha={sha} | Todos los runs de un commit, cada uno con run_attempt |
GET /repos/{owner}/{repo}/actions/runs/{run_id}/attempts/{attempt_number} | El run tal como estaba en un intento |
GET /repos/{owner}/{repo}/actions/runs/{run_id}/jobs?filter=all | Jobs de todos los intentos; el default latest oculta los anteriores |
GET /repos/{owner}/{repo}/actions/runs/{run_id}/attempts/{attempt_number}/jobs | Jobs de un intento puntual |
Un detalle observado en un run público con re-run de jobs fallidos: los jobs que ya habían pasado reaparecen bajo el nuevo número de intento con sus horas de inicio originales. Agrupar por nombre de job y ordenar por intento resuelve ese caso sin código especial.
Un script para listar los jobs que fallaron y después pasaron
El siguiente script recibe un repositorio y un SHA, busca los runs de ese commit que tengan run_attempt mayor que 1, baja todos sus jobs con filter=all, agrupa por run y nombre de job, ordena por intento e imprime los que terminaron en success con algún failure previo. Solo necesita gh y jq.
#!/usr/bin/env bash
# Uso: flaky-jobs.sh OWNER/REPO [SHA]
set -euo pipefail
repo=$1
sha=${2:-$(git rev-parse HEAD)}

gh api "repos/$repo/actions/runs?head_sha=$sha&per_page=100" --paginate \
 --jq '.workflow_runs[] | select(.run_attempt > 1) | .id' |
while read -r run; do
 gh api "repos/$repo/actions/runs/$run/jobs?filter=all&per_page=100" --paginate \
 --jq '.jobs[] | {run: .run_id, job: .name, attempt: .run_attempt, conclusion}'
done |
jq -rs 'group_by([.run, .job])[]
 | sort_by(.attempt)
 | select(.[-1].conclusion == "success" and any(.[]; .conclusion == "failure"))
 | "\(.[0].run)\t\(.[0].job)\t" + (map("\(.attempt):\(.conclusion)") | join(" "))'
El artículo original lo corrió contra microsoft/vscode en el commit 0dcccc4 el 12 de noviembre de 2026 y obtuvo dos jobs: Linux / Electron-Smoke (shard 3/3) y PR Gate, ambos con la secuencia 1:failure 2:success. La advertencia importa: el segundo es un gate que espera al primero y falló solo porque su dependencia falló. Hay que leer la salida desde arriba de la cadena de dependencias o se cuenta el mismo problema dos veces. Para ampliar la mirada, alcanza con iterar el script sobre los SHA que devuelve gh run list --json headSha de la última semana: el resultado son nombres de jobs inestables en lugar de una tasa abstracta.
¿Cómo guardo el reporte JUnit de cada intento para compararlos?
El nombre del job indica dónde mirar, no qué test falló. Para eso hace falta el registro del propio runner, y casi todos pueden escribir JUnit XML: pytest con --junitxml, Playwright con su reporter junit, Maven Surefire por defecto. El reporte se sube en cada intento, con el número de intento dentro del nombre del artefacto. Ese nombre es la pieza clave: los artefactos deben ser únicos dentro de un run y GitHub conserva las subidas de intentos anteriores, así que github.run_attempt evita la colisión en el re-run. En un job con matriz conviene agregar también los valores de la matriz.
steps:
 - uses: actions/checkout@3d3c42e5aac5ba805825da76410c181273ba90b1 # v7.0.1
 # acá va el setup del lenguaje
 - run: python -m pytest --junitxml=reports/junit.xml
 - if: ${ !cancelled() }
 uses: actions/upload-artifact@cf430e030ddbb5b0abf93d22962f4752f3646cd9 # v7.0.2
 with:
 name: junit-${ github.run_attempt }-${ github.job }
 path: reports/junit.xml
 retention-days: 14
Antes de confiar en los archivos hay que revisar los reintentos internos del runner. Si el runner reintenta un test fallido y este pasa, su salida JUnit puede registrar un pass limpio: Playwright lo hace así salvo que se active includeRetries, mientras que Surefire escribe elementos flakyFailure. Los artefactos de los intentos 1 y 2 se conservan y se descargan con gh run download, que con un patrón deja cada uno en su propio directorio nombrado según el artefacto.
Comparar los intentos test por test: el script en Python
Con los artefactos descargados, un script de biblioteca estándar recorre los XML, extrae el número de intento del nombre del archivo, ignora los testcase marcados como skipped, considera failure o error como fallo y arma un diccionario de test a intento. Al final imprime solo los tests que registraron tanto un pass como un fail. La definición no depende de qué run produjo el desacuerdo, así que descargar varios runs del mismo SHA en un mismo directorio sigue funcionando. Ampliamos el tema en nuestra cobertura de los planes vigentes de Copilot.
import re, sys, pathlib, xml.etree.ElementTree as ET
from collections import defaultdict

seen = defaultdict(dict) # test -> {intento: "pass" o "fail"}
for path in pathlib.Path(sys.argv[1]).rglob("*.xml"):
 match = re.search(r"junit-(\d+)", str(path))
 if not match:
 continue
 for case in ET.parse(path).getroot().iter("testcase"):
 if case.find("skipped") is not None:
 continue
 failed = case.find("failure") is not None or case.find("error") is not None
 test = f'{case.get("classname")}::{case.get("name")}'
 seen[test][int(match.group(1))] = "fail" if failed else "pass"

for test, runs in sorted(seen.items()):
 if {"pass", "fail"} <= set(runs.values()):
 print(test, " ".join(f"{a}:{r}" for a, r in sorted(runs.items())))
# gh run download "$run_id" --pattern 'junit-*' --dir reports
# python3 flaky_tests.py reports
El autor lo validó contra dos archivos JUnit de Playwright en los que un test falló en el intento 1 y pasó en el 2: el script imprimió ese test y nada más. Es el paso que convierte «el job de smoke tests es inestable» en un identificador de test accionable.
¿Cuántas veces hay que repetir un test para saber si es flaky?
No hay un número fijo, porque depende de la frecuencia con la que falla. Un test que falla una vez cada cincuenta corridas tiene cerca del 64% de probabilidad de fallar al menos una vez en cincuenta ejecuciones (1 − 0,9850), de modo que una racha limpia de cincuenta es evidencia débil. La recomendación práctica es agotar el historial de intentos que ya existe antes de gastar minutos de CI en repeticiones nuevas.
Hasta dónde llega el método (y qué no permite concluir)
Los scripts responden por commit, no por meses. Cubrir un trimestre obliga a almacenar todos los reportes, que es lo que hacen los servicios de flaky tests: Trunk Flaky Tests y BuildPulse ingieren el JUnit XML que el runner ya escribe mediante un paso de subida, y Datadog Test Optimization detecta tests inestables a partir de los resultados que recolecta. El intercambio es un paso de upload y un proveedor contra un script y almacenamiento propio.
Con cualquiera de las dos vías, un nombre en la lista no es todavía un diagnóstico. Un job terminado con código de salida 137 cae en el mismo listado que una aserción con carrera, y las dos cosas piden arreglos opuestos. El artículo original remite a «Flaky test or infrastructure failure» para separar un caso del otro.