Estimación de capacidad de servidores: guía 2026
En pocas palabras: No hace falta un estudio: con cinco minutos de cálculo a mano alzada (QPS, storage y bandwidth) alcanza. Ejemplo real de dev.to: una app de 10 millones de usuarios diarios da unas 50 lecturas por segundo en el pico y 180 GB acumulados en cinco años.
Calcular cuántos servidores necesita una aplicación no exige un estudio de meses: exige cinco minutos de cuentas en un papel. Con una app de 10 millones de usuarios activos diarios, el cálculo de back-of-the-envelope publicado en dev.to arroja unas 50 lecturas por segundo en el pico y 180 GB de almacenamiento acumulado en cinco años.
La estimación de capacidad de servidores por back-of-the-envelope es la técnica de system design que traduce requisitos vagos (“vamos a tener muchos usuarios”) en cifras concretas de tráfico (QPS), almacenamiento (GB) y ancho de banda (Mbps) antes de diseñar la arquitectura. No busca precisión: busca el orden de magnitud correcto, porque el diseño cambia completamente entre 100 solicitudes por segundo y 100.000.
En este artículo:
- En 30 segundos
- ¿Qué es el back-of-the-envelope estimation y para qué sirve?
- ¿Cómo se calcula el QPS de lectura y escritura de una aplicación?
- ¿Cómo estimar el almacenamiento necesario a largo plazo?
- ¿Qué números de referencia conviene memorizar?
- ¿Por qué hay que calcular el tráfico pico y no solo el promedio?
- Errores comunes al hacer estimación de capacidad de servidores
- ¿Cuándo esta estimación indica que hace falta shardear la base de datos o sumar un CDN?
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El back-of-the-envelope estimation convierte “muchos usuarios” en números concretos de QPS, storage y bandwidth en minutos, no en un research project.
- Ejemplo real: app de 10M DAU, 1% postea/día, da ~1,2 writes/sec promedio y ~5 writes/sec en el pico (multiplicador 4x).
- Con ratio lectura:escritura 10:1, ese pico de escritura se traduce en 50 reads/sec, y en 180 GB de storage acumulado a 5 años.
- Un servidor de aplicación típico maneja de cientos a pocos miles de req/s; una base de datos relacional, miles de queries simples por segundo.
- El tráfico real nunca es parejo: el peak-to-average ratio suele estar entre 2x y 5x en la hora pico, y diseñar solo para el promedio hace que el sistema colapse justo cuando más importa.
¿Qué es el back-of-the-envelope estimation y para qué sirve?
Es el hábito de hacer napkin math antes de diseñar cualquier sistema: tomar un número vago de usuarios y convertirlo en QPS, gigabytes y megabits en cuestión de minutos. Cada decisión de arquitectura (una base de datos o varias, cache sí o no, qué estrategia de escalado) depende de saber, aunque sea de forma aproximada, el tamaño real del problema.
El objetivo nunca es la precisión. Nadie espera un número exacto de servidores de un cálculo de cinco minutos. Lo que importa es el orden de magnitud (spoiler: eso alcanza y sobra para tomar la decisión correcta). Saber si estás diseñando para 100 solicitudes por segundo o para 100.000 cambia la arquitectura entera, y esa diferencia queda visible con matemática básica. En monitorear métricas de jugadores en servidores de juegos profundizamos sobre esto.
Ponele que un colega te dice “va a tener bastante tráfico”. Esa frase no te sirve para nada. Ahora bien, si te dice “10 millones de usuarios activos diarios, 1% postea por día”, ya podés empezar a diseñar.
¿Cómo se calcula el QPS de lectura y escritura de una aplicación?
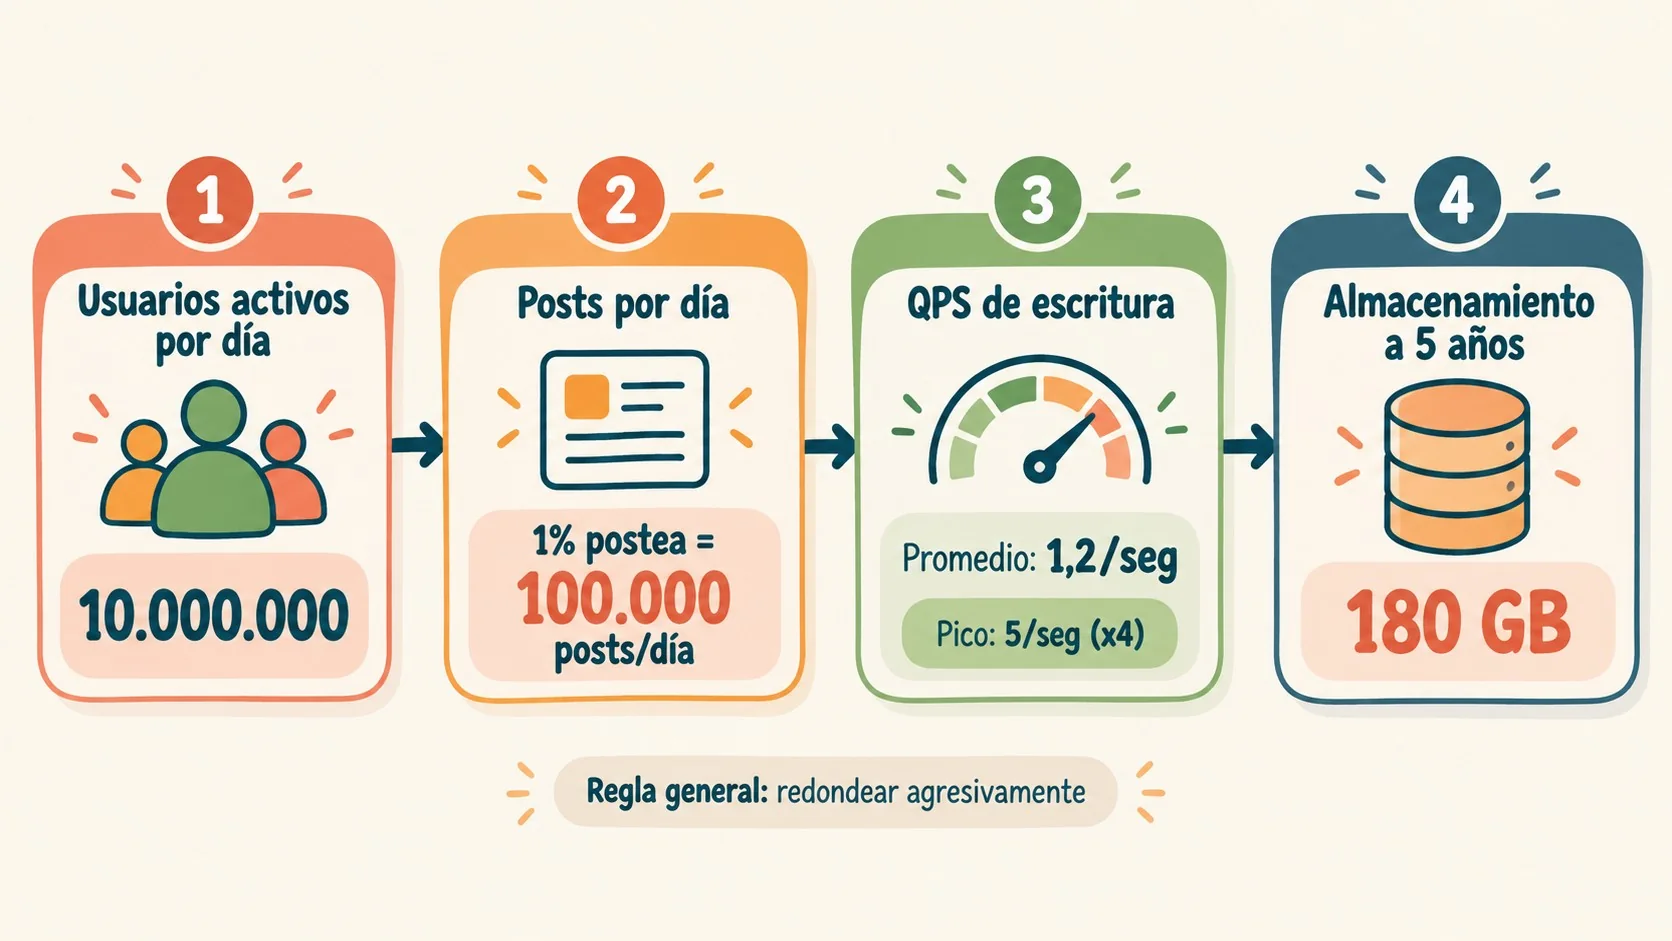
Se parte del número de usuarios activos diarios (DAU), se estima qué porcentaje hace una acción por día, y se divide por 86.400 segundos para obtener el promedio; después se aplica un multiplicador de pico. En el ejemplo de una app de compartir links con 10 millones de DAU, si el 1% postea por día, eso da 100.000 posts diarios.
Con un post promedio de 1 KB, el volumen diario de escritura llega a 100 MB/día. Dividiendo por 86.400 segundos, el promedio da apenas 1,2 escrituras por segundo, pero el tráfico real nunca es parejo: el pico suele ser 3 a 5 veces el promedio, así que la escritura pico queda cerca de 5 QPS. Con un ratio lectura:escritura de 10:1 (típico en contenido social), el pico de lectura sube a 50 QPS. Tema relacionado: configurar la PKI de un clúster de Kubernetes.
El framework de Design Gurus para entrevistas de system design usa la misma lógica con otra escala: 50 millones de DAU, 10 vistas de timeline y 1 tweet por usuario al día dan un read QPS promedio de 5.787 (redondeado a 6.000) y un write QPS de 579 (redondeado a 600). Aplicando un multiplicador de 3x, el pico de lectura llega a 18.000 QPS. La lógica es idéntica, solo cambia la escala del negocio.
¿Cómo estimar el almacenamiento necesario a largo plazo?
Se multiplica el volumen diario de datos por los días de retención requeridos. En el ejemplo de la app de links, 100 MB/día × 365 días × 5 años da aproximadamente 180 GB, un volumen que entra cómodo en una sola base de datos.
Acá está el detalle que sorprende a la mayoría: el storage suele “explotar” antes que el volumen de requests. Una funcionalidad que parece chica por ítem (un post de 280 caracteres, una línea de log) suma rápido a escala: un millón de eventos diarios de 1 KB cada uno ya son 365 GB al año, sin una sola imagen ni video de por medio. Esa cuenta suele ser la que fuerza la primera conversación sobre object storage o sharding de tablas, mucho antes de que el volumen de requests lo exija.
¿Qué números de referencia conviene memorizar?
Cuatro cifras alcanzan para hacer sanity-check de cualquier estimación sin buscar nada: cuánto aguanta un servidor de aplicación, cuánto aguanta una base de datos relacional, y cuánto cuesta un round trip de red dentro o fuera del datacenter. Sobre eso hablamos en un ataque masivo contra miles de servidores.
| Componente | Referencia aproximada |
|---|---|
| Servidor de aplicación | De cientos a pocos miles de req/s, según la complejidad de cada request |
| Base de datos relacional | Miles de queries simples por segundo en hardware sólido |
| Round trip dentro del mismo datacenter | 0,5 a 1 ms |
| Round trip transcontinental o transatlántico | 50 a 150 ms |
Ninguno de estos números necesita ser exacto. Con saber que “un servidor aguanta miles bajos de req/sec, no millones” ya podés detectar si una estimación propia está mal.
¿Por qué hay que calcular el tráfico pico y no solo el promedio?
Porque el tráfico real nunca se distribuye parejo a lo largo del día, y un sistema diseñado solo para el promedio colapsa justo en el momento en que más usuarios lo están usando. El peak-to-average ratio ronda entre 2x y 5x durante la hora más cargada.
El equipo de ByteByteGo aplica el principio de Pareto para este cálculo: asume que el 80% del tráfico ocurre en el 20% del tiempo. Con 500 millones de usuarios y 10 pageviews de timeline por usuario al día, el promedio da 5.000 millones de pageviews diarios, unos 60.000 QPS. Si el 80% de esas vistas se concentra en una ventana de 8 horas, el pico sube a 138.000 QPS, más del doble del promedio.
¿Y cuántos servidores hacen falta para sostener ese pico? Ahí entra la cuenta de capacidad por instancia. Si cada servidor tiene 32 workers y cada worker responde en 200 ms (5 queries por segundo), cada instancia aguanta 160 QPS. Para sostener 2 millones de QPS (el ejemplo de ByteByteGo con 10 millones de sensores IoT), hacen falta unas 12.500 instancias. Ese es el tipo de número que separa un diseño de juguete de uno que sobrevive un lanzamiento real.
Errores comunes al hacer estimación de capacidad de servidores
La mayoría de los errores en esta estimación de capacidad de servidores no son de matemática: son de criterio. Estos son los que más se repiten, según el material revisado. Relacionado: construir y publicar apps desde el navegador.
- Perseguir precisión falsa. Calcular 9,7 millones de usuarios en vez de redondear a 10 millones, o usar 847 bytes por post en vez de 1 KB. La única función de este ejercicio es velocidad y dirección correcta; la decisión real solo necesita saber si estás cerca de cien, cien mil o cien millones.
- Diseñar solo para el promedio. Un sistema que aguanta 6.000 QPS en promedio pero se cae a 18.000 QPS en el pico le da una experiencia pésima al usuario justo en el momento de mayor demanda.
- Ignorar que el storage crece más rápido que el tráfico. Un feature que parece chico por ítem termina forzando una migración a object storage o un sharding no planificado, cuando bastaba con proyectar la retención desde el día uno.
- No aclarar el ratio lectura:escritura con quien pide el sistema. Una red social es read-heavy (100:1); un sistema de logging es write-heavy (1:100). Diseñar sin ese dato es tirar a ciegas.
¿Cuándo esta estimación indica que hace falta shardear la base de datos o sumar un CDN?
La respuesta aparece sola una vez que tenés los números: shardear se vuelve necesario cuando el pico de escritura contra una sola tabla se acerca a las decenas de miles por segundo, y un CDN se vuelve obvio cuando gran parte de los usuarios está lejos del servidor único.
“¿Hace falta shardear la base de datos?” es una pregunta imposible de responder en abstracto, pero se contesta sola cuando sabés que esperás 50.000 escrituras por segundo contra una única tabla. Lo mismo pasa con un CDN: es indiscutible en cuanto sabés que el 80% de tus usuarios están fuera de la región donde vive tu único servidor. Si el resultado de tu cálculo te lleva a necesitar más instancias, una CDN o migrar a un proveedor con soporte real de escalado, en Argentina la opción de evaluar hosting y VPS con soporte local está en donweb.com.
Preguntas Frecuentes
¿Qué es el back-of-the-envelope estimation en system design?
Es un cálculo rápido, de pocos minutos, que traduce requisitos vagos de una aplicación en cifras concretas de QPS, almacenamiento y ancho de banda antes de diseñar la arquitectura. Busca el orden de magnitud correcto, no un número exacto.
¿Cómo se calcula el QPS de una app antes de diseñarla?
Se toma el número de usuarios activos diarios, se estima qué porcentaje hace una acción específica por día, y ese total se divide por 86.400 segundos para obtener el QPS promedio. Después se multiplica por un factor de 2x a 5x para estimar el QPS en el pico.
¿Cuántas peticiones por segundo soporta un servidor típico?
Un servidor de aplicación individual maneja generalmente de unos cientos hasta pocos miles de requests por segundo, según la complejidad de cada solicitud. Requests simples de lectura rinden más alto; requests que golpean una base de datos o hacen cómputo real rinden más bajo.
¿Cómo calcular el almacenamiento necesario para una app con millones de usuarios?
Se multiplica el volumen de datos generado por día por la cantidad de días que hay que retenerlos. En el ejemplo de una app de links con 100 MB/día de escrituras y 5 años de retención, el cálculo da aproximadamente 180 GB acumulados.
¿Por qué el tráfico pico es más importante que el promedio para dimensionar servidores?
Porque el tráfico real se concentra en franjas horarias específicas, no se distribuye parejo. Si el sistema se diseña solo para el QPS promedio, colapsa en el momento de mayor demanda, que es exactamente cuando más importa que funcione.
Conclusión
La estimación de capacidad de servidores por back-of-the-envelope no reemplaza un diseño detallado, pero define el punto de partida de cualquier discusión de arquitectura. Con cinco minutos de cuentas (DAU, ratio lectura:escritura, tamaño de dato, multiplicador de pico) ya sabés si estás resolviendo un problema de cientos de QPS o de decenas de miles, y esa distinción sola determina si necesitás cache, sharding o un CDN. Lo que hay que llevarse de acá no es la fórmula exacta, sino el hábito: antes de dibujar un diagrama de arquitectura, hacé la cuenta en un papel.