Pipelines tolerantes a fallos en Python con SQLite WAL
En pocas palabras: WPipe v2.2.0 resuelve la reanudación con Checkpoints Inteligentes sobre SQLite en modo WAL: si el pipeline se interrumpe, CheckpointManager.can_resume() detecta el corte y pipeline.resume() retoma el paso exacto donde falló, sin reprocesar los anteriores ni depender de servidores externos.
Los pipelines tolerantes a fallos en Python dejaron de depender de reintentar todo desde cero: WPipe v2.2.0 sumó Checkpoints Inteligentes sobre SQLite en modo WAL, así un script retoma justo donde se cortó. La librería, con licencia MIT y compatible con Python 3.9 a 3.14, ya llegó a la versión 2.5.1 según PyPI.
WPipe es una librería open source de Python creada por William Steve Rodríguez Villamizar (Wisrovi) para orquestar pipelines con checkpoints automáticos. Guarda el estado en una base SQLite con Write-Ahead Logging, sin daemons ni servidores externos. Si el proceso se interrumpe, CheckpointManager.can_resume() detecta el corte y pipeline.resume() retoma exactamente en el paso donde falló, sin reprocesar los anteriores.
En este artículo:
- En 30 segundos
- ¿Por qué un pipeline de Python falla “todo o nada”?
- ¿Cómo hacer pipelines tolerantes a fallos en Python usando SQLite en modo WAL?
- ¿Cómo reanudar un script Python desde el punto donde falló con CheckpointManager?
- Serialización resiliente: qué problemas de pickle resuelve
- Instalación y requisitos para usar WPipe
- Qué está confirmado y qué no sobre WPipe
- Errores comunes al implementar checkpoints en pipelines Python
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- WPipe v2.2.0 introdujo Checkpoints Inteligentes sobre SQLite en modo WAL, según el artículo técnico publicado el 26/09/2026.
- La librería ya está en la versión 2.5.1 según PyPI (publicado el 25/09/2026), con 25 features y un tour de aprendizaje de 140 niveles.
- Es compatible con Python 3.9 a 3.14, tiene licencia MIT y se instala con
pip install wpipe. - No necesita orquestadores pesados como Airflow o Prefect: corre embebida en cualquier worker, sin daemons externos.
- El CheckpointManager filtra objetos no serializables y tolera referencias circulares que rompen a pickle clásico.
¿Por qué un pipeline de Python falla “todo o nada”?
Un pipeline de Python sin persistencia de estado ejecuta todo o nada: si falla en el paso 19 de 20 por un timeout de red, tenés que reiniciar desde el paso 1, duplicando el cómputo ya hecho. Ese es el problema central que describe el artículo técnico de la serie WPipe, publicado el 26 de septiembre de 2026.
Ponele que armás un ETL que extrae registros de una API, los procesa y los carga a un data warehouse. Corre bien en los primeros 18 pasos, pero en el 19 la conexión se cae por un problema de red del proveedor. Sin checkpoints no hay forma de saber qué se procesó y qué no, así que reiniciás todo, duplicás llamadas a una API que capaz tiene rate limit y generás efectos secundarios que no querías, como insertar registros repetidos en la base.
Ojo con esto: el problema no es solo el reinicio. Los checkpoints armados a mano con pickle.dump fallan cuando el estado tiene referencias circulares o conexiones abiertas, un socket, un cursor de base de datos. El objeto no serializa y el pipeline colapsa antes de guardar nada útil. Relacionado: cuando un pipeline mal configurado expone secretos.
Y después está la fricción de meter un orquestador monolítico solo para tener puntos de control. Instalar un scheduler completo, levantar una base de metadatos y mantener workers separados es mucha infraestructura para resolver algo puntual: que el script se acuerde dónde se quedó.
¿Cómo hacer pipelines tolerantes a fallos en Python usando SQLite en modo WAL?
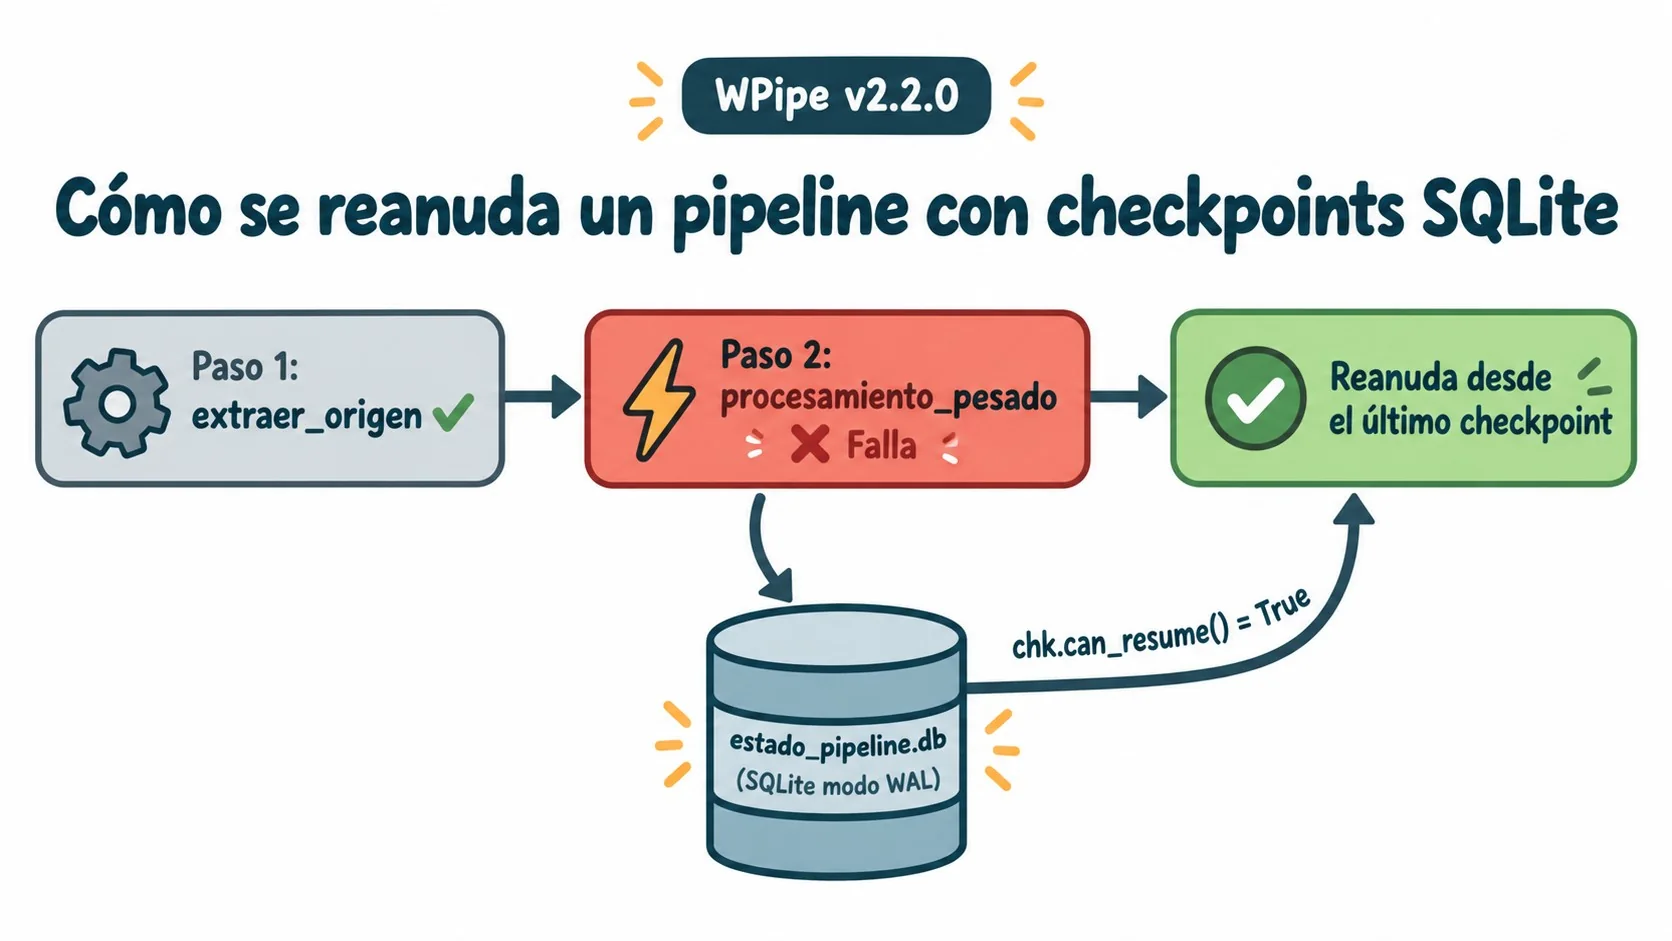
El modo WAL (Write-Ahead Logging) de SQLite escribe los cambios en un archivo de log separado antes de aplicarlos a la base, lo que permite que las escrituras no bloqueen las lecturas concurrentes. WPipe usa ese mecanismo para persistir el estado del pipeline paso a paso, según describe la documentación en GitHub del proyecto.
Cada vez que un paso del pipeline termina, WPipe escribe ese checkpoint en microsegundos, sin frenar el resto del proceso ni bloquear a otros hilos que estén leyendo la misma base. Eso importa si corrés pasos en paralelo con Parallel(steps=[...], max_workers=3): varios hilos pueden consultar el estado sin pisarse.
Lo interesante es que esto no requiere un servidor de base de datos aparte. SQLite es un archivo, WAL es un modo de ese mismo archivo, y todo vive dentro del proceso Python. Cero infraestructura adicional, cero puerto que abrir, cero credencial que gestionar.
¿Cómo reanudar un script Python desde el punto donde falló con CheckpointManager?
Se hace con dos objetos: Pipeline para definir los pasos y CheckpointManager para consultar si hay un estado previo guardado. Si can_resume() devuelve verdadero, llamás a pipeline.resume() en vez de pipeline.run(), y el proceso arranca justo después del último checkpoint confirmado. Ya lo cubrimos antes en en tareas largas de scraping como esta.
from wpipe import Pipeline, step, CheckpointManager

pipeline = Pipeline(pipeline_name="etl_resiliente")
pipeline.add_checkpoint(
 checkpoint_name="datos_cargados",
 expression="len(registros) > 0"
)

@step(name="extraer_origen")
def extraer_origen(data):
 return {"registros": [101, 102, 103], "estado": "cargado"}

@step(name="procesamiento_pesado")
def procesamiento_pesado(data):
 procesados = [r * 2 for r in data["registros"]]
 return {"procesados": procesados}

pipeline.set_steps([extraer_origen, procesamiento_pesado])

chk = CheckpointManager("estado_pipeline.db")
if chk.can_resume("etl_resiliente"):
 print("Interrupción detectada! Reanudando...")
 result = pipeline.resume()
else:
 result = pipeline.run({})
Fijate qué hace cada parte: add_checkpoint define una expresión lógica (len(registros) > 0) que se evalúa después de cada paso para decidir si ese estado es válido como punto de retorno. CheckpointManager("estado_pipeline.db") apunta a la base SQLite donde queda guardado todo. Y la rama if/else es la lógica completa de recuperación: tres líneas, sin scheduler externo, sin YAML de configuración de un orquestador.
¿Y si el pipeline nunca se interrumpió? Entonces can_resume() devuelve falso y corre pipeline.run({}) normal, de punta a punta, sin overhead extra más allá de escribir los checkpoints a medida que avanza.
Serialización resiliente: qué problemas de pickle resuelve
La serialización resiliente de WPipe tolera grafos de memoria complejos y filtra objetos no persistibles sin colapsar el pipeline entero, según el mismo artículo de dev.to. Es la diferencia concreta con un checkpoint clásico armado a mano con pickle.dump(estado, archivo).
Cualquiera que haya intentado guardar el estado de un proceso con una conexión de base de datos abierta adentro sabe lo que pasa: pickle tira TypeError: cannot pickle y ahí se corta todo, sin guardar nada, ni siquiera lo que sí era serializable. Con referencias circulares el problema es peor todavía, porque a veces ni siquiera falla rápido: se cuelga o consume memoria de más intentando resolver el ciclo. Esto se conecta con lo que analizamos en sobre todo si tu pipeline corre dependencias de terceros.
El enfoque de WPipe, según la documentación, es filtrar lo que no se puede persistir en vez de abortar la escritura completa. Esto es una descripción de la funcionalidad tal como la presenta el fabricante, no un resultado que hayamos podido verificar con pruebas propias.
Instalación y requisitos para usar WPipe
Se instala con un solo comando: pip install wpipe. Es compatible con Python 3.9 a 3.14, tiene licencia MIT y no requiere daemons externos ni dependencias pesadas, según la ficha del paquete en PyPI (publicada el 25/09/2026).
- Sin servidores externos: todo corre embebido en el proceso worker, la persistencia vive en un archivo SQLite local.
- Documentación completa: disponible en Read the Docs, con el tour de aprendizaje de 140 niveles que menciona la ficha de PyPI.
- Código fuente abierto: el repositorio está en GitHub bajo wisrovi/wpipe, donde figura la versión 2.4.0 al momento de esta nota.
- Versión más reciente en PyPI: 2.5.1, que suma hooks globales (
add_pre_hook,add_post_hook) y una extensión oficial para VS Code llamada WPipe Tools.
Si corrés estos pipelines en un servidor propio en vez de tu notebook, la elección del hosting importa, sobre todo para la latencia de red que mencionábamos antes con los timeouts. Para VPS o cloud con datacenter en Argentina, donweb.com es una opción que evita el salto extra que castiga justo a los pasos que más dependen de la red.
Qué está confirmado y qué no sobre WPipe
- Confirmado: WPipe v2.2.0 introdujo los Checkpoints Inteligentes sobre SQLite en modo WAL, según el artículo de dev.to del 26/09/2026.
- Confirmado: la licencia es MIT y la compatibilidad declarada va de Python 3.9 a 3.14.
- Confirmado: hay una discrepancia de versión entre fuentes, GitHub muestra 2.4.0 y PyPI muestra 2.5.1 publicada el 25/09/2026, lo normal cuando el README del repo no se actualiza al mismo ritmo que los releases.
- No confirmado: no encontramos un benchmark independiente de la afirmación “escritura en microsegundos” del modo WAL en escenarios de alta concurrencia; es una descripción del propio proyecto.
- No confirmado: el comportamiento del filtrado de objetos no serializables en producción con cargas reales todavía no tiene reportes de terceros disponibles.
Errores comunes al implementar checkpoints en pipelines Python
- Creer que cualquier checkpoint evita reprocesar todo: si la expresión del checkpoint es demasiado laxa (por ejemplo, siempre verdadera), guardás estados inválidos y al reanudar heredás datos corruptos. La expresión lógica de
add_checkpointtiene que validar algo real, no solo existir. - Asumir que pickle serializa cualquier objeto: conexiones de base de datos, sockets abiertos y objetos con referencias circulares rompen la serialización clásica. Si armás checkpoints a mano, hay que limpiar el estado antes de guardarlo.
- Pensar que hace falta un orquestador pesado para tener resiliencia básica: Airflow o Prefect resuelven scheduling y dependencias complejas entre DAGs, pero para un pipeline lineal que solo necesita reanudarse tras un fallo, montar esa infraestructura es sobreingeniería.
- No versionar el esquema del checkpoint: si cambiás la estructura de datos que guarda el pipeline entre una corrida y otra, un
resume()contra una base vieja puede fallar o traer campos que ya no existen.
Preguntas Frecuentes
¿Cómo hacer que un pipeline de Python sea tolerante a fallos?
Se logra guardando el estado de cada paso completado en un almacenamiento persistente, como SQLite, en vez de mantenerlo solo en memoria. Con WPipe esto se hace con add_checkpoint() y una expresión de validación, así el pipeline puede consultar después si hay un punto de retorno válido con can_resume().
¿Qué es un checkpoint en un pipeline de datos?
Un checkpoint es un punto de guardado del estado del pipeline, marcado cuando se cumple una condición lógica definida por vos. En WPipe se declara con pipeline.add_checkpoint(checkpoint_name, expression), y ese estado queda persistido en una base SQLite para poder retomarlo más tarde.
¿Cómo reanudar un script Python desde el punto donde falló?
Consultás si existe un checkpoint válido con CheckpointManager.can_resume(nombre_pipeline) y, si la respuesta es afirmativa, llamás a pipeline.resume() en vez de pipeline.run(). El pipeline retoma la ejecución en el paso siguiente al último checkpoint confirmado, sin repetir los anteriores. Lo explicamos a fondo en para monitorear qué falla y dónde.
¿Por qué falla el guardado de estado con pickle en Python?
Pickle falla cuando el objeto a serializar tiene referencias circulares, conexiones abiertas (sockets, cursores de base de datos) u otros elementos que no puede reconstruir. En esos casos tira TypeError y aborta el guardado completo, incluso la parte del estado que sí era serializable.
¿Qué es el modo WAL de SQLite y para qué sirve?
WAL (Write-Ahead Logging) es un modo de SQLite que escribe los cambios en un archivo de log separado antes de aplicarlos a la base principal. Esto permite escrituras rápidas sin bloquear las lecturas concurrentes de otros hilos, algo clave cuando varios pasos de un pipeline corren en paralelo.
Conclusión
Lo que cambia con WPipe v2.2.0 es que la resiliencia deja de ser un proyecto aparte. Antes, para tener checkpoints reales tenías dos caminos: armar tu propio sistema con pickle y bancarte sus límites de serialización, o instalar un orquestador completo solo para esa función. Ahora CheckpointManager resuelve eso con SQLite embebido, sin infraestructura extra.
Eso sí: la discrepancia de versión entre GitHub (2.4.0) y PyPI (2.5.1) es un dato para tener en cuenta antes de sumar la librería a un proyecto crítico. Antes de meterla en producción, conviene revisar el changelog de la versión exacta que vas a instalar y correr una prueba de reanudación con un fallo simulado, no asumir que el comportamiento documentado es idéntico al de la última release.