Errores de IAM en la nube: 251 días de exposición promedio
En pocas palabras: Un misconfig de IAM se convierte en brecha cuando errores humanos básicos (security groups abiertos, buckets públicos, roles mal copiados) quedan sin detectar: según Palo Alto Networks, el 65% de los incidentes cloud nace de estos errores, y toman en promedio 186 días detectarse y 65 más contenerse, per IBM.
El 15% de los vectores iniciales de ataque en brechas de datos arranca con una misconfiguración cloud, no con un exploit sofisticado, según un análisis publicado en octubre de 2026. Palo Alto Networks encontró que el 65% de esos incidentes de red cloud nace de un error humano: permisos mal puestos, no un ataque elaborado.
Una misconfiguración de IAM (Identity and Access Management) es un error en cómo se definen roles, permisos o políticas de acceso en una cuenta cloud de AWS, Azure o Google Cloud. Pasa cuando alguien deja un security group abierto a todo internet, publica un bucket S3 por accidente o copia un rol de un tutorial sin ajustar los privilegios. Los errores de IAM en la nube no necesitan un atacante sofisticado: alcanza con un puerto mal cerrado.
En este artículo:
- En 30 segundos
- ¿Qué es una misconfiguración de IAM en la nube?
- ¿Por qué el error humano causa la mayoría de las brechas en la nube?
- ¿Cuáles son los errores de IAM en la nube más comunes que abren la puerta a un ataque?
- Ejemplo hipotético: así se acumulan estos errores en un equipo real
- ¿Cuánto tiempo tardan las empresas en detectar y contener estas brechas?
- ¿Cómo evaluar la madurez de seguridad cloud de un equipo?
- ¿Qué buenas prácticas reducen el riesgo de IAM mal configurado?
- Errores comunes al configurar permisos IAM
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El 15% de los vectores iniciales de ataque en brechas de datos son misconfiguraciones cloud, no zero-days, según un análisis publicado en 2026.
- El 65% de los problemas de seguridad de red cloud se origina en error humano, según la investigación de Palo Alto Networks.
- 186 días tarda en promedio una empresa en detectar una brecha por misconfiguración, y otros 65 en contenerla, según el IBM Cost of a Data Breach Report.
- 251 días de exposición activa total: eso suman detección más contención cuando el error queda sin revisar.
- Los errores más repetidos: security groups abiertos a 0.0.0.0/0, buckets públicos, roles sin mínimo privilegio y credenciales huérfanas de contratistas.
¿Qué es una misconfiguración de IAM en la nube?
Una misconfiguración de IAM en la nube es cualquier permiso, rol o regla de red que quedó más abierto de lo necesario, sin que nadie la haya explotado todavía. No es un bug de software: es una decisión (muchas veces apurada) que nadie revirtió a tiempo.
Si alguna vez copiaste y pegaste una política IAM de un tutorial un viernes a la tarde para desbloquear un deploy, esto te suena (y no, no estás solo). El patrón se repite en casi todas las auditorías con estas cuatro variantes, y si querés ver cómo el mismo descuido aparece a nivel infraestructura, hay un paralelo claro con los errores de configuración YAML en Kubernetes.
- Security group abierto a 0.0.0.0/0: alguien lo abre “solo para probar” y nunca lo vuelve a cerrar.
- Bucket S3 o contenedor Blob público: se hace público para una demo y queda así durante meses.
- Rol IAM copiado de un tutorial o de Stack Overflow: trae permisos de administrador cuando alcanzaba con leer una tabla.
- Access key de un contratista que nunca se rotó: sigue activa meses después de que la persona se fue del proyecto.
¿Por qué el error humano causa la mayoría de las brechas en la nube?
El error humano causa la mayoría de las brechas cloud porque la superficie de ataque la genera el propio equipo de ingeniería, no un actor externo. Según el análisis publicado en dev.to por Zaniss Softwares, el 15% de los vectores iniciales de ataque en brechas de datos son misconfiguraciones cloud, y Palo Alto Networks atribuye el 65% de los problemas de seguridad de red cloud a error de usuario.
¿Y quién revisa esas políticas antes de que lleguen a producción? En la mayoría de los equipos, nadie, hasta que algo explota. Vale la pena notar algo que los números no dicen explícitamente pero que se desprende de ellos: el error humano domina precisamente porque no hay un “control de calidad” equivalente al que existe para el código. Un pull request pasa por revisión de pares casi por default; un cambio de permisos IAM, muchas veces, no pasa por nadie más que la persona que lo escribió.
Ninguno de estos cambios parece peligroso en un PR review. Un puerto abierto, un bucket público, un rol con permisos de más: por separado no dicen nada. Apilados contra media docena de servicios y un par de cuentas cloud, son exactamente lo que termina apareciendo en el timeline de un incidente seis meses después.
¿Cuáles son los errores de IAM en la nube más comunes que abren la puerta a un ataque?
Los errores más comunes son apertura temporal de puertos que nunca se cierra, exposición pública durante demos, roles sin mínimo privilegio desde el arranque y credenciales huérfanas de ex contratistas. Ese orden no es casual: es el que aparece una y otra vez en auditorías reales, y no es muy distinto de lo que falla cuando se despliega una aplicación a producción sin un checklist previo.
Subís el bucket a público para mostrarle el demo a un cliente, el cliente queda contento, te olvidás de volver a cerrarlo, pasan las semanas, nadie lo revisa, y ese bucket queda ahí, expuesto, con datos reales de clientes que nunca debieron estar en un entorno de pruebas.
- Apertura temporal que queda permanente: el security group se abre para destrabar un deploy y nadie documenta que hay que cerrarlo después.
- Exposición pública durante demos: el bucket o blob se hace público para mostrarle algo a un cliente y se olvida volver a privado.
- Roles sin mínimo privilegio desde el día uno: se asigna un rol amplio “para no tener que pedir permisos de nuevo”.
- Credenciales huérfanas de contratistas: la access key de alguien que ya no trabaja en el proyecto sigue activa.
Ejemplo hipotético: así se acumulan estos errores en un equipo real
Nota: el siguiente es un ejemplo hipotético, construido para ilustrar el patrón descrito arriba. No corresponde a ningún caso ni empresa real.
Imaginemos un equipo de cinco personas que lanza un producto SaaS. En el mes 1, para destrabar un deploy de fin de semana, alguien abre un security group a 0.0.0.0/0 con la idea de “cerrarlo el lunes”. El lunes llega otro incendio y el security group queda como está. En el mes 3, el equipo de ventas pide una demo urgente y alguien hace público un bucket S3 con datos de prueba para que el cliente lo vea sin pedir credenciales; la demo sale bien, nadie vuelve a tocar el bucket. En el mes 5, un contratista que ayudó con la migración termina su contrato; su access key queda activa porque el offboarding de IAM no está en ningún checklist de RRHH. En el mes 8, alguien nota en un chequeo de rutina que ese bucket “de demo” tiene datos reales de clientes, acumulados ahí por error desde el mes 4.
Ninguno de estos cuatro hechos, tomado solo, hubiera generado una alerta. Juntos, son exactamente los 251 días de exposición que menciona el IBM Cost of a Data Breach Report: no por un ataque sofisticado, sino por la suma de decisiones apuradas que nadie revisó a tiempo. Un calendario de revisión de IAM trimestral hubiera detectado al menos dos de los cuatro puntos antes del mes 5.
¿Cuánto tiempo tardan las empresas en detectar y contener estas brechas?
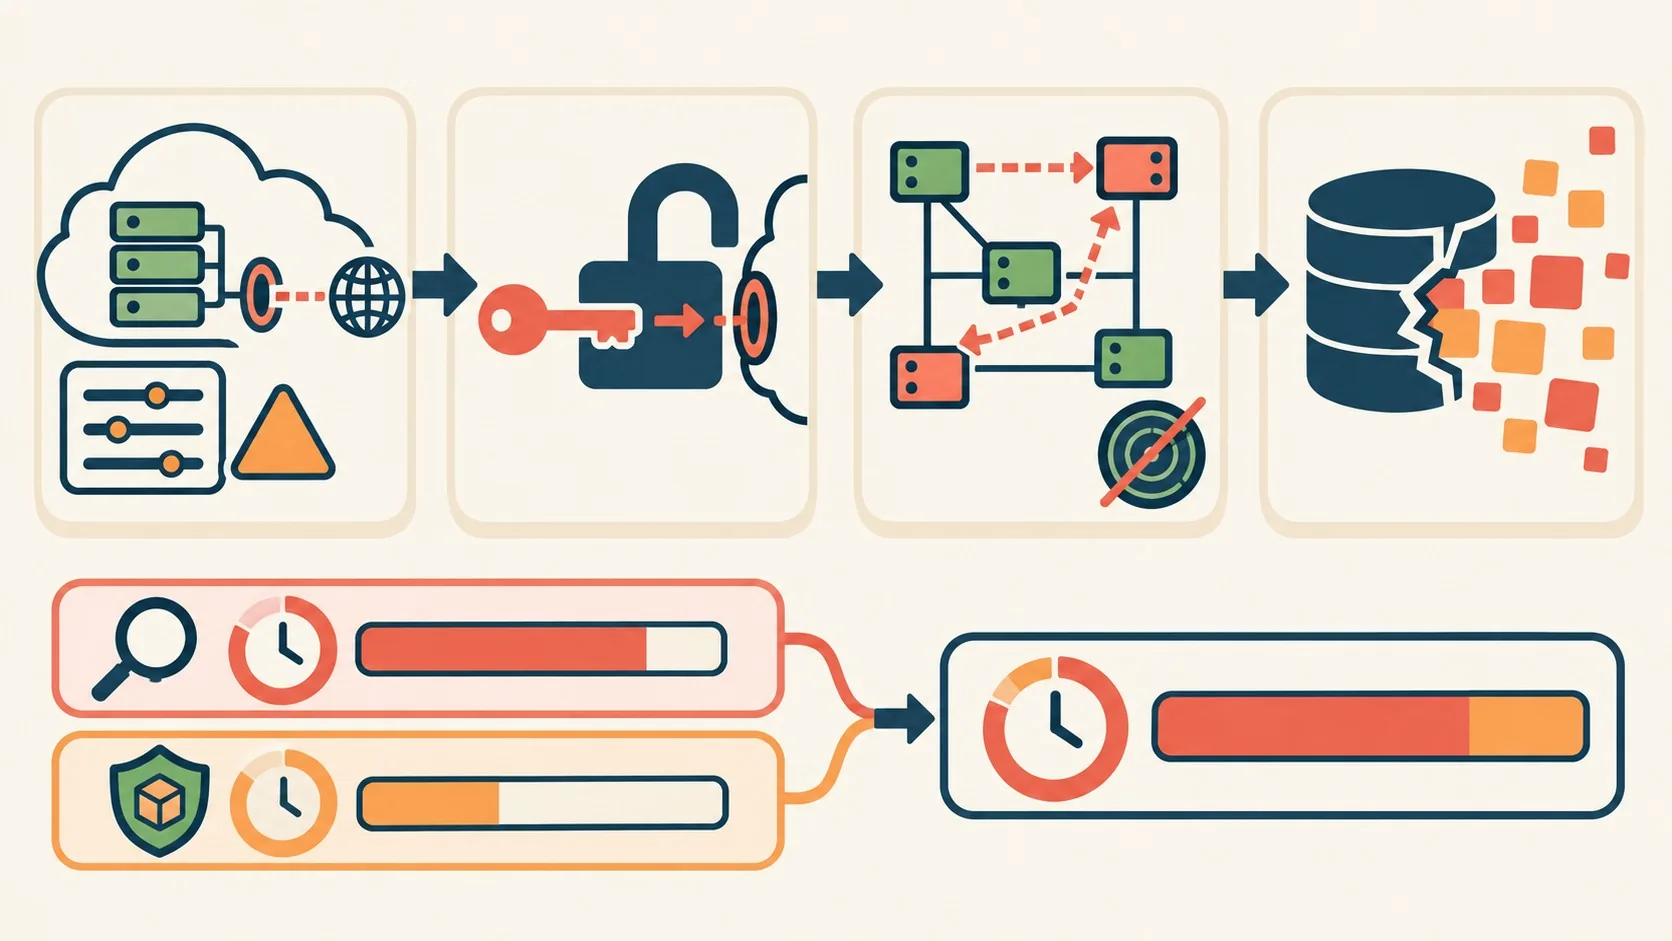
Las empresas tardan en promedio 186 días en detectar una brecha causada por misconfiguración y otros 65 días en contenerla, según el IBM Cost of a Data Breach Report citado en el análisis de Zaniss Softwares. Sumados, son 251 días de exposición activa.
Es mucho tiempo. Durante ese período, los datos están ahí, disponibles, sin que nadie en el equipo lo sepa. La mayoría de las empresas no se entera por una alerta interna: se entera por un tercero, un investigador de seguridad o, en el peor caso, por la noticia del incidente. Algo parecido pasa cuando no hay un plan claro de RTO y RPO definido de antemano: el problema no es solo que algo falle, es no tener un reloj corriendo desde el minuto cero.
¿Cómo evaluar la madurez de seguridad cloud de un equipo?
La madurez de seguridad cloud de un equipo se mide por tres señales concretas: si existen revisiones de IAM programadas (no reactivas), si hay detección de drift automatizada contra un benchmark CIS, y si los entornos de staging reciben el mismo nivel de control que producción. Un equipo que cumple las tres está en otra liga que uno que improvisa.
Como criterio rápido de decisión: si no podés responder, sin buscar nada, cuándo fue la última revisión de accesos IAM de tu equipo, probablemente estés en la columna de “madurez baja” de la tabla de abajo, aunque el resto de tu stack esté impecable.
| Señal | Madurez baja | Madurez alta |
|---|---|---|
| Revisión de accesos IAM | Se hace “cuando alguien se acuerda” | Calendarizada, con dueño asignado |
| Detección de drift | Manual, esporádica | Automatizada contra benchmark CIS |
| Trato a staging/sandbox | “Ahí no hay nada importante” | Mismas políticas que producción |
| Rotación de credenciales | Al criterio del ingeniero | Integrada al proceso de offboarding |
| Exposición estimada si falla | Hasta 251 días (IBM) | Reducida por alertas tempranas |
¿Qué buenas prácticas reducen el riesgo de IAM mal configurado?
El arreglo no es heroico, es proceso: detección automatizada de drift contra un benchmark CIS, revisiones de acceso IAM calendarizadas en vez de “cuando alguien se acuerda”, y tratar las cuentas de staging y sandbox con el mismo rigor que producción, justamente porque ahí es donde se siguen encontrando datos reales de clientes que nunca debieron estar.
- Detección de drift automatizada: comparar el estado real de la infraestructura contra un benchmark CIS en vez de confiar en la memoria del equipo.
- Revisiones de IAM con calendario fijo: mensual o trimestral, con un responsable nombrado, no “cuando haya tiempo”.
- Staging con el mismo rigor que producción: mismas políticas de acceso, mismo monitoreo, mismas alertas.
- Offboarding integrado a IAM: cuando un contratista se va, la rotación de claves es parte del proceso de RRHH, no una tarea suelta.
Si administrás infraestructura cloud propia para un equipo en Latinoamérica, conviene apoyarte en un proveedor de hosting cloud en la región, como donweb.com, en vez de armar la separación de entornos a mano cada vez que arranca un proyecto nuevo.
Errores comunes al configurar permisos IAM
Más allá del patrón general, hay tres errores puntuales que se repiten al momento de escribir las políticas. Son el tipo de decisión que también aparece al diseñar una arquitectura hub-spoke, donde la tentación de simplificar permisos “para que todo se conecte con todo” compite directamente con el mínimo privilegio.
- Dar permisos de administrador “por las dudas”: la corrección es definir el rol scoped desde el template inicial con mínimo privilegio, no recortarlo después de que algo salió mal.
- No rotar claves al terminar un contrato: la corrección es que el offboarding de IAM sea parte del proceso de RRHH, no un pendiente del ingeniero que se queda con la tarea.
- Tratar staging como “no importa, no hay datos reales”: la corrección es aplicar las mismas políticas de acceso y monitoreo que en producción, porque los audits siguen encontrando datos reales ahí.
- Confiar solo en revisiones manuales esporádicas: la corrección es automatizar la detección de drift con alertas, en vez de esperar a la próxima auditoría anual.
Preguntas Frecuentes
¿Qué es una misconfiguración de IAM en la nube?
Es un permiso, rol o regla de red configurado con más acceso del necesario, sin intención maliciosa de por medio. Ejemplos típicos: un security group abierto a todo internet, un bucket público o un rol copiado de un tutorial sin ajustar.
¿Cuánto tarda una empresa en detectar una brecha por misconfiguración cloud?
186 días en promedio, según el IBM Cost of a Data Breach Report. A eso se suman otros 65 días para contener el incidente, lo que da un total de 251 días de exposición activa.
¿Qué porcentaje de brechas de datos se origina en errores de configuración cloud?
El 15% de los vectores iniciales de ataque en brechas de datos son misconfiguraciones cloud, según un análisis publicado en 2026. No son zero-days ni exploits exóticos: son puertas que quedaron abiertas.
¿Qué es el principio de mínimo privilegio en IAM?
Es asignar a cada rol o usuario solo los permisos estrictamente necesarios para su tarea, ni uno más. Se aplica desde el diseño de la política, no como un recorte posterior a un incidente.
¿Cómo se audita la madurez de seguridad cloud de un equipo?
Revisando si existen tres cosas: revisiones de IAM con calendario fijo, detección de drift automatizada contra un benchmark CIS, y políticas de staging equivalentes a las de producción. La ausencia de cualquiera de las tres es una señal de madurez baja.
Conclusión
El dato central de este análisis no es técnico, es organizacional: el 65% de los problemas de seguridad cloud los genera el propio equipo, no un atacante externo. Eso cambia dónde hay que poner el foco. No sirve comprar otra herramienta de detección si nadie tiene el calendario de revisión de IAM, y no sirve automatizar drift detection si staging sigue tratado como un entorno descartable. El ejemplo hipotético de más arriba muestra justamente eso: ninguno de los cuatro descuidos fue un error técnico grave, fue la falta de un proceso que los revisara a tiempo.
Lo accionable es concreto: calendarizar las revisiones de acceso, automatizar la comparación contra un benchmark CIS y meter a staging dentro del mismo perímetro de control que producción. Nada de eso es caro ni heroico. Es, simplemente, dejar de confiar en que alguien se va a acordar.