Error tracking vs logging: cómo correlacionarlos
En pocas palabras: Se usan juntos: el error tracking agrupa excepciones en issues por fingerprint (Sentry prioriza fingerprint, stack trace, excepción y mensaje), los logs estructurados con un trace_id compartido guardan el orden de los eventos de negocio, y un heartbeat como Healthchecks.io detecta tareas que nunca arrancaron.
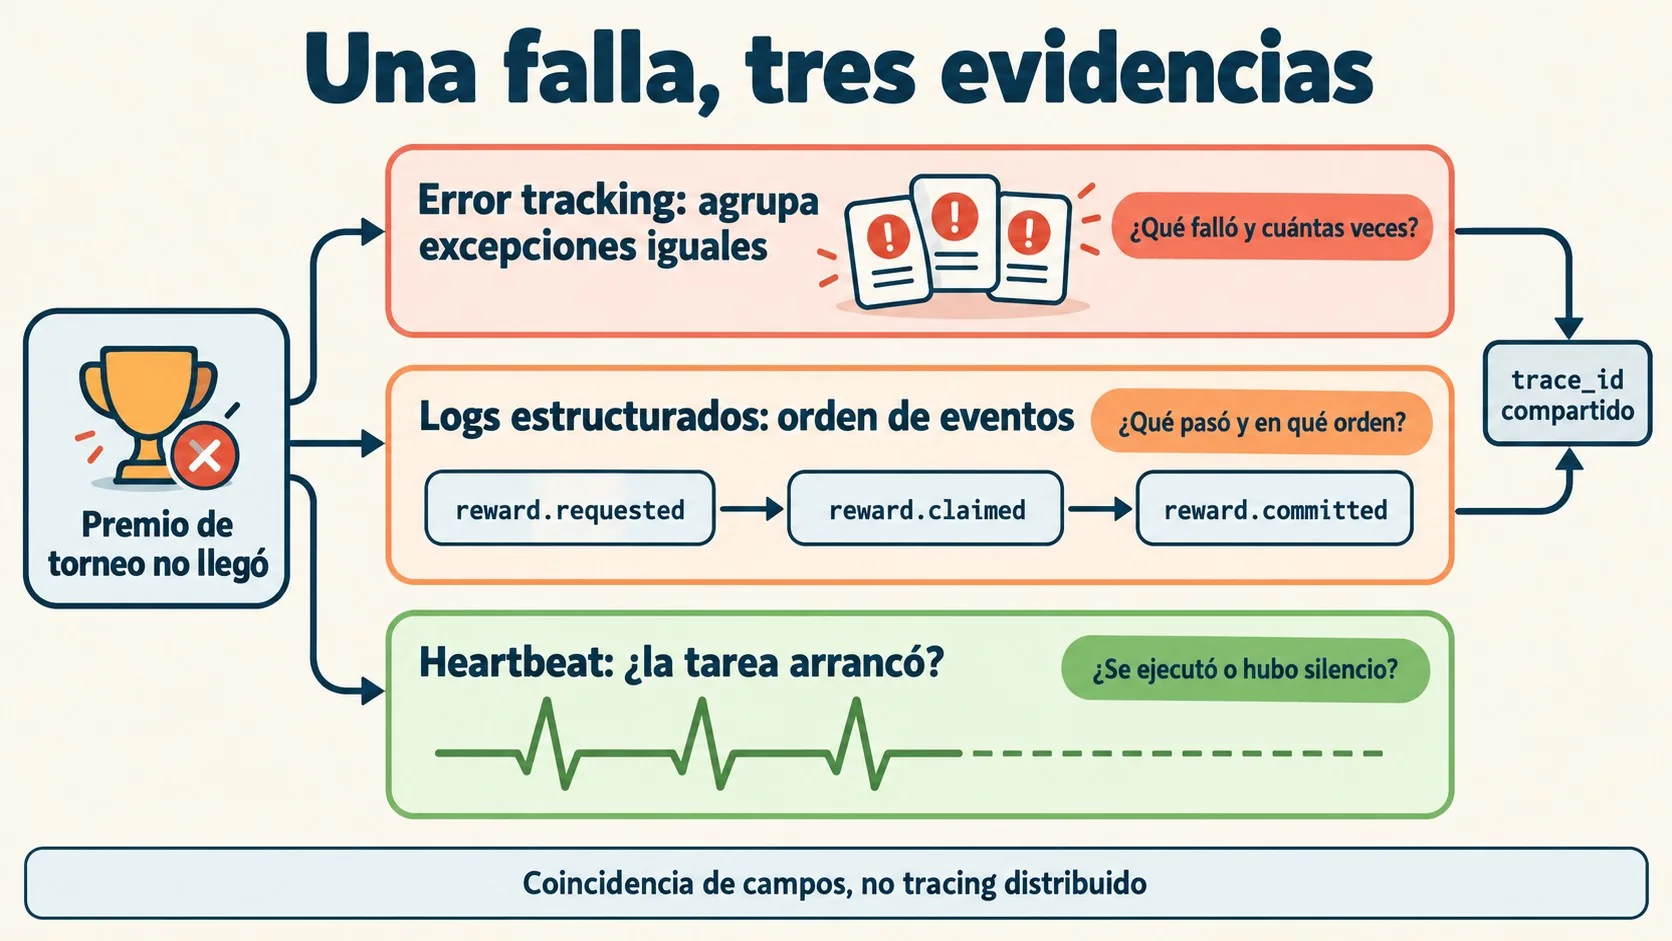
El debate de error tracking vs logging se resuelve por roles: el error tracker agrupa excepciones en issues, los logs estructurados guardan el orden de los eventos de negocio y un monitor de heartbeat avisa cuando una tarea programada no corrió. Un trace_id compartido los une.
El error tracking es la práctica de capturar las excepciones de una aplicación y agruparlas en issues según una huella (fingerprint), para saber cuántas veces ocurre cada falla y en qué release aparece. El logging es el registro de eventos que emite la aplicación, idealmente estructurado con campos fijos, para reconstruir qué pasó y en qué orden. Se usan juntos y se complementan.
En este artículo:
- En 30 segundos
- ¿Error tracking vs logging: cuándo usar cada uno en un SaaS con Node.js?
- ¿Cómo detectar una tarea programada que nunca se ejecutó?
- ¿Qué campos debe tener un log estructurado para reconstruir un incidente?
- ¿Qué datos no hay que loguear y cómo controlar la cardinalidad?
- ¿Cómo evitar premios duplicados cuando la cola reentrega un mensaje?
- ¿Sentry, Datadog, Better Stack, Loki o Infrai: cuál conviene para este caso?
- ¿Qué está confirmado y qué no?
- Errores comunes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Sentry agrupa los eventos de error por fingerprint, con este orden de prioridad: fingerprint, stack trace, excepción y mensaje.
- Un cron que nunca arrancó no deja excepción ni log; para eso hace falta un heartbeat, como Healthchecks.io.
- El post de dev.to del 8 de octubre de 2026 propone ocho campos de log: event, trace_id, job_id, tournament_id, player_id, attempt, result y error_class.
- La cola se trata como at-least-once, y la deduplicación (GrantOnce) va antes del efecto secundario.
- Un trace_id compartido es coincidencia de campos, no tracing distribuido.
¿Error tracking vs logging: cuándo usar cada uno en un SaaS con Node.js?
Usá error tracking para fallas que lanzan excepciones y logging para reconstruir la secuencia de eventos de negocio, incluidos los casos donde nada se rompe. El post de dev.to lo resume en una invariante: las excepciones identifican familias de fallas, los logs establecen el orden de los eventos y los heartbeats detectan ejecuciones faltantes.
Ponele que un jugador reporta que el premio de un torneo nunca llegó. El tracker te dice qué excepción se repite, cuántas veces y si se concentra en un release o entorno. Pero el mensaje que se aceptó dos veces, la transición válida que un chequeo rechazó o el worker que terminó con el lease vencido no tiran excepción. Ahí el log estructurado es la evidencia, porque puede mostrar reward.requested, reward.claimed y reward.committed, con el intento duplicado convertido en no-op.
Sobre el agrupado, la documentación de Sentry aclara que todos los eventos tienen un fingerprint y que los de error se agrupan mirando primero el fingerprint, luego el stack trace, después la excepción y por último el mensaje. Agrupar por excepción (tipo y valor) es menos confiable porque los mensajes cambian. Si usás JavaScript minificado sin source maps accesibles, el agrupado se arruina.
Mezclar los roles trae ruido. Según el post, loguear cada stack trace pierde el agrupado, y mandar cada rechazo de negocio al tracker convierte resultados esperados en falsos incidentes.
Eso sí: es una regla de diseño, no una ley.
¿Cómo detectar una tarea programada que nunca se ejecutó?
Con un monitor de heartbeat (dead man’s switch): la tarea manda un ping HTTP al terminar y el servicio alerta cuando el ping no llega a tiempo. Sin ese chequeo independiente, la ausencia de errores se lee como éxito cuando puede significar que el trabajo nunca arrancó. Complementá con errores de trust policy en OIDC con AWS.
Si la liquidación del torneo no empieza, no hay excepción ni log que buscar. El autor del post lo dice corto: “No event is still evidence” (la falta de un evento también es evidencia). Healthchecks.io documenta el mecanismo: cada check tiene una URL de ping única, un período y un grace time. Con un período de una hora y 5 minutos de gracia, y el último ping a las 12:00, el check pasa a late a las 13:00 y a down a las 13:05, que es cuando salen las alertas.
Podés sumar señales /start y /fail para medir duración y reportar fallas. Si mandás start y no llega success dentro del grace time, el servicio asume falla. Dos advertencias de la documentación: los UUID y las ping keys son secretos (si se filtran, cualquiera puede ensuciar tu monitoreo), y Healthchecks no sirve para uptime por sondeo, métricas ni agregación de logs.
¿Qué campos debe tener un log estructurado para reconstruir un incidente?
Una lista corta y revisable. Para el flujo de premios, el post retiene estos campos:
- event y result: el paso de negocio (
reward.requested) y su desenlace (granted,duplicate,error). - trace_id: el valor de correlación; si ya tenés una librería de tracing, reutilizá su trace_id o span_id.
- job_id y attempt: la clave de negocio estable y el número de intento.
- tournament_id y player_id: el contexto de dominio.
- error_class: una categoría estable, no el texto libre del error.
OWASP llega a lo mismo por otro camino: cada entrada debe registrar cuándo, dónde, quién y qué, con tipo y severidad del evento. Y pide consistencia dentro de la aplicación y entre las aplicaciones de la organización.
La correlación solo anda si todos los productores y consumidores usan el mismo nombre de campo. Y ojo con el alcance: poner el mismo trace_id en el tracker y en los logs no crea tracing distribuido. Sin un backend de tracing no hay árbol de spans ni consultas por traza; es filtrar por un valor igual.
¿Qué datos no hay que loguear y cómo controlar la cardinalidad?
No loguees tokens de sesión, datos de pago, secretos ni el body completo del request “por las dudas”. El post cita a OWASP para recomendar excluir o enmascarar datos sensibles y proteger los logs contra manipulación y acceso no autorizado. El extracto del cheat sheet que revisamos llega hasta permisos de archivos, cuentas de base de datos de solo escritura y qué eventos loguear, pero se corta antes de la parte de datos sensibles. Confirmá ese punto en el documento completo.
Hay una restricción de compra que se subestima. Si tu sistema de logs no puede borrar registros por usuario, el post la trata como un límite de procurement y no como una nota al pie. Con player_id en cada línea, eso pesa. Te puede servir nuestra cobertura de migrar a KYAML en Kubernetes.
Sobre la cardinalidad, result=duplicate es una etiqueta útil. Un string de error único como etiqueta indexada es ruido caro en muchos sistemas. Dejá las categorías estables en campos indexados y el texto detallado como contexto sin indexar, si tu backend distingue las dos cosas. OWASP agrega una advertencia general: un checklist ciego produce “alarm fog” y los problemas reales pasan inadvertidos.
¿Cómo evitar premios duplicados cuando la cola reentrega un mensaje?
Tratá la entrega de la cola como at-least-once, salvo que el contrato de tu cola pruebe lo contrario, y hacé una deduplicación atómica con clave de negocio estable antes del efecto secundario. El ejemplo en Go del post lo hace con GrantOnce(ctx, jobID, playerID), que devuelve si el premio se creó o ya existía.
El flujo es simple: se emite un evento JSON por transición de estado, todos con el mismo trace_id. Si el store falla, se loguea reward.failed con error_class=grant_store y además se captura la excepción. Si el premio ya existía, el consumidor registra reward.completed con result=duplicate y devuelve éxito.
El post sugiere probar tres casos: el grant inicial (granted), una redelivery con el mismo job_id (duplicate) y una falla de storage, que debe dejar un evento de falla y una excepción con el mismo valor de correlación. Un detalle que el post aclara: un header de idempotencia en una escritura saliente sirve, pero no reemplaza la deduplicación dentro de la transacción del consumidor.
Una inferencia nuestra: el store del ejemplo es un mapa en memoria sin sincronización, pensado para demostrar. En producción vas a necesitar algo atómico de verdad, como una restricción de unicidad en tu base de datos. Cubrimos ese tema en detalle en qué puede fallar al desplegar a producción.
¿Sentry, Datadog, Better Stack, Loki o Infrai: cuál conviene para este caso?
Ninguna gana en todos los casos; la elección depende de qué evidencia te falta y de cómo opera tu equipo. La tabla resume lo que dice el post, que es una sola fuente y que le dedica más espacio a Infrai, la herramienta que defiende el autor, así que tomalo con pinzas.
| Opción | Encaja bien en | Límite señalado |
|---|---|---|
| Sentry | Excepciones agrupadas, triage por release, source maps y session replay | Reconstruir el flujo de negocio exige breadcrumbs o logs estructurados; el cron silencioso necesita heartbeat aparte |
| Datadog | Logs, errores, trazas, métricas y monitores en una sola plataforma | Es amplio: hay que gobernar campos e ingesta para controlar el ruido |
| Better Stack | Logs con gestión de incidentes y uptime | Validar la profundidad del agrupado de excepciones y la retención |
| Grafana Loki | Agregación de logs en equipos que ya usan Grafana | Centrado en logs; el agrupado y el flujo de issues vienen de otro componente |
| Infrai | Integración REST con captura de excepciones e ingesta de logs bajo una sola clave | Sin alertas, árbol de spans, source maps, replay, heartbeat, borrado por usuario ni exportación masiva |
El propio post descarta Infrai si necesitás source maps, replay, symbolication nativa, notificaciones integradas o un árbol de spans; en ese caso sugiere Sentry o Datadog. Con Infrai, dice, tenés que armar el alerting por polling sobre la API de consulta.
Propuesta editorial (no viene de la fuente ni la probamos): elegí un incidente reciente de tu equipo y hacé las mismas preguntas a cada candidato. ¿Agrupa el crash? ¿Podés ver en orden los eventos de un job_id? ¿Detecta que una tarea no corrió? ¿Podés borrar los datos de un jugador? Las respuestas valen más que cualquier tabla de features.
¿Qué está confirmado y qué no?
- Confirmado por documentación oficial: el orden de agrupado de Sentry, el funcionamiento de pings, grace time y estados de Healthchecks.io, y el principio de OWASP de registrar cuándo, dónde, quién y qué.
- Afirmado solo por el post: la lista de ocho campos, el patrón GrantOnce, los límites de cada herramienta y las capacidades de Infrai (295 rutas en 20 módulos, según el propio post).
- No verificado: no hay benchmarks ni mediciones independientes de ninguna herramienta, y no probamos el código del post.
- Sin cubrir: precios y planes de las herramientas; la fuente no los trae.
Errores comunes
- Inferir éxito de la ausencia de errores. Si el job no arrancó, no hay nada que fallar. Corregilo con un heartbeat por cada tarea programada.
- Mandar rechazos de negocio al tracker. Un
duplicateesperado se vuelve un issue falso. Dejalo en logs con un result claro. - Nombrar distinto el campo de correlación en cada servicio. Un productor escribe
traceIdy otrotrace_id, y la búsqueda no cruza. Definí un solo nombre y revisalo en cada consumidor. - Confiar en el header de idempotencia para todo. No reemplaza la deduplicación dentro de la transacción del consumidor.
- Indexar mensajes de error únicos. Subí a campo indexado solo categorías estables.
Preguntas Frecuentes
¿Cuál es la diferencia entre error tracking y logging?
El error tracking agrupa excepciones en issues y muestra frecuencia, release y entorno. El logging registra la secuencia de eventos, incluidos los que no lanzan excepción. Un tercer rol, el heartbeat, detecta lo que nunca se ejecutó.
¿Cómo correlaciono un error de Sentry con mis logs usando un trace_id?
Generá un identificador en el borde, pasalo en el payload de la cola y escribilo con el mismo nombre de campo en los logs y en el evento de error. El post no detalla cómo adjuntarlo en Sentry; revisá la documentación del SDK que uses. El resultado es coincidencia de campos, no tracing distribuido. Tema relacionado: base de errores de GitHub Actions consultable.
¿Cómo detecto un cron job que nunca se ejecutó si no hay errores ni logs?
Con un monitor de heartbeat como Healthchecks.io: el job hace ping a una URL única y la plataforma alerta cuando el ping no llega dentro del período más el grace time. Con período de 1 hora y gracia de 5 minutos, la alerta sale a la hora y cinco.
¿Qué campos conviene incluir en un log estructurado?
Según el post: event, trace_id, job_id, tournament_id, player_id, attempt, result y error_class. OWASP suma el criterio general de registrar cuándo, dónde, quién y qué, con severidad. Mantené la lista corta para poder revisarla.
¿Cómo evito que un reintento de cola entregue un premio dos veces?
Deduplicá con una clave de negocio estable (por ejemplo job_id más player_id) en una operación atómica antes de otorgar el premio. Si el premio ya existe, registrá result=duplicate y devolvé éxito sin repetir el efecto.
Conclusión
La lección del post, publicado el 8 de octubre de 2026, es repartir roles y no buscar una herramienta mágica: tracker para familias de fallas, logs con ocho campos revisables para el orden de los eventos, heartbeat para lo que no corrió y deduplicación atómica en el consumidor. Esta semana, listá tus tareas programadas y verificá cuáles no tienen heartbeat; después definí un solo nombre de campo de correlación. Eso lo podés hacer sin cambiar de proveedor.
Para elegir herramienta, hacé la prueba con un incidente propio. La comparación del post viene de una sola fuente con interés en uno de los candidatos.
Fuentes
- Sentry Docs – Issue Grouping: fingerprints y algoritmos de agrupado de errores
- Healthchecks.io – Documentación oficial sobre pings, grace time y estados de los checks
- OWASP – Logging Cheat Sheet: eventos, atributos y almacenamiento de logs
- dev.to – Error Tracking vs Logging: Practical Correlation for SaaS Game Incidents