Cómo sincronizar activos JumpServer con aiopsterm en 2026
En pocas palabras: aiopsterm sincroniza el catálogo de hosts de JumpServer vía GET /api/v1/assets/hosts/, con límite de 100 páginas y timeout de 30 segundos por página; el token de la API queda separado de las credenciales SSH, y el catálogo local solo se actualiza si la respuesta remota valida sin errores, según la guía de TangGee del 24 de octubre de 2026.
TangGee, la organización que desarrolla aiopsterm, publicó el 24 de octubre de 2026 una guía que explica cómo sincronizar activos JumpServer con esta terminal de operaciones: aiopsterm llama a la API de hosts del bastión, separa el token de autenticación de las credenciales SSH, y solo actualiza el catálogo local si la respuesta remota completa valida sin errores.
JumpServer es una plataforma bastión (jump server) de código abierto que centraliza el acceso SSH a servidores y expone una API de assets para administrar ese catálogo. aiopsterm es una terminal de operaciones con soporte de IA, desarrollada por TangGee, que junta SSH, bastiones, bases de datos y Kubernetes en un mismo espacio de trabajo. La sincronización conecta ambos sistemas vía GET /api/v1/assets/hosts/, según la guía oficial de integración.
En este artículo:
- En 30 segundos
- ¿Qué separa el token de API de las credenciales SSH en esta integración?
- ¿Cuándo tiene sentido esta separación de boundaries y cuándo es excesiva?
- ¿Cómo funciona el endpoint de la API que usa aiopsterm para sincronizar activos JumpServer?
- ¿Qué límites y validaciones tiene el proceso de sincronización?
- ¿Qué pasa con los hosts existentes cuando se actualiza el catálogo?
- ¿Cómo se protege el token y las credenciales durante la integración?
- ¿Cómo se maneja la conexión SSH real y sus límites con SFTP y Kubernetes?
- ¿Qué checklist seguir para validar que la integración funciona correctamente?
- Errores comunes al sincronizar activos JumpServer con aiopsterm
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- aiopsterm sincroniza activos JumpServer vía
GET /api/v1/assets/hosts/con un límite de 100 páginas; cada página tiene un timeout de 30 segundos. - El Private Token de la API y las credenciales SSH del bastión son dos boundaries de seguridad separados: ninguno reemplaza al otro.
- El catálogo local solo se actualiza cuando todo el resultado remoto valida; una falla transitoria no borra nada.
- SFTP no funciona si la conexión cae a relay-shell: hace falta TCP forwarding o usar scp/rsync desde la terminal.
- Kubernetes vía JumpServer solo mapea activos: el streaming de comandos no está implementado y falla cerrado.
¿Qué separa el token de API de las credenciales SSH en esta integración?
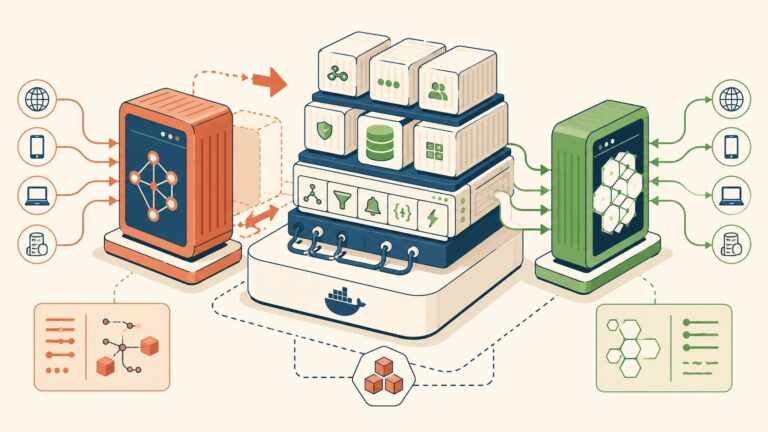
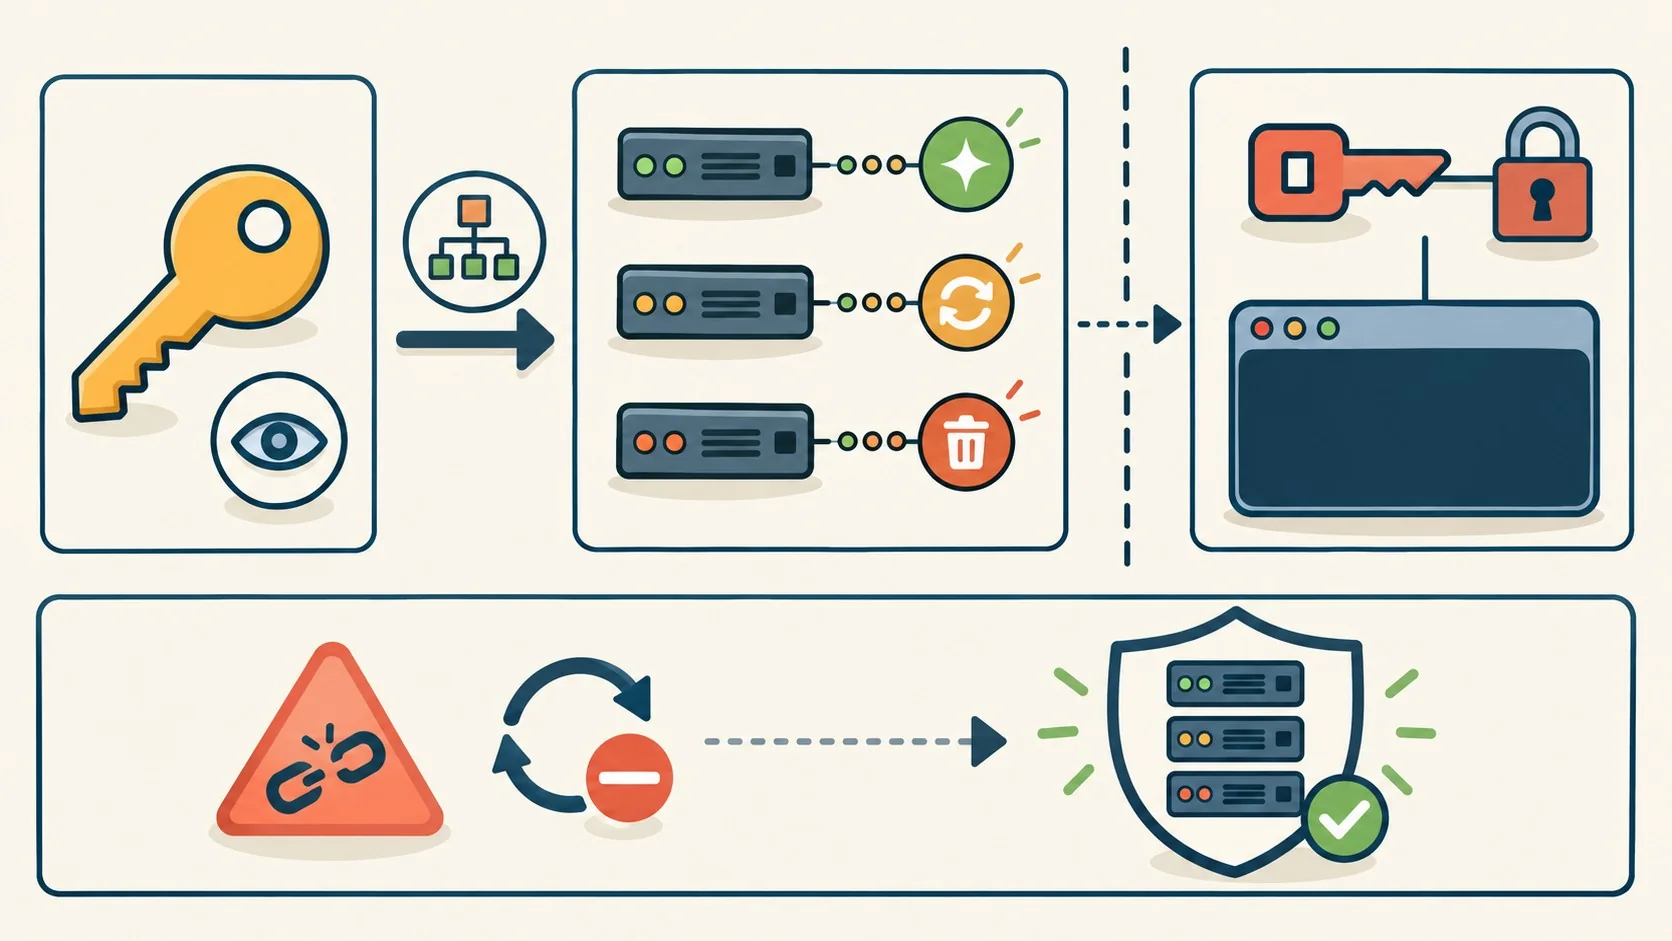
Un registro bastión en aiopsterm guarda dos conjuntos de configuración que nunca se mezclan. Por un lado está el root URL de JumpServer, el Private Token y el organization id, que sirven para llamar a la API y refrescar el catálogo. Por el otro, la dirección del bastión, el puerto SSH, el usuario y el password o key, que sirven para loguearse de verdad en la máquina.
El token no reemplaza a las credenciales SSH, y las credenciales SSH no pueden leer la API de assets. Son dos puertas distintas (con llaves distintas, ojo), y según la guía de TangGee cada una tiene que configurarse con mínimo privilegio de forma independiente. Si alguna vez armaste un pipeline de CI con un token que terminó teniendo más permisos de los que necesitaba, sabés por qué esto importa.
¿Cuándo tiene sentido esta separación de boundaries y cuándo es excesiva?
No toda integración necesita este nivel de aislamiento, pero acá hay una variable concreta que ayuda a decidir: ¿cuántas personas o procesos automatizados van a tocar el token de sincronización versus cuántos van a usar las credenciales SSH reales? Si son los mismos dos o tres administradores, separar boundaries agrega fricción sin mucho beneficio. Si el token de API va a vivir en un pipeline de CI, un script de inventario o una integración con otra herramienta (y las credenciales SSH las usan ingenieros distintos para conectarse a producción), la separación deja de ser burocracia y pasa a ser la diferencia entre un token filtrado que solo permite leer un catálogo y uno que termina abriendo una sesión en un servidor.
El criterio práctico, según lo que documenta la guía, es simple: el token de API nunca necesita más que lectura de host-assets en una organización. Si en algún momento te encontrás pidiendo permisos de escritura para ese token “para que sea más fácil”, es una señal de que estás mezclando los dos boundaries que la integración separa a propósito.
¿Cómo funciona el endpoint de la API que usa aiopsterm para sincronizar activos JumpServer?
aiopsterm construye un GET /api/v1/assets/hosts/?limit=100&offset=0 con dos headers: Authorization: PrivateToken <token> y, solo si configuraste un organization id, X-JMS-ORG: <id>. El root URL que metés en aiopsterm tiene que ser algo como https://jumpserver.example.com, sin el path de hosts pegado atrás.
Ese último punto parece obvio, pero es uno de los errores que más se repiten (lo detallamos más abajo). Para validar el token y el header de organización antes de guardar nada en aiopsterm, la guía recomienda correr algo así desde un entorno administrativo:
- Comando de validación:
curl -H "Authorization: PrivateToken $JMS_PRIVATE_TOKEN" -H "X-JMS-ORG: $JMS_ORG_ID" "https://jumpserver.example.com/api/v1/assets/hosts/?limit=100&offset=0" - Dónde no poner el token: nunca en código fuente, logs ni capturas de pantalla de un issue.
¿Qué límites y validaciones tiene el proceso de sincronización?
El cliente de aiopsterm pone un timeout de 30 segundos por página, un límite de seguridad de 100 páginas y sigue únicamente URLs de paginación next que sean same-origin respecto al root configurado. Acepta tanto una lista simple de JumpServer como una respuesta paginada con results y next.
¿Y si un proxy intermedio devuelve HTML en vez de JSON por un timeout del balanceador? Exacto, todo el refresh se cae, no se aplica nada a medias. Cualquier error de red, de autenticación, un HTTP no exitoso, una respuesta que no sea JSON o una paginación cross-origin hace fallar el proceso completo. Es una decisión de diseño conservadora, y tiene sentido: mejor un refresh que no pasa nada a uno que deja el catálogo a mitad de camino.
¿Qué pasa con los hosts existentes cuando se actualiza el catálogo?
aiopsterm mapea el id del host de JumpServer, nombre, dirección, puerto SSH, node path, status, type, category y comment. Con eso, actualiza por identidad remota dentro del alcance de bastión y organización seleccionado: lo que ya existe se refresca, lo nuevo se crea, y lo que desapareció del lado remoto (siempre que esté marcado como sincronizado para esa organización) se borra.
Ejemplo hipotético: pensemos en un catálogo con 40 hosts traídos por sync y 10 creados a mano en aiopsterm. Si en JumpServer se borra uno de esos 40, y después se corre el refresh en aiopsterm, debería caer solo ese host sincronizado: los 10 manuales y los de otras organizaciones quedarían intactos, porque el borrado explícito solo aplica a filas marcadas como JumpServer-synchronized para esa organización. Lo interesante, según el mismo mecanismo que describe la guía, es que los cambios se aplican recién después de que todo el resultado remoto valida: una falla de autenticación o de paginación a mitad de sync dejaría el catálogo existente sin tocar, sin borrados masivos por un corte transitorio.
¿Cómo se protege el token y las credenciales durante la integración?
El backend de aiopsterm cifra el Private Token antes de persistirlo en SQLite o en el almacenamiento de respaldo. Los snapshots normales de assets solo muestran un flag hasJumpserverToken, y los exports omiten el token por completo; el texto plano solo aparece a través del boundary dedicado para editar secretos.
- Token por entorno: usá un Private Token distinto para cada ambiente, no el mismo en dev y en prod.
- Rotación con test inmediato: rotá el token y corré un refresh de prueba enseguida para confirmar que sigue funcionando.
- Logs limpios: evitá que los reverse proxy logueen los headers
AuthorizationoX-JMS-ORG. - TLS válido: usá un certificado válido en el root URL; no dejes la verificación desactivada después de las pruebas.
¿Cómo se maneja la conexión SSH real y sus límites con SFTP y Kubernetes?
La sincronización solo descubre activos; la conexión real sigue usando el runtime SSH de aiopsterm. El TCP forwarding estándar a través del bastión es el camino preferido para el SSH secundario, con los diálogos de password, OTP y keyboard-interactive manejados dentro de aiopsterm.
Si el bastión rechaza el TCP forwarding, aiopsterm puede caer a relay-shell y correr SSH anidado en una terminal visible. El tema es que relay-shell no es un canal SSH estructurado, así que no soporta SFTP (spoiler: si necesitás transferir archivos por ahí, tenés que usar scp o rsync directo en la terminal). Sobre Kubernetes, los activos sincronizados se pueden mapear al catálogo, pero el streaming de comandos de JumpServer para Kubernetes no está implementado: conexión, refresh de recursos, terminal y acciones sobre ese source fallan de forma cerrada. Para operar un cluster de verdad hay que importar un kubeconfig usable directo.
¿Qué checklist seguir para validar que la integración funciona correctamente?
La guía de TangGee propone una secuencia de pruebas concreta antes de confiar en la sincronización en producción, y la verdad es que cubre los casos que importan.
- Validar con curl: probá token, header de organización y primera página antes de guardar nada en aiopsterm.
- Confirmar same-origin: revisá que cada URL
nextde paginación tenga el mismo origen que el root configurado. - Chequear exports: confirmá que los snapshots y exports normales no contienen el token.
- Correr el primer refresh: revisá conteos de creación, nombres, direcciones, puertos y node paths.
- Probar update estable: cambiá un activo remoto y refrescá; tiene que actualizar, no duplicar.
- Probar borrado selectivo: borrá un activo sincronizado y creá uno manual; solo debería caer el sincronizado.
- Probar con token malo: confirmá que el catálogo existente queda intacto ante una falla de autenticación.
- Separar boundaries de SSH: testeá bastión, SSH secundario, OTP y el límite de SFTP por separado.
| Boundary | Qué hace | Qué no hace |
|---|---|---|
| Token de API (Private Token + org id) | Lee el catálogo de hosts vía API para sincronizar | No loguea en el bastión ni mueve archivos |
| Credenciales SSH del bastión | Autentica la conexión real a la máquina | No puede leer la API de assets |
| TCP forwarding | Soporta SSH secundario y SFTP de forma estructurada | Depende de que el bastión lo permita |
| Relay-shell (fallback) | Permite SSH anidado visible cuando no hay TCP forwarding | No soporta SFTP |
| Kubernetes vía JumpServer | Mapea activos sincronizados al catálogo K8s | No hace streaming de comandos ni terminal |
Errores comunes al sincronizar activos JumpServer con aiopsterm
- Meter el path de hosts en el root URL: poner algo como
https://jumpserver.example.com/api/v1/assets/hosts/como root rompe las llamadas. El root va limpio, solo el dominio y el protocolo. - Reusar el mismo token en todos los ambientes: si dev y prod comparten Private Token, una rotación o un bug en uno afecta al otro. Un token por entorno evita ese dolor de cabeza.
- Asumir que SFTP siempre funciona por el bastión: si la conexión cae a relay-shell, SFTP no anda. Hay que usar scp o rsync en la terminal, o forzar un camino con TCP forwarding.
- Dar permisos de más al token de API: el token solo necesita lectura de host-assets en la organización correspondiente. Permisos de escritura ahí son una superficie de ataque innecesaria.
Preguntas Frecuentes
¿Cómo se sincroniza el catálogo de hosts de JumpServer con otra herramienta?
aiopsterm llama al endpoint GET /api/v1/assets/hosts/ de JumpServer usando un Private Token y, si corresponde, el header de organización. Trae los hosts paginados, los mapea por identidad remota y actualiza el catálogo local solo si toda la respuesta valida sin errores.
¿Qué permisos necesita el token de API de JumpServer para sincronizar assets?
Alcanza con acceso de solo lectura a host-assets en la organización que querés sincronizar. Dar permisos de escritura o de otras organizaciones es innecesario y aumenta el riesgo si el token se filtra.
¿Qué pasa si falla la sincronización, se borran los hosts existentes?
No. aiopsterm aplica los cambios solo después de que el resultado remoto completo valida; si hay un error de red, autenticación, HTTP, JSON o paginación cross-origin, el refresh entero se cancela y el catálogo sincronizado queda como estaba.
¿Por qué no funciona SFTP después de sincronizar un host de JumpServer?
Porque la conexión cayó a relay-shell en lugar de usar TCP forwarding estándar. Relay-shell no es un canal SSH estructurado y no soporta SFTP; la alternativa es usar scp o rsync directamente en la terminal.
¿Se puede usar JumpServer para conectarse a clusters de Kubernetes?
Los activos sincronizados se pueden mapear al catálogo de Kubernetes de aiopsterm, pero el streaming de comandos de JumpServer para Kubernetes no está implementado. Conexión, terminal y refresh de recursos fallan de forma cerrada; para operar un cluster real hace falta importar un kubeconfig usable.
Conclusión
Lo que publicó TangGee el 24 de octubre de 2026 no es una integración mágica, es un contrato de API bien delimitado: boundaries separados entre token y SSH, validación atómica antes de aplicar cambios, y límites explícitos en lo que no está resuelto (SFTP sobre relay-shell, streaming de comandos en Kubernetes). Si administrás un bastión JumpServer y pensás meterlo en aiopsterm, el checklist de la guía oficial no es opcional: probá el token con curl, confirmá el comportamiento ante un token malo, y separá las pruebas de SSH, OTP y SFTP antes de depender de esto en producción. El criterio de separación de boundaries que vimos antes —cuántas manos tocan el token versus cuántas tocan las credenciales SSH— sirve como guía rápida para decidir cuánto esfuerzo de aislamiento vale la pena en tu caso puntual. Lo que no está documentado (como el comportamiento exacto si el organization id cambia a mitad de camino) conviene probarlo en un entorno de prueba antes de confiar en el refresh automático.