Probar alertas Terraform sin romper la guardia
En pocas palabras: Se prueban separando tres capas en el repositorio de Terraform: infraestructura (Secret, ConfigMap, receptor), regla (condición, ventana, severidad) y entrega (plantilla, reintentos, timeout). Después del apply, un Job sintético en Kubernetes dispara un evento y exige evidencia de aceptación del receptor dentro de un timeout, sin depender solo del plan.
Probar alertas Terraform revisando solo el plan de cambios no evitó que un equipo se enterara tarde de una falla real: el monitor pasó a estado firing, pero el aviso tardó varios minutos en llegar porque nadie confirmó la entrega, según el caso documentado en dev.to.
Probar alertas Terraform es el proceso de verificar, antes de aplicar un cambio de infraestructura, que una regla se activa con el evento correcto y que el mensaje llega de forma comprobable a un receptor: webhook, correo o canal de guardia. No alcanza con leer el plan de Terraform. Hace falta separar infraestructura, regla y entrega, y guardar evidencia reproducible de que el aviso fue aceptado.
En este artículo:
- En 30 segundos
- ¿Por qué una alerta puede fallar aunque el plan de Terraform sea correcto?
- ¿Qué diferencia hay entre que la regla se active y que el mensaje llegue?
- Cómo separar infraestructura, regla y entrega en el código de Terraform
- Qué preguntas hacer antes de aplicar un cambio en las alertas
- Cómo probar alertas de Terraform con un Job reproducible en Kubernetes sin romper la guardia
- Qué evidencia registrar cuando una alerta real no llega
- Checklist antes de tocar el canal de guardia
- Errores comunes al probar alertas Terraform
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El síntoma real: un plan de Terraform sin cambios raros, un monitor en estado firing y un aviso que llegó varios minutos tarde porque nadie verificó la entrega.
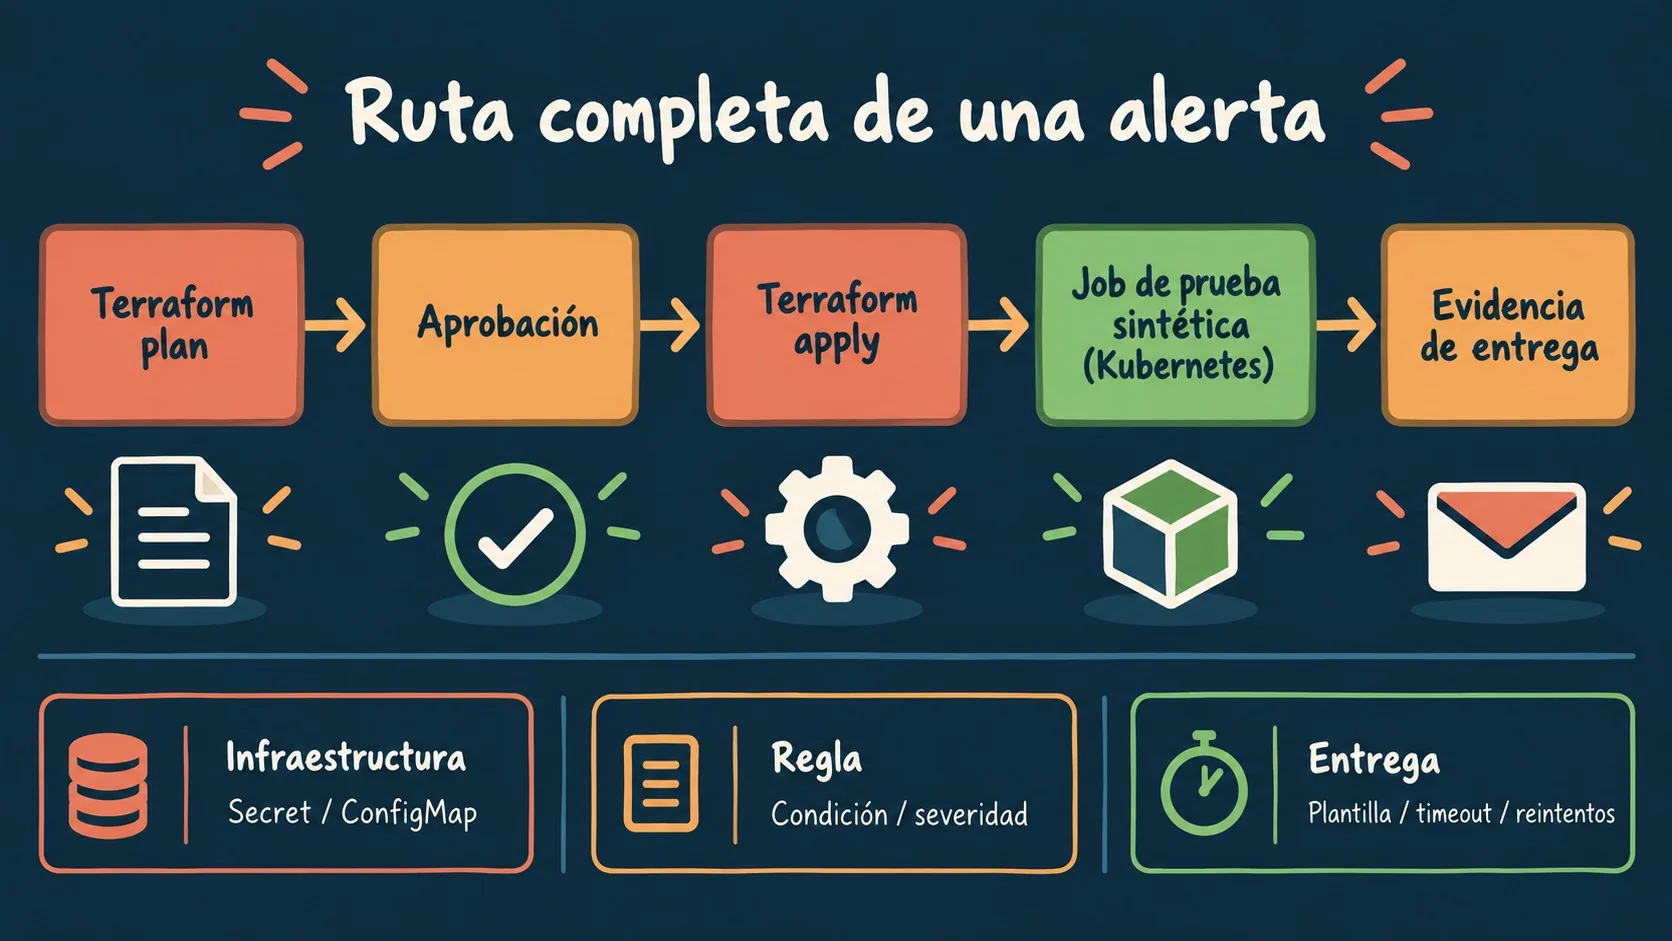
- Separar tres capas en el repositorio: infraestructura (Secret, ConfigMap, receptor), regla (condición, ventana, severidad) y entrega (plantilla, reintentos, timeout).
- Antes de aplicar, responder cinco preguntas: qué receptor cambia, qué secreto lee el workload, qué evento sintético dispara la alerta, dónde queda la evidencia y cómo se revierte.
- Un Job de Kubernetes de corta duración ejecuta la prueba sintética, con un límite de dos minutos para darla por fallida si no hay evidencia de entrega.
- Un HTTP 429 del receptor o un secreto rotado sin avisar son causas típicas de que la regla dispare pero el mensaje no llegue.
¿Por qué una alerta puede fallar aunque el plan de Terraform sea correcto?
Una alerta puede fallar aunque el plan de Terraform no muestre nada raro porque el plan certifica intención, no entrega. En el caso descripto en dev.to, el monitor pasó a firing y el equipo se enteró recién al mirar el panel manualmente, varios minutos después del evento.
El plan miente por omisión. No dice si el webhook devolvió un error, ni si el correo terminó en la carpeta equivocada.
La lección que sacó el equipo no fue revisar mejor el YAML. Fue tratar la notificación como una ruta completa (regla, proveedor, secreto, buzón y evidencia de entrega), porque cada eslabón puede romperse por separado y ninguno avisa solo.
¿Qué diferencia hay entre que la regla se active y que el mensaje llegue?
Que la regla se active responde una pregunta distinta a que el mensaje llegue: un alert firing en Prometheus confirma que la condición se cumplió, no que el receptor aceptó el aviso. Puede haber un HTTP 429 en el webhook o un correo perdido, y el estado seguiría diciendo firing igual. Complementá con levantar una VM en Azure con Terraform.
Ojo con esto: mezclar ambas preguntas es el error más común al gestionar alertas en Terraform. El plan es una revisión de intención, no una prueba de entrega, y confundir esas dos cosas es lo que deja a un equipo entero mirando un panel en plena guardia nocturna, preguntándose por qué nadie contestó, cuando la alerta, técnicamente, nunca dejó de estar ahí.
Tampoco conviene probar contra una cuenta personal ni con datos de clientes reales. Un buzón aislado, con retención de mensajes acotada y sin secretos en el cuerpo del correo, alcanza para validar la ruta sin exponer nada sensible.
Cómo separar infraestructura, regla y entrega en el código de Terraform
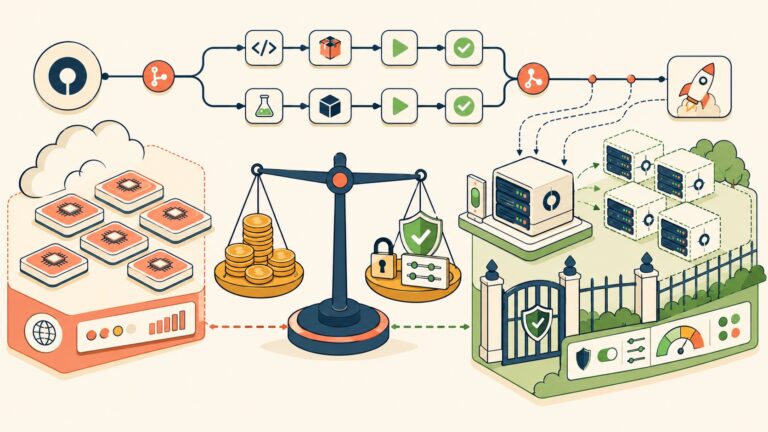
Separar infraestructura, regla y entrega en tres capas visibles del repositorio evita que un cambio de receptor arrastre, sin querer, una modificación de la ventana de evaluación. Cada capa tiene su propio diff y su propia responsabilidad.
- Infraestructura: Secret, ConfigMap, receptor y permisos. Es la capa que casi nunca debería cambiar en el mismo commit que la regla.
- Regla: condición, ventana de evaluación, severidad y etiquetas.
- Entrega: plantilla del mensaje, reintentos, timeout y respuesta del proveedor.
El secreto tiene que venir del gestor aprobado, nunca del archivo de Terraform ni de un log de CI. Una plantilla mínima necesita nombre de servicio, entorno, severidad, enlace al panel e identificador de incidente, sin el contenido del secreto ni la dirección completa del usuario.
En una ocasión el cuerpo del mensaje decía “dummy e mail” porque venía de un fixture viejo (spoiler: no rompió la entrega, pero sí confundió el diagnóstico durante un buen rato). En usar lifecycle rules para evitar recreaciones profundizamos sobre esto.
Qué preguntas hacer antes de aplicar un cambio en las alertas
Antes de un terraform apply sobre alertas, cinco preguntas reducen la mayoría de los sustos. Ninguna requiere herramientas nuevas, solo disciplina de revisión.
- Qué receptor cambia: confirmar si es el mismo canal de guardia o uno nuevo sin probar.
- Qué secreto lee el workload: verificar que venga del gestor aprobado, no de un archivo de Terraform.
- Qué evento sintético dispara la alerta: definir un identificador único para no confundirlo con un incidente real.
- Dónde queda la evidencia de aceptación: un log o un identificador de entrega que otro compañero pueda auditar.
- Cómo se revierte sin editar a mano: el rollback tiene que ser tan reproducible como el cambio.
Para cambios sensibles, guardar el plan y exigir aprobación del equipo propietario del canal de guardia. No es burocracia; es la diferencia entre revertir en dos minutos o pasar la noche buscando qué se tocó.
Cómo probar alertas de Terraform con un Job reproducible en Kubernetes sin romper la guardia
Probar alertas Terraform de forma reproducible en Kubernetes se resuelve con un Job de corta duración que publica un evento sintético y escribe un resultado chico: test_id, hora, entorno, código del receptor y estado final, sin guardar el token ni el correo completo.
El flujo de CI queda así: terraform plan, aprobación, terraform apply, Job de alerta sintética, comprobar respuesta del receptor, comprobar evidencia de entrega, guardar veredicto y limpiar. Un límite de dos minutos marca la prueba como fallida si no hay evidencia dentro de ese margen.
¿Qué pasa si el Job de prueba se queda dando vueltas en el clúster? Genera ruido, y un buzón lleno puede terminar ocultando el próximo mensaje real. La limpieza no es un detalle cosmético. Sobre eso hablamos en desplegar tu primer servidor en AWS.
Qué evidencia registrar cuando una alerta real no llega
Cuando una alerta real no llega, la misma evidencia en cada capa acorta la investigación. Sin eso, cada ingeniero termina inventando su propio método bajo presión, en medio de la noche.
- Versión del despliegue y hash del plan aplicado: para saber qué infraestructura estaba activa en el momento del fallo.
- Hora del evento y zona horaria: para no perder minutos discutiendo husos horarios en medio de un incidente.
- Estado de la regla y etiquetas recibidas.
- Código y latencia del receptor: ahí suele aparecer el famoso HTTP 429.
- Identificador de entrega, sin datos personales innecesarios.
- Último cambio de secreto o plantilla.
Un runbook chico de SRE evita esa improvisación y distingue “la regla nunca disparó” de “el proveedor rechazó el mensaje”. Son incidentes distintos, con rollback distinto.
Checklist antes de tocar el canal de guardia
Antes de aplicar cualquier cambio sobre el canal de guardia, siete puntos concretos reducen el riesgo de un aviso que no llega.
- El plan fue revisado y guardado.
- La regla sintética tiene un identificador único.
- El secreto se inyecta desde el gestor aprobado.
- El receptor devuelve una respuesta verificable.
- Hay evidencia de entrega sin tokens ni direcciones expuestas.
- El Job de prueba tiene timeout y limpieza.
- El rollback está probado en un entorno seguro.
Un criterio práctico para decidir cuánto automatizar esto: si tu canal de guardia tiene más de un receptor o rota secretos seguido, conviene tener el Job sintético corriendo en cada pipeline. Si es un canal chico con un solo webhook estable, una prueba manual documentada antes de cada cambio grande capaz alcanza. Esto es un criterio propio, no algo que la fuente haya probado o recomendado explícitamente.
Errores comunes al probar alertas Terraform
- Confundir firing con entregado: mirar el estado de Prometheus y dar por hecho que el aviso llegó, sin chequear la respuesta del receptor.
- Probar con datos reales: usar una cuenta personal o el buzón de clientes para la prueba sintética, lo que mezcla ruido de producción con la validación.
- Mezclar cambios en un mismo despliegue: rotar el secreto, cambiar la plantilla y modificar el receptor a la vez, lo que multiplica las causas posibles cuando algo falla.
- No limpiar el Job de prueba: dejarlo corriendo genera ruido y puede tapar la próxima alerta real.
Preguntas Frecuentes
¿Cómo se prueba una alerta sin que llegue realmente a la guardia?
Con un evento sintético etiquetado como entorno de pruebas, enviado a un receptor o buzón aislado, distinto del canal de guardia real. El resultado se valida por código de respuesta y evidencia de entrega, no por avisar a nadie en producción. Ya lo cubrimos antes en prepararte para la certificación Terraform Associate.
¿Por qué una alerta en estado firing no significa que se entregó?
Porque firing describe el estado de la regla en Prometheus, no la respuesta del receptor. El webhook puede devolver un HTTP 429 o el correo puede caer en spam, y la alerta seguiría marcada como activa igual.
¿Cómo separar infraestructura, regla y entrega de una alerta en Terraform?
Con tres capas en el repositorio: infraestructura (Secret, ConfigMap, receptor y permisos), regla (condición, ventana, severidad y etiquetas) y entrega (plantilla, reintentos, timeout y respuesta del proveedor). Cada capa tiene su propio diff, así un cambio de receptor no arrastra modificaciones accidentales de la regla.
¿Qué se registra cuando una alerta real no llega a destino?
Versión del despliegue y hash del plan, hora y zona horaria del evento, estado de la regla, código y latencia del receptor, identificador de entrega sin datos personales, y el último cambio de secreto o plantilla. Esos datos separan un fallo de regla de un rechazo del proveedor.
¿Cómo hacer una prueba reproducible de alertas en Kubernetes?
Con un Job de corta duración que dispara el evento sintético, espera la respuesta del receptor dentro de un timeout (por ejemplo dos minutos) y escribe un resultado chico con test_id, hora, entorno y código de respuesta. Después se limpia el Job para no dejar ruido en el clúster.
Conclusión
Lo que cambia con este caso no es una herramienta nueva, es el criterio: un plan de Terraform limpio no garantiza que la guardia se entere de nada. Separar infraestructura, regla y entrega, con un Job sintético reproducible y evidencia guardada, convierte una apuesta en algo auditable.
Si tu equipo toca canales de guardia con frecuencia, empezá por lo más barato: sumar el paso de comprobación de entrega al pipeline, aunque sea con un timeout simple. Lo caro no es escribir el Job, es descubrir en producción que nadie lo hizo.