AFPD: Microsoft refuerza la confiabilidad de Azure
En pocas palabras: Microsoft anunció el 4 de noviembre de 2026 el sistema Azure Failure Prediction and Detection (AFPD), que une predicción, detección, mitigación y remediación de fallas de hardware en Azure Compute. Usando machine learning y telemetría, anticipa fallas como las de discos SSD y redujo los reinicios en más del 36%.
AFPD es un sistema de Microsoft que combina modelos de machine learning con señales de telemetría operativa para anticipar fallas de hardware, como discos SSD, antes de que afecten un workload en producción. Cuando detecta un riesgo, mueve las cargas elegibles a infraestructura sana y avisa al cliente. Es la pieza central de la estrategia de confiabilidad de Azure Compute a noviembre de 2026.
En este artículo:
- En 30 segundos
- ¿Qué anunció Microsoft sobre la confiabilidad de Azure el 4 de noviembre de 2026?
- ¿Cómo predice y detecta fallas Azure con el sistema AFPD?
- ¿Qué relación tiene AFPD con Project Narya?
- ¿Cuánto reduce AFPD los reinicios y qué evidencia hay del impacto?
- ¿Qué consecuencia práctica tiene AFPD para workloads mission-critical en Azure?
- Errores comunes al interpretar el anuncio de AFPD
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Microsoft anunció AFPD el 4 de noviembre de 2026, un sistema que unifica predicción, detección, mitigación y remediación de fallas en Azure.
- AFPD redujo los reinicios en Azure en más del 36%, según la cobertura del anuncio.
- El sistema usa telemetría y modelos de ML para anticipar fallas de SSD y migrar workloads antes de que se caigan.
- AFPD se basa en Project Narya y mejora sus capacidades de predicción y mitigación para Azure Compute.
- Para workloads mission-critical, esto implica menos interrupciones no planificadas y notificaciones previas cuando se activa una mitigación.
¿Qué anunció Microsoft sobre la confiabilidad de Azure el 4 de noviembre de 2026?
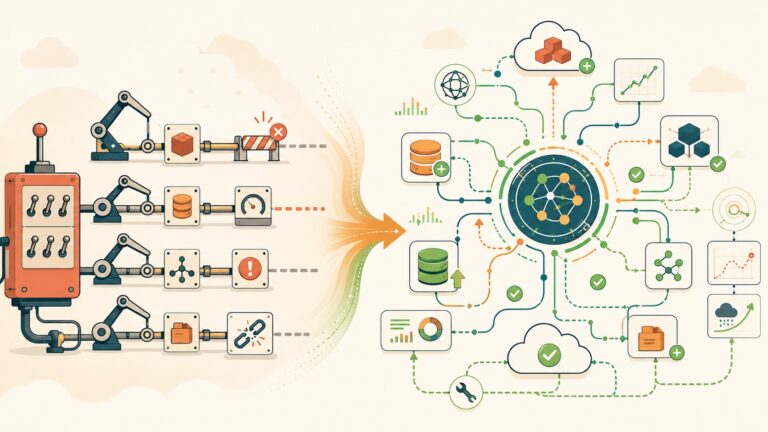
Microsoft presentó AFPD como un sistema integrado que reemplaza el enfoque fragmentado que tenía Azure para manejar fallas de hardware a escala. El objetivo declarado, según la cobertura del anuncio, es doble: evitar que las interrupciones lleguen a tocar workloads de clientes y permitir reparar nodos a escala sin depender de que un ingeniero detecte el problema a mano.
Hasta el anuncio de AFPD en noviembre de 2026, Azure dependía bastante de la reactividad: un disco fallaba, el nodo se caía, el sistema de orquestación reaccionaba y recién ahí entraba en juego la redundancia. AFPD cambia ese orden (spoiler: no es magia, es ML entrenado con años de telemetría real). La idea es anticiparse al problema, no responder después de que ya pasó.
¿Cómo predice y detecta fallas Azure con el sistema AFPD?
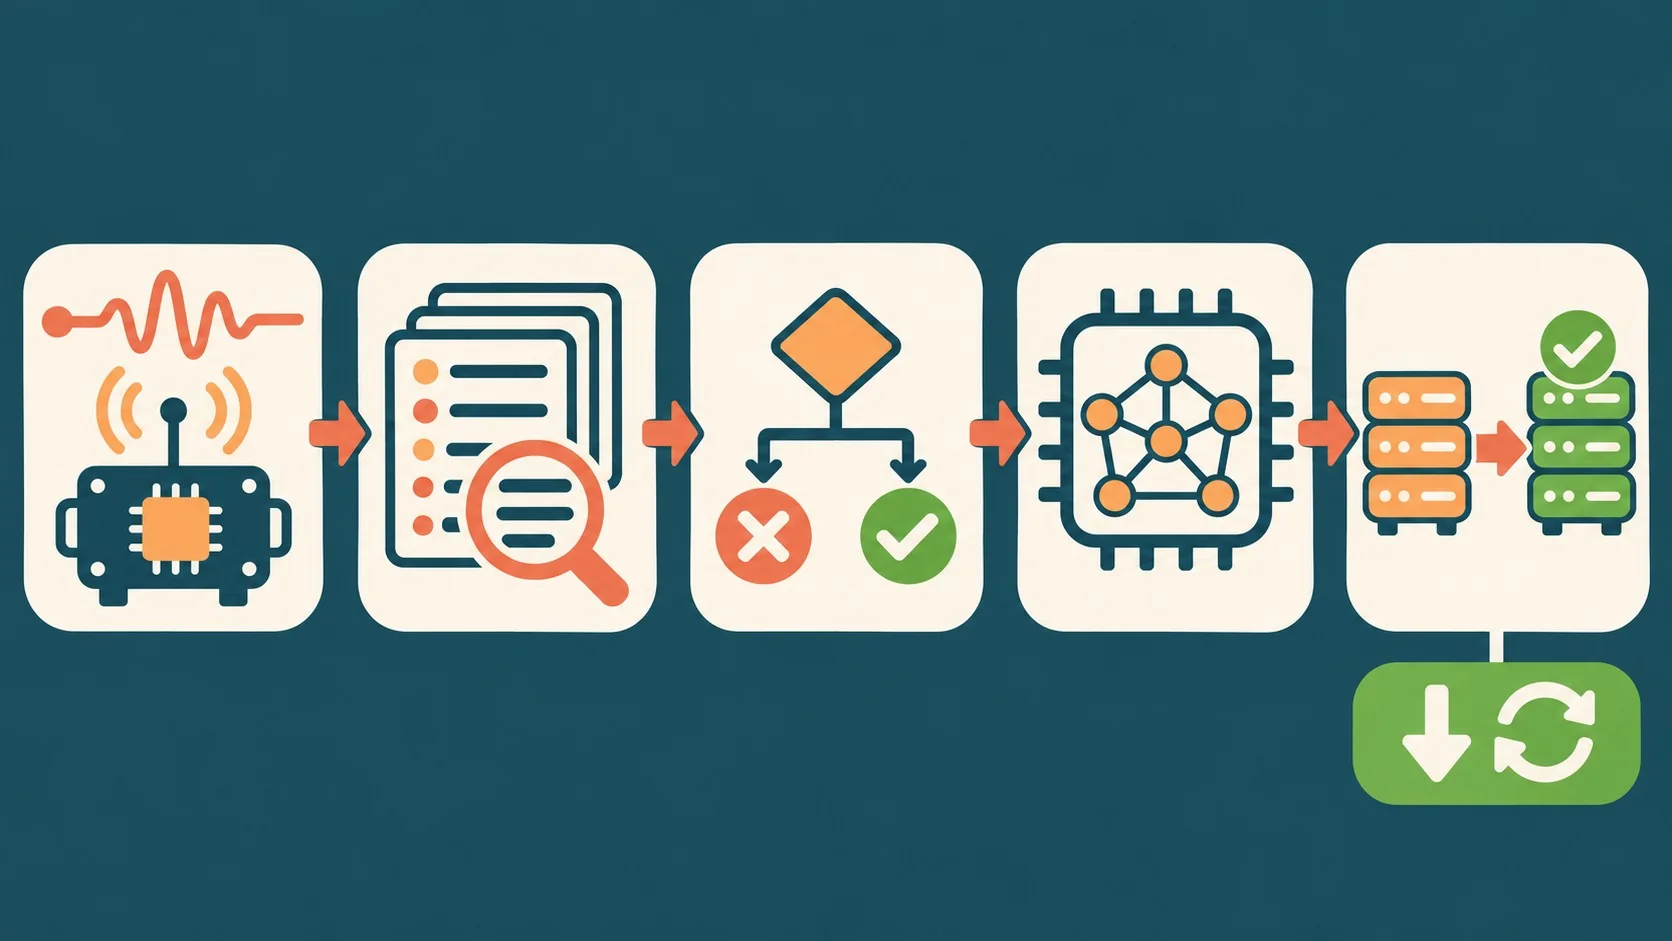
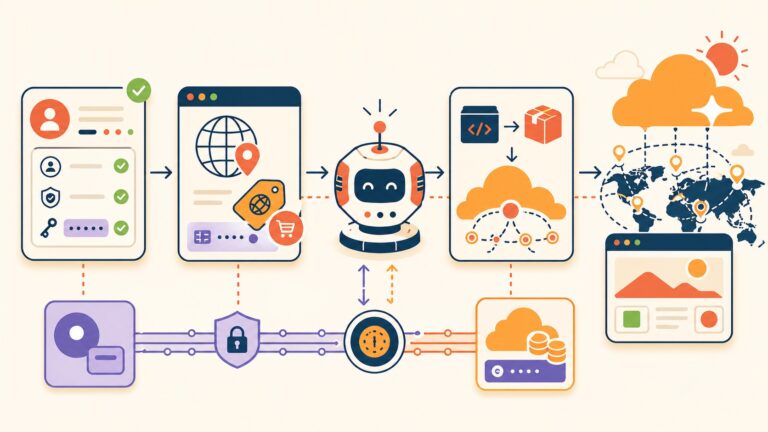
AFPD combina cuatro piezas: recolección de telemetría, parsing de logs, reglas de detección y motores de machine learning, según detalla el anuncio oficial. Estos componentes trabajan juntos para identificar señales tempranas de degradación de hardware, con los discos SSD como el ejemplo concreto que Microsoft usa para explicar el sistema. Más contexto en nuestra guía para conectarte por SSH a una VM.
Ponele que tenés una base de datos corriendo sobre un nodo cuyo SSD empieza a mostrar patrones de latencia raros. Antes, ese comportamiento pasaba inadvertido hasta que el disco fallaba de verdad y el workload se caía con él. Subís una carga crítica a Azure, confiás en que el hardware aguanta, todo funciona bien durante meses, hasta que un componente empieza a fallar de a poco, el problema pasa desapercibido y el resultado es un reinicio no planeado justo cuando menos lo necesitás. Con AFPD, el modelo de ML detecta la anomalía en la telemetría, dispara una alerta y el sistema mueve la carga elegible a infraestructura sana antes de que pase a mayores, notificando al cliente en el proceso.
¿Funciona siempre? No del todo. La migración “automática” aplica solo a workloads elegibles, lo que deja afuera a ciertas configuraciones específicas que Microsoft no detalla con precisión en el anuncio.
¿Qué relación tiene AFPD con Project Narya?
AFPD no arranca de cero: es la evolución de Project Narya, el sistema de predicción y mitigación de fallas que Microsoft Research documentó años antes en el paper presentado en OSDI 2020. Esto es contexto histórico, no parte del anuncio actual.
Narya ya aplicaba modelos predictivos para anticipar fallas de nodos en la infraestructura de Azure. Lo que hace AFPD es unificar y ampliar esas capacidades específicamente para Azure Compute, integrando en un solo sistema lo que antes estaba más repartido entre distintos componentes de mitigación. Cubrimos ese tema en detalle en nuestra nota sobre certificarte en Azure según tu rol.
¿Cuánto reduce AFPD los reinicios y qué evidencia hay del impacto?
AFPD redujo el número total de reinicios en Azure en más del 36%, según la cobertura del anuncio publicado el 4 de noviembre de 2026. Es la cifra central del anuncio y la que sostiene el argumento de que el sistema mejora la confiabilidad de Azure de forma medible, no solo teórica.
Un reinicio menos no es poca cosa cuando hablamos de workloads stateful o con SLA estricto. La reducción directa en reinicios se traduce en menos ventanas de interrupción, lo que para una app mission-critical significa menos tickets de soporte, menos reclamos de clientes y, en teoría, menos horas de ingeniería apagando incendios. Eso sí: el dato viene del propio fabricante, así que tomalo como punto de partida, no como verificación independiente.
¿Qué consecuencia práctica tiene AFPD para workloads mission-critical en Azure?
Para quien diseña arquitectura sobre Azure, AFPD implica depender menos de redundancia manual armada a mano, porque buena parte de la gestión de fallas de hardware queda del lado de la plataforma. Eso no elimina la necesidad de diseñar para fallas, pero sí cambia el punto de partida. Tema relacionado: comparativa entre Microsoft y GitHub.
El límite real está en que AFPD reduce riesgo, no lo elimina. Las notificaciones a clientes sirven para validar que la mitigación automática funcionó o para prepararse ante una disrupción que, aunque minimizada, puede seguir ocurriendo. Si gestionás proyectos que no necesitan la escala de un hyperscaler, vale la pena comparar con proveedores de hosting administrado como donweb.com, que se encargan de la capa de hardware para cargas más chicas sin que tengas que pensar en SSDs ni telemetría.
Errores comunes al interpretar el anuncio de AFPD
- Pensar que AFPD elimina el downtime. Reduce reinicios en más del 36%, pero no garantiza cero interrupciones.
- Asumir que la migración aplica a todo workload. Solo se mueven las cargas que el sistema marca como elegibles, no todas las configuraciones.
- Confundir AFPD con Project Narya. Narya fue el antecesor; AFPD unifica y amplía esas capacidades para Azure Compute.
- Ignorar las notificaciones de Azure al activar una mitigación. Son la señal de que una mitigación se activó, no un detalle a pasar por alto.
Preguntas Frecuentes
¿Qué es AFPD en Azure?
AFPD (Azure Failure Prediction and Detection) es el sistema de Microsoft que unifica predicción, detección, mitigación y remediación de fallas de hardware en Azure. Usa telemetría y modelos de machine learning para anticipar fallas, como las de discos SSD, antes de que afecten workloads de clientes.
¿Cuándo anunció Microsoft el sistema AFPD?
Microsoft anunció AFPD el 4 de noviembre de 2026. El anuncio incluyó la arquitectura del sistema y el dato de reducción de reinicios como evidencia de impacto.
¿AFPD reemplaza a Project Narya?
No exactamente: la fuente indica que AFPD se basa en Project Narya y mejora sus capacidades de predicción y mitigación, específicamente para Azure Compute, pero no lo describe como un reemplazo. Narya sigue siendo el antecedente documentado en el paper de OSDI 2020, y AFPD es la evolución más reciente. Para más detalles técnicos, mirá repos de Microsoft comprometidos con malware.
¿AFPD elimina por completo el riesgo de caídas en Azure?
No. AFPD reduce reinicios en más del 36% según la cobertura del anuncio, pero no elimina el riesgo de fallas. La mitigación proactiva disminuye la probabilidad de impacto, no la garantiza en cero.
¿Qué tipo de fallas predice AFPD?
El ejemplo concreto que da Microsoft son las fallas de discos SSD, detectadas mediante patrones anómalos en la telemetría del hardware. El sistema está diseñado para extenderse a otros componentes físicos dentro de la infraestructura de Azure Compute.
Conclusión
Lo que cambió el 4 de noviembre de 2026 es concreto: Azure pasó de un modelo de reacción ante fallas a uno de anticipación, con un número que lo respalda (36% menos reinicios, según la cobertura del anuncio). Para equipos que corren workloads mission-critical sobre Azure, esto es una razón real para revisar cómo está armada la redundancia propia, no para eliminarla. La recomendación práctica es simple: seguí monitoreando las notificaciones que envía Azure cuando se activa una mitigación durante los próximos meses y comparalo con tu propia tasa histórica de incidentes antes de asumir que el problema de fallas de hardware quedó resuelto del todo.