Caída de GitHub Actions: deploys frenados y plan B
En pocas palabras: Los deploys se frenaron por una degradación de GitHub Actions el 5 de octubre de 2026, no por un bug propio: entre las 18:48 y las 22:49 UTC, el 14,3% de los workflow runs en runners de GitHub no arrancó en cinco minutos. Los self-hosted no se vieron afectados.
Un equipo contó en dev.to el 7 de octubre de 2026 que una caída de GitHub Actions le frenó los deploys unas seis horas: los jobs quedaban en “queued” sin fallar y el código no tenía nada que ver. Armaron runners self-hosted de emergencia para no depender solo de GitHub.
GitHub Actions es el servicio de CI/CD de GitHub: ejecuta workflows definidos en archivos YAML dentro de .github/workflows para compilar, testear y deployar código. Cada job corre en un runner, que puede ser hosteado por GitHub o self-hosted, o sea una máquina propia que consulta a GitHub si hay trabajo. Un job en “queued” espera que el scheduler le asigne un runner. No falló, todavía no empezó.
En este artículo:
- En 30 segundos
- ¿Por qué los jobs de GitHub Actions quedan en “queued” sin fallar?
- ¿Cómo saber si la caída de GitHub Actions es de GitHub o de tu workflow?
- ¿Qué registró GitHub Status sobre Actions en octubre de 2026?
- ¿Qué hacer si GitHub Actions está caído y tenés que deployar un hotfix?
- ¿Cómo armar un runner self-hosted de emergencia para CI/CD?
- ¿Cómo automatizar el cambio al plan B antes del próximo incidente?
- ¿Qué está confirmado y qué no?
- ¿Qué errores comunes aparecen en una caída de Actions?
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El relato: un PR con un hotfix de facturación tuvo los checks en “queued” 40 minutos y después más de una hora. A las 3 PM había tres personas preguntando si los deploys estaban rotos.
- Lo que dice GitHub Status: el 5 de octubre de 2026, entre las 18:48 y las 22:49 UTC, el 14,3% de los workflow runs en runners hosteados y el 26,5% de los jobs no arrancaron en cinco minutos.
- Lo que no está verificado: que el relato corresponda a ese incidente. Las fechas y la duración no coinciden con claridad.
- La solución del equipo: runners con el label emergency-capable fuera de la flota de GitHub y un script que consulta la status API antes de cada deploy.
¿Por qué los jobs de GitHub Actions quedan en “queued” sin fallar?
Un job queda en “queued” cuando el workflow ya se disparó pero GitHub todavía no le asignó un runner. No hay error porque el código nunca empezó a ejecutarse: el job espera capacidad. Por eso un cambio en el YAML casi nunca lo explica, salvo que pidas un label de runner que no existe.
El caso: miércoles, 2 PM, un hotfix de un bug de facturación en un PR aprobado y los checks sin terminar. No fallaban, seguían en cola (spoiler: nadie los había roto). Según el relato de Rohit, fundador de Krova Cloud, pasaron 40 minutos, después más de una hora, y a las 3 PM ya había tres personas preguntando si los deploys estaban rotos. Alguien soltó que “GitHub’s probably just slow today”, el “probablemente no es nada” de la ingeniería.
¿Alguien verificó la duración de forma independiente? Todavía no. El título habla de seis horas y el texto no da la cronología completa, así que tomalo como testimonio de un autor y no como medición.
¿Cómo saber si la caída de GitHub Actions es de GitHub o de tu workflow?
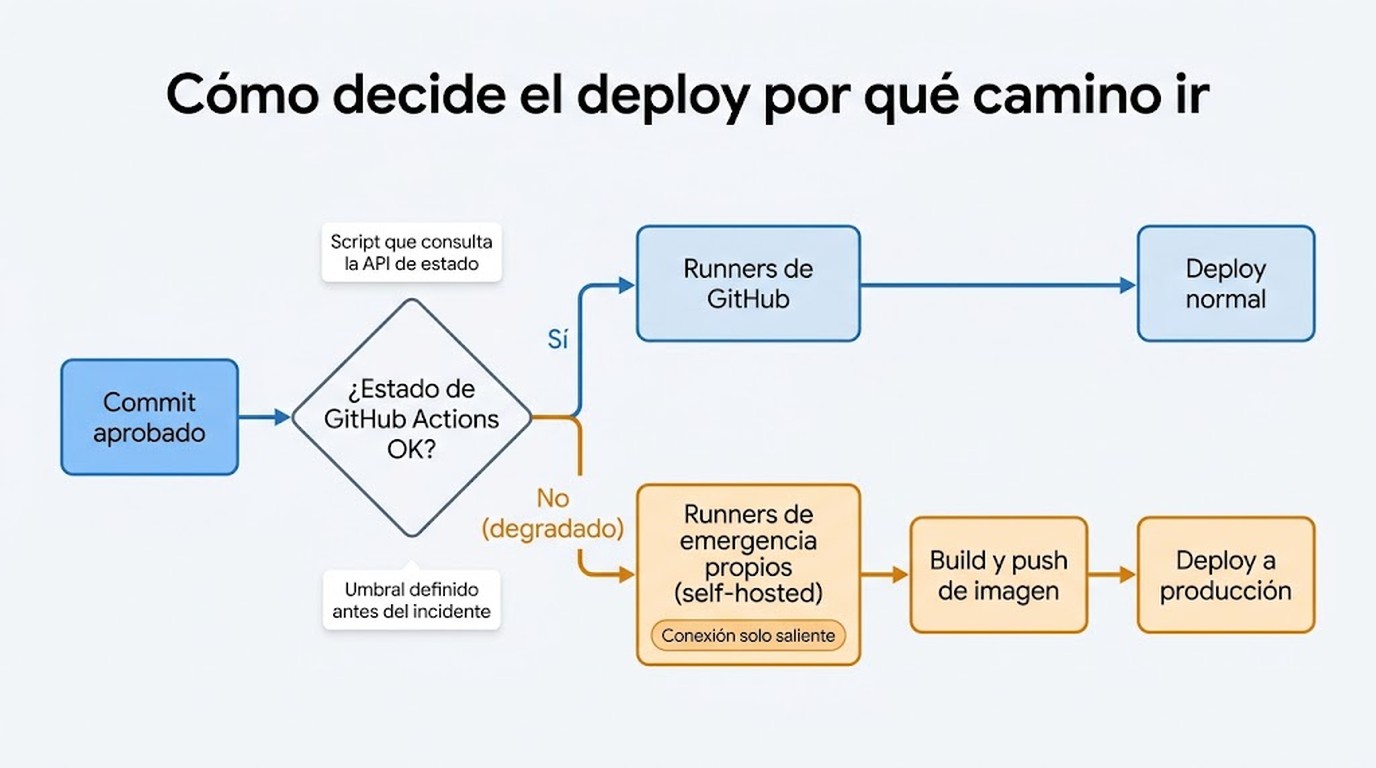
Abrí githubstatus.com antes de tocar nada. Si Actions figura degradado, el problema probablemente no es tuyo; si figura operativo, ahí sí revisá tu YAML, tus runners y tu cuota. El equipo del relato hizo el camino inverso y descartó tres hipótesis internas primero.
- Hipótesis 1, el workflow. Revirtieron el paso de caché que alguien había agregado a deploy.yml dos días antes. Los jobs siguieron en cola.
- Hipótesis 2, los self-hosted runners. Estaban vivos, inactivos y haciendo polling sin problemas, pero sin recibir trabajo. Eso apuntaba al scheduler de GitHub y no a los runners.
- Hipótesis 3, permisos o facturación. El dashboard de uso de Actions no mostraba nada raro: ni avisos de cuota ni alertas de billing.
Recién entonces miraron la página de estado, que según el autor mostraba Actions y otros servicios degradados o caídos a nivel mundial, hacía varias horas. Su lección es revisar el status page temprano, como hipótesis a chequear y no como último recurso. Más contexto en comparativa de herramientas de CI/CD en 2026.
Un criterio práctico, que es propuesta editorial (no viene de la fuente ni lo probamos nosotros):
- Mirá el estado oficial primero. Si Actions no está en verde, frená el debugging interno.
- Corré un workflow mínimo en otro repo. Ejemplo hipotético: un job que solo hace echo. Si también queda en cola, apunta a capacidad de GitHub y no a tu configuración.
- Fijate el estado de tus runners self-hosted. Online, inactivos y sin recibir trabajo es la señal que vio el equipo.
- Revertí cambios del YAML solo con el status en verde.
En githubstatus.com podés suscribirte por email, SMS, Slack, webhooks y feed Atom o RSS. Con un webhook te enterás cuando GitHub crea, actualiza o resuelve un incidente, sin acordarte de mirar.
¿Qué registró GitHub Status sobre Actions en octubre de 2026?
Según GitHub Status, el 5 de octubre de 2026, entre las 18:48 y las 22:49 UTC, GitHub Actions y los runners hosteados tuvieron rendimiento degradado. En todo el incidente, el 14,3% de los workflow runs en runners hosteados y el 26,5% de los jobs individuales no arrancaron dentro de los cinco minutos. En los unos 90 minutos de mayor impacto, el 47,0% de los runs falló y el 71,9% de los jobs tardó más de cinco minutos en arrancar.
GitHub atribuyó el incidente a una falla parcial de red entre una región de datacenter on-premises y un subconjunto de servicios regionales de base de datos y almacenamiento en la nube. Mitigó moviendo el tráfico a regiones sanas y sumando capacidad de cómputo; Actions se recuperó a las 21:54 UTC y todo lo afectado a las 22:49 UTC.
Esa semana hubo más ruido en la misma página:
- 1 de octubre, demoras de hasta diez minutos. GitHub reportó retrasos en el arranque de runs (primero Ubuntu, después Windows), con throttling y errores 429 en una dependencia upstream de Azure. Se resolvió a las 17:56 UTC.
- 1 de octubre, estado perdido. Hacia las 02:00 UTC, una falla de infraestructura aislada hizo que Actions perdiera el estado de ejecución de unos pocos runs existentes. GitHub pidió lanzar un run nuevo o contactar a soporte.
Ahora bien, ojo con atar cabos de más. En su resumen del 5 de octubre, GitHub escribió: “Self-hosted runners were not affected” (los self-hosted runners no se vieron afectados). En el relato, los runners propios estaban inactivos y sin trabajo. Además, el 5 de octubre fue lunes y duró unas cuatro horas, mientras el autor habla de un miércoles y seis horas, y el snapshot de la página que tenemos no muestra incidentes el 7 de octubre. Nada de eso prueba que sean incidentes distintos, pero tampoco deja afirmar que sea el mismo. Tema relacionado: qué conviene elegir entre Jenkins y GitHub Actions.
¿Qué hacer si GitHub Actions está caído y tenés que deployar un hotfix?
Si el hotfix afecta a clientes y Actions no asigna runners, la salida es construir y deployar fuera de GitHub, pero dejando registro de quién deploya, desde dónde y con qué credenciales. El equipo del relato lo hizo a mano. Funcionó, y el propio autor lo describe como algo que no querés que sea tu rutina de martes a la tarde.
Armaron la imagen del contenedor en una notebook, la subieron al registry a mano, corrieron el script de deploy local contra producción con credenciales reales, y todo lo que pasó entre el commit y el servidor quedó afuera del CI, sin checks, sin logs compartidos y con llaves de producción viviendo en una máquina personal, que es la “solución” que uno improvisa a las 3 PM con soporte pidiendo novedades.
El problema de fondo no fue el bug. Tests, builds, push de imágenes y el trigger del deploy corrían todos en infraestructura hosteada de GitHub, sin fallback. En palabras del autor, “most of the time isn’t all of the time”: que un proveedor ande bien casi siempre no te cubre el día que no.
Si te toca el deploy manual, propuesta editorial: que lo apruebe una segunda persona, anotá el SHA que subiste y rotá las credenciales usadas apenas pase el incidente. Relacionado: armar un pipeline seguro hasta producción.
¿Cómo armar un runner self-hosted de emergencia para CI/CD?
Un runner self-hosted de emergencia es una máquina propia, registrada en GitHub con un label dedicado, que construye y deploya los dos o tres servicios críticos cuando los runners hosteados no responden. El equipo no reemplazó GitHub Actions. Sumó un camino mínimo y aburrido, y el job quedó así:
jobs:
 build-and-push:
 runs-on: [self-hosted, emergency-capable]
 timeout-minutes: 20
 steps:
 - uses: actions/checkout@v4
 - name: Build image
 run: docker build -t registry.internal/api:${ github.sha } .
 - name: Push image
run: docker push registry.internal/api:${ github.sha }- Fuera de la flota de GitHub. El label emergency-capable apunta a máquinas que controla el equipo, no a capacidad prestada.
- Polling saliente. Los runners consultan a GitHub por conexión outbound-only, sin abrir ningún puerto entrante.
- Dos permanentes, chicos y baratos. Se mantienen siempre prendidos para que “GitHub Actions degradado” deje de significar “no podemos shippear”.
Una aclaración de transparencia: el autor es fundador de Krova Cloud y sus runners viven ahí. Sus argumentos (billing por minuto, levantar un tercer runner en menos de un minuto desde un snapshot) son del proveedor hablando de su producto, así que tomalos con pinzas. El patrón sirve con cualquier infraestructura propia. Si querés la máquina en Argentina, un VPS de donweb.com alcanza para probar el esquema; dimensionalo según tu build, porque la fuente no da especificaciones. Y no uses runners propios con repos públicos que acepten PRs de forks sin pensar el riesgo antes.
Acá hay un hueco que la fuente no cierra. Si el que falla es el scheduler de GitHub, como sospechó el equipo cuando sus runners propios quedaron sin trabajo, un runner self-hosted también se queda esperando. Este camino cubre bien la falta de capacidad hosteada, y probablemente no cubra una caída del orquestador. Para ese caso necesitás un deploy que no dependa de Actions.
¿Cómo automatizar el cambio al plan B antes del próximo incidente?
Definí el disparador y el umbral antes del incidente. El equipo agregó un script que consulta la status API de GitHub antes de cada deploy y rutea al camino self-hosted si la disponibilidad de Actions baja de un umbral, sin decisión manual. A las 3 PM, con clientes escribiendo a soporte, es el peor momento para discutir si “degradado” cuenta como “suficientemente grave”.
Lo que no sabemos: la fuente no informa el valor del umbral, no muestra el script y no trae métricas posteriores. Tampoco dice si el plan B se probó después del incidente. Propuesta editorial: ensayalo con un deploy a staging por el camino de emergencia cada tanto, porque un fallback que nunca se ejercita también puede fallar. El autor calcula que armar la versión aburrida lleva una hora. Esto se conecta con lo que analizamos en errores de trust policy con OIDC en AWS.
¿Qué está confirmado y qué no?
Confirmado por GitHub Status
- Incidente del 5 de octubre de 2026. Entre 18:48 y 22:49 UTC, con las cifras de arriba y los self-hosted runners sin afectación.
- Demoras del 1 de octubre. Atribuidas a throttling en una dependencia upstream de Azure.
- Runs trabados por pérdida de estado. GitHub recomienda “Re-run all jobs” o contactar a soporte.
Pendiente o sin verificar
- Que el relato sea el incidente del 5 de octubre. Fechas, duración y comportamiento de los runners no encajan con claridad.
- Las seis horas. Es el título del autor; el texto no las detalla.
- La efectividad del plan B. No hay métricas ni el umbral usado.
¿Qué errores comunes aparecen en una caída de Actions?
- Revertir el YAML antes de mirar el status. Es lo que hizo el equipo y perdió tiempo. Corrección: status page primero, cambios después.
- Relanzar runs sin revisar qué ya se deployó. GitHub avisa que “Re-run all jobs” conserva el ID del run, pero rehace artefactos y pide aprobaciones nuevas. Antes de relanzar, chequeá si algún paso de deploy ya se completó.
- Asumir que los self-hosted te cubren siempre. En el incidente del 5 de octubre no se vieron afectados, pero en el relato quedaron sin trabajo. Probá tu plan B contra los dos escenarios.
- Dejar el deploy manual como costumbre. Una notebook con credenciales de producción es emergencia, no proceso.
Preguntas Frecuentes
¿Por qué mi workflow de GitHub Actions queda en queued?
Queda en “queued” porque GitHub todavía no le asignó un runner. Puede ser una degradación del servicio, como el incidente del 5 de octubre de 2026 en runners hosteados, o un label de runner que no existe. Confirmá el estado en githubstatus.com antes de tocar el YAML.
¿Cómo sé si GitHub Actions está caído o es un problema mío?
Mirá githubstatus.com: si Actions figura degradado o con interrupción, el problema es de GitHub. Si figura operativo, revisá tu workflow, el estado de tus runners y tu cuota de uso. También podés suscribirte por email, SMS, Slack o webhook.
¿Qué hago si GitHub Actions no funciona y tengo que subir un hotfix?
Si el hotfix es urgente, podés construir y deployar a mano desde una máquina controlada, como hizo el equipo del relato. Es una medida de emergencia riesgosa: usa credenciales de producción sin trazabilidad de CI. Dejá registrado el SHA y rotá las credenciales después.
¿Los self-hosted runners siguen funcionando si GitHub Actions tiene una caída?
Depende del incidente. GitHub informó que el 5 de octubre de 2026 los self-hosted runners no se vieron afectados, pero en el relato de dev.to los runners propios quedaron inactivos sin recibir trabajo. Si falla el scheduler, probablemente también esperen.
¿Cómo configurar un plan B para el deploy cuando falla GitHub Actions?
Registrá dos runners propios con un label dedicado, como emergency-capable, que construyan y deployen solo los servicios críticos. Sumá un script que consulte el estado de GitHub antes del deploy y cambie de camino bajo un umbral definido de antemano. Probalo periódicamente.
Conclusión
Lo que cambió es la prueba concreta de que un pipeline entero en runners hosteados puede quedar en cero sin un solo error de tu lado. GitHub Status documentó en octubre de 2026 al menos dos incidentes de Actions con jobs demorados, y el relato de dev.to muestra qué cuesta no tener plan B.
Qué hacer: suscribite a los avisos de estado, definí el umbral de cambio antes del próximo incidente, armá un runner propio para tus dos o tres servicios críticos y ensayalo. Y no te quedes con que el self-hosted lo resuelve todo: si cae el orquestador, necesitás un deploy que no dependa de Actions.