Plan de recuperación ante desastres: la guía sin vueltas
En pocas palabras: Un plan de recuperación ante desastres funciona si define RPO (cuánta data perdés, ej. 24hs con backup nocturno) y RTO (cuánto tardás en volver), e incluye backups en cuenta separada, restaurados y cronometrados al menos una vez por trimestre.
Un equipo de software chico suele tener backups automáticos configurados y asumir, sin pensarlo mucho, que con eso ya está cubierto. El problema es que esa suposición no dice nada sobre lo que realmente importa: cuánta data podés perder (RPO), cuánto tiempo podés estar caído (RTO) y si alguien, alguna vez, restauró ese backup para comprobar que sirve para algo.
Un plan de recuperación ante desastres es el documento que define cómo tu equipo vuelve a operar después de perder infraestructura, datos o acceso a cuentas críticas. Según el análisis publicado por Mecanik, la mayoría de los equipos chicos tiene la frase “los backups están activados” en un documento que nadie volvió a abrir, lo cual no dice nada sobre si esa data sirve para algo.
En este artículo:
- En 30 segundos
- ¿Qué diferencia hay entre tener un backup y tener un plan de recuperación ante desastres?
- ¿Qué son el RPO y el RTO y quién los tiene que definir?
- ¿Por qué un backup que nunca se probó no es un backup?
- ¿Por qué un backup en la misma cuenta no alcanza?
- ¿Qué componentes se olvidan al armar el inventario de disaster recovery?
- ¿Cómo armar un plan de recuperación que se pueda seguir a las 3 de la mañana?
- ¿Un equipo de software chico necesita un hot standby en otra región?
- Errores comunes al armar disaster recovery en equipos chicos
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- RPO y RTO son decisiones de negocio, no técnicas: definen cuánta data perdés y cuánto tiempo estás caído.
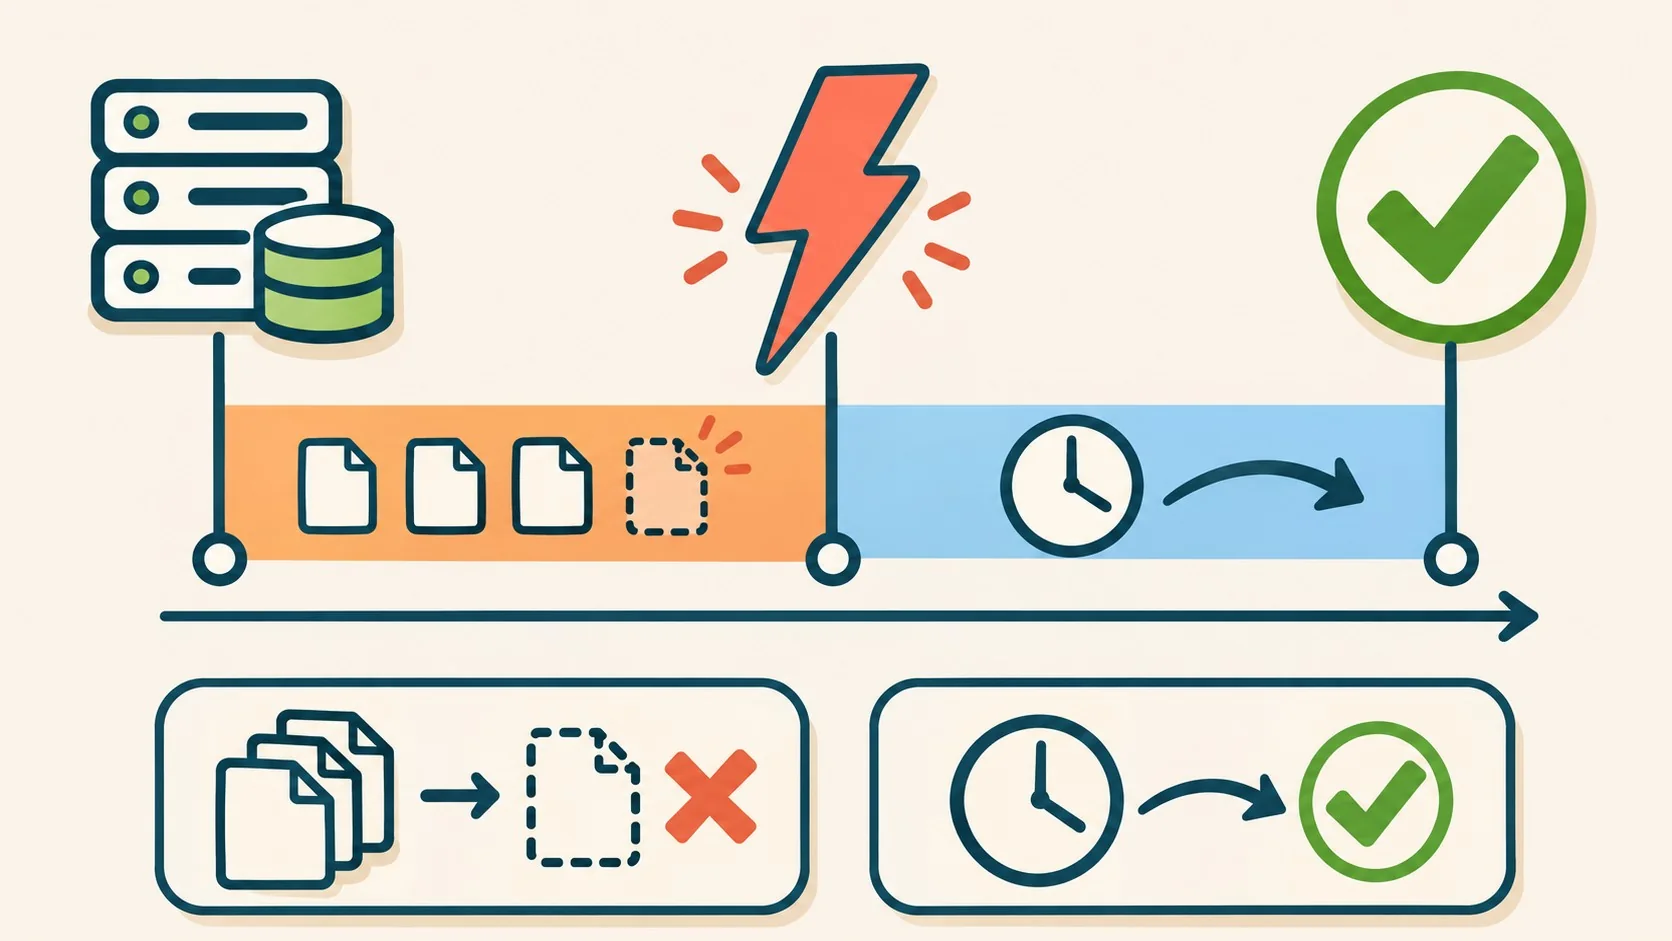
- Un backup nocturno implica un RPO de 24 horas: una falla a las 5pm pierde todo lo del día.
- Restaurar el backup al menos una vez por trimestre es la única forma real de saber si funciona.
- Un backup en la misma cuenta que producción solo te protege de falla de hardware, nada más.
- Un equipo chico no necesita hot standby: necesita cuenta separada, restore probado e infraestructura como código.
¿Qué diferencia hay entre tener un backup y tener un plan de recuperación ante desastres?
Un backup es un archivo que existe. Un plan de recuperación ante desastres es el procedimiento completo que te dice cómo usarlo cuando todo lo demás falló: quién decide que arrancó la recuperación, dónde está la copia, cómo se restaura paso a paso y cómo verificás que funcionó.
Según la nota de Mecanik, “un backup que existe, está actualizado y nunca se restauró es una hipótesis, y el momento en que lo probás es un mal momento para descubrir que estaba equivocada”. La brecha entre tener backups y poder recuperarse es justamente donde la mayoría de las caídas se convierten en incidentes serios.
Ponele que tu base de datos se corrompe un viernes a la noche. Tenés el dump de la madrugada, perfecto, ¿pero alguien probó alguna vez restaurar ese dump completo, con todas las tablas, en un servidor limpio? Si nadie lo hizo, lo que tenés ahí no pasa de ser una suposición optimista con nombre elegante.
¿Qué son el RPO y el RTO y quién los tiene que definir?
El RPO (recovery point objective) es cuánta data podés perder, y el RTO (recovery time objective) es cuánto tiempo podés estar caído. Ninguno de los dos lo decide el equipo de ingeniería: son números que tiene que poner el negocio, porque cada punto que se ajusta cuesta plata.
Backups nocturnos significan un RPO de 24 horas: si falla algo a las 5 de la tarde, perdés todo lo que pasó desde la noche anterior. Si eso es inaceptable para tu negocio, el esquema de backup está mal, y no hay cuidado técnico que lo compense. Cubrimos ese tema en detalle en la nota sobre cómo elegir un proveedor de cloud hosting confiable.
El RTO es más traicionero porque incluye seis pasos, no uno: notar que algo pasó, decidir que es un desastre, aprovisionar infraestructura nueva, restaurar, verificar que todo anda bien y recién ahí volver a mandar tráfico de producción. Los equipos suelen estimar solo el paso de restaurar y se olvidan de los otros cinco. Por eso las recuperaciones reales tardan varias veces más de lo que alguien proyectó en una reunión.
Un RPO de cinco minutos necesita replicación continua. Un RTO de una hora necesita infraestructura que se reconstruya sola, porque nadie va a configurar un servidor a mano bajo presión en 60 minutos. La conversación productiva es decirle al negocio cuánto cuesta cada nivel y que elija, en vez de inventar un número en ingeniería y esperar que coincida con una expectativa que nadie puso por escrito.
Ejemplo hipotético (a modo ilustrativo): pensemos en una tienda online chica que vende la mayor parte de su mercadería entre el viernes y el domingo. Si pierde 24 horas de datos —el RPO típico de un backup nocturno—, pierde pedidos de un día entero, pero puede reconstruir buena parte a mano revisando emails de confirmación y mensajes de WhatsApp con clientes. Molesto, pero no catastrófico: un RPO de 24 horas probablemente le alcanza. Ahora pensemos en esa misma tienda si en lugar de pedidos puntuales cobrara suscripciones recurrentes: perder un día de datos ahí puede significar facturarle dos veces a un cliente o no facturarle nada a cientos de ellos. En ese escenario, el RPO aceptable deja de ser de horas y pasa a ser de minutos, y recién ahí se justifica pagar por replicación continua. La pregunta que ordena la decisión no es técnica: es “¿qué pasa realmente si perdemos las últimas X horas de datos?”, y la tiene que responder con un número alguien del negocio, no una sensación de “no debería pasar nada grave”.
Tres preguntas para no inventar el número de RPO/RTO en una reunión
- ¿Cuánto cuesta, en plata o en confianza del cliente, perder la última hora o el último día de datos? Si la respuesta es “no mucho”, un RPO de 24 horas probablemente alcanza.
- ¿Hay dinero comprometido en esa ventana —pagos, cobros, stock reservado—? Si sí, cada hora adicional de RPO tiene un costo concreto que conviene calcular antes de fijar el número, no después de una pérdida.
- ¿Quién puede estar offline sin que se note en una hora? ¿Y en un día? Esa respuesta define el RTO real que necesitás, no el que suena prolijo en un documento que nadie volvió a leer.
¿Por qué un backup que nunca se probó no es un backup?
Porque las fallas reales son invisibles hasta que intentás restaurar. Según el mismo análisis, las causas más comunes son: un job que viene fallando en silencio hace semanas porque nadie monitorea los éxitos, solo los errores; un dump que capturó el esquema pero no los datos; tablas que alguien dejó en una lista de exclusión y se olvidó; o la clave de cifrado guardada en la misma máquina que murió.
Hay un caso particular que complica más de lo que debería: el backup que vive en la misma cuenta o región que lo que protege. Eso te cubre contra una falla de hardware y nada más. No sobrevive a un compromiso de cuenta, a un borrado accidental a nivel cuenta, ni a un ransomware que llega a todo lo que las mismas credenciales alcanzan.
¿Y cómo sabés que tu backup realmente funciona? Restaurándolo. Programalo, hacelo como mínimo una vez por trimestre, y cronometralo. Ese tiempo, el que tardó de verdad, es tu RTO real, no el que figura en el documento que nadie lee. Ya lo cubrimos antes en la nota sobre cómo resolver problemas comunes de hosting y dominio.
¿Por qué un backup en la misma cuenta no alcanza?
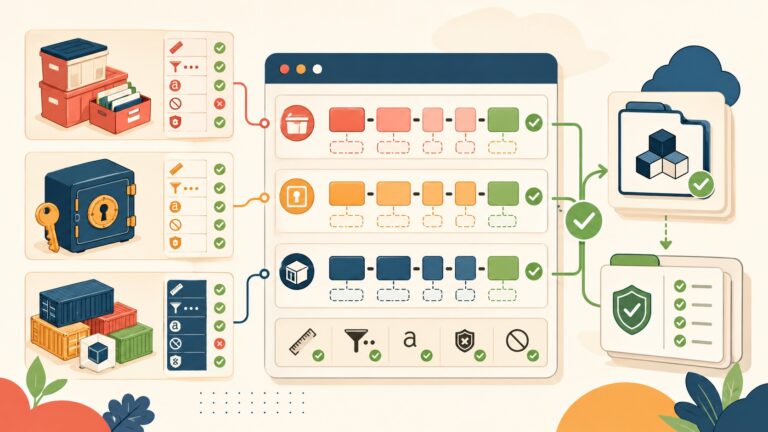
Porque protege contra un solo escenario y deja afuera los otros tres que más duelen. Guardar la copia en una cuenta separada, con credenciales que producción no puede usar, es la diferencia entre sobrevivir a un ransomware y perderlo todo junto con el backup.
Si el ransomware entra con las credenciales de producción y esas mismas credenciales llegan al backup, da lo mismo que ese backup exista: ya no te sirve de nada. Lo mismo pasa con un borrado accidental a nivel de cuenta completa: si todo vive en el mismo lugar, se va todo junto. La recomendación es simple: cuenta separada, credenciales separadas, y que nadie en producción tenga permiso de tocar esa copia.
¿Qué componentes se olvidan al armar el inventario de disaster recovery?
La base de datos es lo obvio y casi nunca lo que frena la recuperación. Lo que extiende los tiempos son los componentes que nadie anotó en ninguna lista.
- Archivos subidos por usuarios: viven separados de la base y muchas veces no tienen backup propio.
- Configuración y secretos: existen solo en la máquina que está corriendo, en ningún otro lado.
- DNS y certificados: si la cuenta que los tiene es justamente la que perdiste, no se recrean rápido.
- Infraestructura clickeada a mano: reconstruirla es lento si no está definida como código, rápido si lo está.
- El conocimiento de cómo encaja todo: si solo una persona lo sabe, tu RTO depende de si esa persona atiende el teléfono.
Escribí el inventario antes de escribir el plan. La mayoría de los equipos descubre, haciendo esa lista, al menos un componente sin backup de ningún tipo. Encontrarlo así sale infinitamente más barato que encontrarlo en medio de un incidente real.
¿Cómo armar un plan de recuperación que se pueda seguir a las 3 de la mañana?
Un plan de recuperación útil entra en una página y lo puede seguir alguien cansado, a las 3am, sin pensar demasiado. Los documentos largos no se leen en medio de un incidente, así de simple. Lo explicamos a fondo en entender las opciones actuales de cloud hosting.
Tiene que incluir, sin vueltas: quién decide que arrancó la recuperación (dudar sobre si esto cuenta como desastre ya es una demora en sí misma), dónde están los backups y cómo acceder con credenciales que no dependan del sistema caído, los pasos de restauración en orden y específicos, cómo verificar que funcionó (un chequeo concreto, no “el sitio parece cargar”) y a quién avisar, adentro y afuera de la empresa.
Guardalo en un lugar que sobreviva a la falla. Un plan de recuperación guardado únicamente en el sistema que se supone que recupera es un error recurrente y totalmente evitable (y sí, pasa más de lo que pensás). Lo mismo aplica al acceso: si una sola persona tiene las credenciales de la cuenta de hosting, tu tiempo de recuperación depende de si esa persona contesta el celular.
¿Un equipo de software chico necesita un hot standby en otra región?
En la mayoría de los casos, no. Un hot standby en otra región cuesta plata real y agrega complejidad que trae sus propios modos de falla. Lo que necesita un equipo chico es considerablemente más barato y cubre casi todo lo que realmente pasa.
| Componente | Qué cubre | Costo relativo |
|---|---|---|
| Backup en cuenta separada | Compromiso de cuenta, ransomware, borrado accidental | Bajo |
| Restore probado y cronometrado | RTO real verificado, no estimado | Bajo (tiempo trimestral) |
| Infraestructura como código | Reconstrucción rápida sin “arqueología” | Medio |
| Plan de una página leído | Decisiones rápidas bajo presión | Bajo |
| Hot standby en otra región | RTO casi cero, continuidad total | Alto |
El combo de los primeros cuatro ítems cubre falla de hardware, borrado accidental, compromiso de cuenta y ransomware, que es la mayor parte de lo que pasa en la práctica. Todo lo que está por encima de eso es una decisión sobre cuánto vale reducir el downtime un poco más, y esa pregunta es para el negocio, no para ingeniería.
Si tu infraestructura corre en algún proveedor de hosting o cloud, vale la pena revisar cómo maneja ese proveedor la separación de cuentas y el acceso con donweb.com como referencia de lo que debería ofrecer un hosting serio en este terreno.
Errores comunes al armar disaster recovery en equipos chicos
- Confundir “backup activado” con “backup que funciona”: nadie restauró nunca para comprobarlo, y el job puede estar fallando en silencio hace meses.
- Guardar la copia en la misma cuenta que producción: protege contra falla de hardware y nada más, cero contra ransomware o compromiso de cuenta.
- Dejar el plan de recuperación adentro del sistema que protege: si el sistema cae, el plan cae con él.
- Depender de una sola persona para el conocimiento operativo: el RTO termina atado a si esa persona atiende el teléfono esa noche, y eso no entra en ningún documento de recuperación.
- Contar solo el tiempo de restaurar como RTO: se olvidan de notar, decidir, aprovisionar, verificar y volver el tráfico, que suman más que el restore en sí.
Preguntas Frecuentes
¿Qué es RPO y RTO en recuperación ante desastres?
RPO es cuánta data podés perder, y un backup nocturno implica un RPO de 24 horas. RTO es cuánto tiempo podés estar caído, contando desde que notás el problema hasta que el tráfico vuelve a funcionar normal. Los dos son decisiones de negocio y cuestan más cuanto más se ajustan. Te puede servir nuestra cobertura de tener un plan B cuando falla el deploy.
¿Cómo sé si mi backup realmente funciona?
Restaurándolo de verdad, no revisando si el job corrió. Programá una restauración completa al menos una vez por trimestre y cronometrala: ese tiempo medido es tu RTO real, no el que escribiste en un documento hace un año.
¿Qué tiene que incluir un plan de disaster recovery?
Tiene que definir quién decide que arrancó la recuperación, dónde están los backups y cómo accederlos con credenciales independientes del sistema caído, los pasos de restauración en orden, una verificación concreta de que funcionó y a quién avisar. Todo eso entra en una página.
¿Dónde conviene guardar los backups para que sobrevivan a un desastre?
En una cuenta o región separada de producción, con credenciales que producción no pueda usar. Un backup guardado en el mismo entorno que protege solo te cubre contra falla de hardware, no contra compromiso de cuenta ni ransomware.
¿Un equipo chico necesita un servidor de respaldo (hot standby)?
Generalmente no. El costo y la complejidad agregan modos de falla propios que un equipo chico no necesita gestionar. Backups en cuenta separada, restore probado, infraestructura como código y un plan de una página cubren la mayoría de los desastres reales.
Conclusión
La diferencia entre un backup y un plan de recuperación ante desastres es la diferencia entre tener una hipótesis y tener una certeza probada. Lo que hay que hacer esta semana, no el mes que viene, es tres cosas concretas: escribir el inventario completo de lo que hay que recuperar, mover el backup a una cuenta separada con credenciales propias, y programar una restauración de prueba cronometrada.
Ese ejercicio solo, sin gastar un peso extra en infraestructura nueva, va a sacar a la luz al menos un componente sin backup. Encontrarlo así, en un ejercicio planeado, sale gratis comparado con encontrarlo en medio de una caída real a las 3 de la mañana.