Guardá cada mail con Cloudflare Email Worker inbox D1
En pocas palabras: Un Cloudflare Email Worker inbox son unas 30 líneas de TypeScript que usan el handler email(), parsean el MIME con postal-mime y escriben cada mensaje en una tabla D1 antes de reenviarlo a un destino verificado, según una guía publicada el 28 de septiembre de 2026.
Cloudflare Email Routing reenvía cada mail y no guarda copia de nada. Según una guía publicada el 28 de septiembre de 2026, armar un Cloudflare Email Worker inbox que escriba en D1 lleva unas 30 líneas de TypeScript: parseás el MIME con postal-mime, insertás en una tabla SQL y reenviás el mensaje original sin perder nada en el camino.
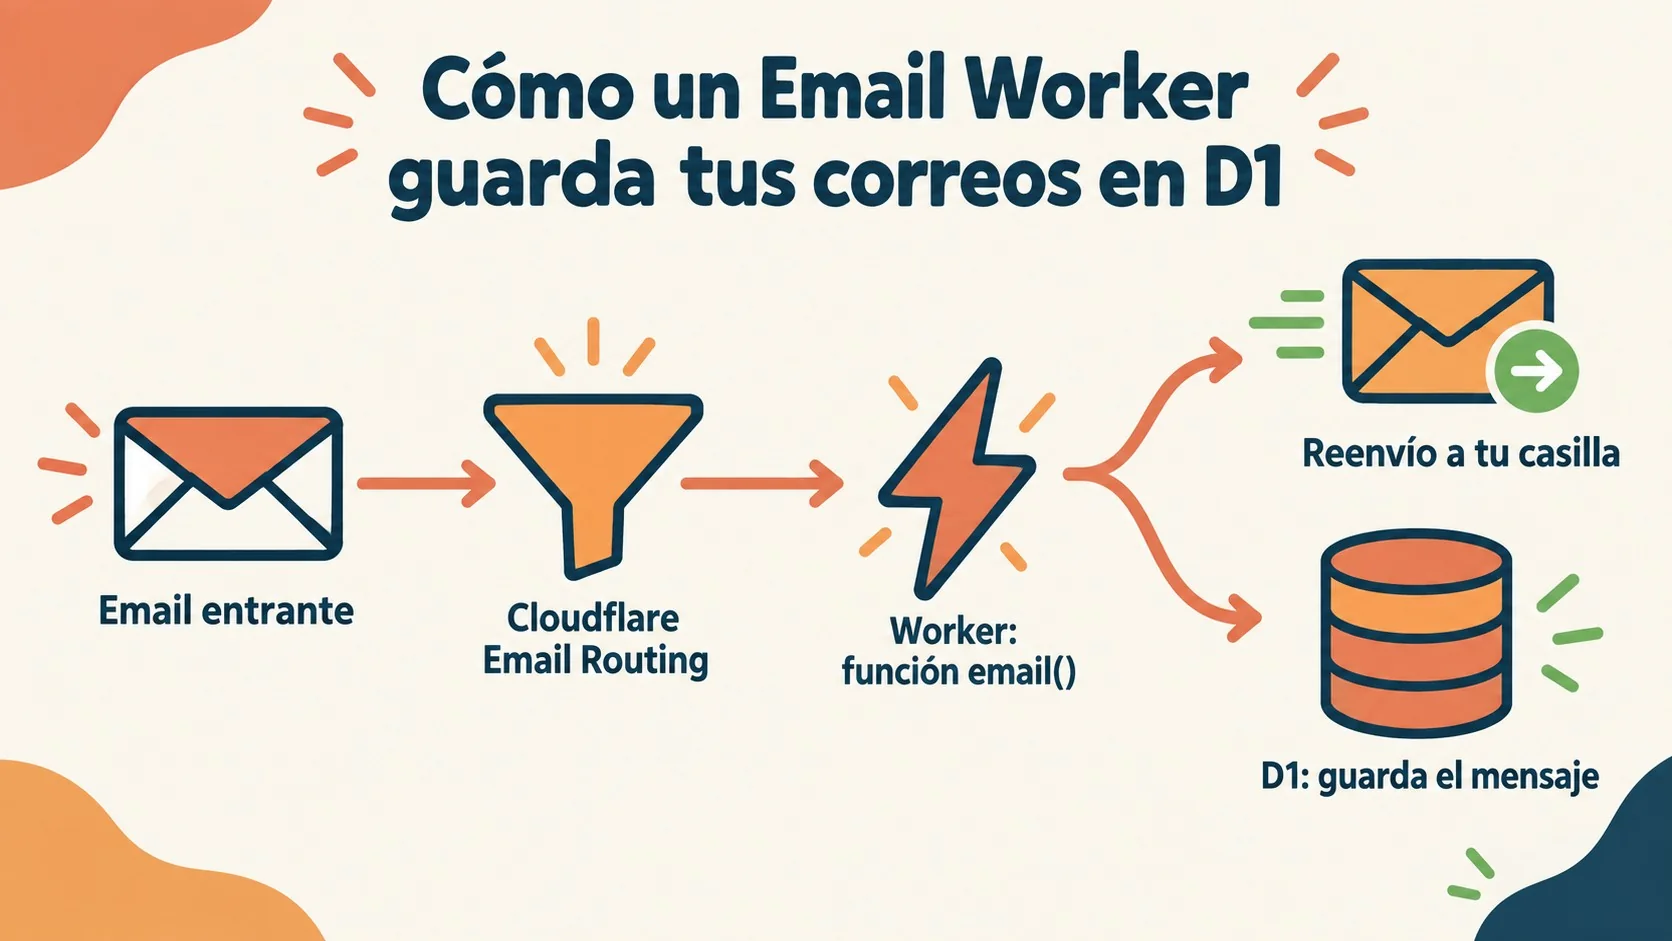
Un Cloudflare Email Worker inbox D1 es un Worker que se engancha a una regla de Email Routing, recibe el mensaje crudo en el evento email(), lo parsea y lo guarda en una base D1 antes de reenviarlo a un destino verificado. No reemplaza un cliente de correo: guarda una copia buscable por SQL del mail que ya se está reenviando de todos modos.
En este artículo:
- En 30 segundos
- ¿Por qué Cloudflare Email Routing no guarda copia de los mensajes?
- ¿Cómo funciona el handler email() que guarda mensajes en D1?
- ¿Cómo se configura el wrangler.json y la regla de enrutamiento?
- ¿Qué esquema de D1 usar y cuáles son los límites del plan gratuito?
- ¿Qué te da este Worker y qué le falta frente a un inbox completo?
- ¿Cuándo te alcanza con el handler solo y cuándo conviene self-hostear uno de los tres proyectos?
- Errores comunes al armar un inbox con Cloudflare Email Workers y D1
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El handler
email()de Cloudflare Workers parsea el MIME con postal-mime y escribe cada mensaje en D1 antes de reenviarlo. - El plan gratuito de D1 permite 5 millones de filas leídas y 100.000 escritas por día, según la guía de Cloudflare Email Worker inbox.
- Un soporte con 100 mensajes diarios consume apenas el 0.1% del presupuesto de escritura del plan Free.
- La regla de Email Routing que apunta a un Worker se crea desde el dashboard o la REST API: no hay comando de wrangler para eso.
- Tres proyectos self-hosted (agentic-inbox, hqbase y ResolveHQ) ya corren esta arquitectura Worker + D1 en producción.
¿Por qué Cloudflare Email Routing no guarda copia de los mensajes?
Email Routing opera en la capa MX: acepta la sesión SMTP, aplica tus reglas y entrega los bytes a un destino, sin guardar nada en el medio. Guardar mail implica retención, búsqueda, cuotas y manejo de abuso, y ese no es el negocio de Cloudflare en este producto: la empresa arma el borde de la red, no storage de correo.
Fijate que la única puerta que dejaron abierta es que un destino de la regla puede ser un Worker, no solo una casilla verificada. Ahí entran los proyectos self-hosted que menciono más abajo. Todos aprovechan esa puerta para meter D1, y R2 para adjuntos, en el medio del flujo, sin tocar la capa MX.
¿Cómo funciona el handler email() que guarda mensajes en D1?
El handler email() recibe el mensaje ya aceptado por Email Routing y te da acceso a message.raw, un ReadableStream con el MIME completo de hasta 25 MiB, más message.from, message.to y los headers originales. Con eso alcanza para armar el insert a D1 y reenviar el mail sin perderlo. Ya lo cubrimos antes en cómo manejar secretos en tus Workers.
Ejemplo hipotético: pensemos en un mail que llega a support@ un domingo a la noche. El Worker lo intercepta, parsea el asunto y el cuerpo con postal-mime, guarda una fila en D1 con un UUID, y lo reenvía a la casilla personal dentro de ctx.waitUntil() para no bloquear la respuesta SMTP. Ese flujo completo, según el ejemplo publicado, entra en unas 30 líneas de TypeScript.
await env.DB.prepare(
 "INSERT INTO messages (id, from_addr, to_addr, subject, text_body, received_at) VALUES (?,?,?,?,?,?)"
).bind(crypto.randomUUID(), message.from, message.to, parsed.subject ?? "", parsed.text ?? "", new Date().toISOString()).run();
ctx.waitUntil(message.forward("[email protected]"));
Tres detalles rompen el handler si no los tenés presentes. message.raw es un stream, no un string: lo envolvés en un Response para leerlo, porque una segunda lectura viene vacía. forward() solo acepta destinos ya verificados en el dashboard, y si mandás a uno que no está verificado, el remitente recibe un bounce. Y existe setReject(reason): si tu lógica detecta spam, cortás la sesión SMTP con un 5xx y ese mail no se guarda ni se reenvía.
¿Cómo se configura el wrangler.json y la regla de enrutamiento?
El binding a D1 se declara en wrangler.json con el nombre de la base y el database_id, igual que cualquier otro Worker con D1. La regla que conecta el correo con ese Worker se crea aparte, desde el dashboard, no con un comando de wrangler. Relacionado: otro proyecto de email serverless con D1.
El camino es: Compute, Email Service, Email Routing, tu dominio, Routing rules, Create routing rule, tu dirección, acción “Send to a Worker”, elegís el Worker. También existe la REST API de Email Routing para automatizar ese paso. Ojo con esto: si renombrás el Worker después de crear la regla, el binding se rompe y hay que reapuntarla a mano.
¿Qué esquema de D1 usar y cuáles son los límites del plan gratuito?
El esquema mínimo que propone la guía tiene una tabla messages con id, remitente, destinatario, asunto, cuerpo de texto y fecha, más un índice en received_at DESC. Sin ese índice, la consulta que trae los últimos 50 mensajes termina escaneando toda la tabla, algo que la nota de Cloudflare bills spike marca como el motivo más común de facturas infladas en D1.
¿Y si tu bandeja recibe 100 correos por día? Exacto: eso es apenas el 0.1% del presupuesto de escritura diario del plan Free.
| Recurso D1 | Plan Free | Workers Paid |
|---|---|---|
| Tamaño máximo de base | 500 MB | 10 GB |
| Storage total por cuenta | 5 GB | 1 TB |
| Time Travel (recuperación) | 7 días | 30 días |
Según los límites oficiales de D1, el tamaño máximo de fila es de 2 MB, así que los adjuntos van a R2, no a D1. Para un buzón de solo texto, arrancar con D1 alcanza y sobra.
¿Qué te da este Worker y qué le falta frente a un inbox completo?
Con este handler terminás con un Worker que guarda cada mensaje, lo hace buscable por SQL y sigue reenviándolo a tu casilla. Lo que no tenés es una interfaz, threading de conversaciones, asignación de quién atiende cada caso, ni una forma de que alguien responda desde support@ una hora después.
Eso es justo lo que agregan tres proyectos que ya corren esta misma arquitectura Worker más D1: cloudflare/agentic-inbox (Apache-2.0, pensado como inbox que “agentes de IA” pueden leer y accionar, aunque habría que ver qué tan madura está esa parte), HQBase/hqbase (AGPL-3.0, con Workers, D1, R2 y Queues, más el binding send_email para responder) y mirza-rizvi/ResolveHQ (código disponible pero no abierto, con Resend para el envío saliente). Ninguno reemplaza mágicamente el trabajo de mantenimiento: self-hostear cualquiera de los tres significa que vos te hacés cargo de las migraciones de D1, del bucket de R2, del camino de respuesta y del handler cuando algo se rompe a las tres de la mañana. En problemas típicos con Workers wildcard profundizamos sobre esto.
¿Cuándo te alcanza con el handler solo y cuándo conviene self-hostear uno de los tres proyectos?
Con los datos de arriba (qué agrega cada proyecto, qué licencia tiene, y cuánto presupuesto de D1 consume un volumen típico de correo) se puede armar un criterio simple para decidir sin tener que probar los tres:
- Una sola persona revisa el correo y solo necesitás un archivo buscable. El handler de 30 líneas alcanza: no sumás una licencia de terceros ni una superficie nueva para mantener. Es la opción de menor compromiso operativo.
- Más de una persona necesita ver o responder desde la misma casilla. Ahí el handler solo no cierra, porque no resuelve “quién está atendiendo esto”. Conviene mirar alguno de los tres proyectos, empezando por la licencia: Apache-2.0 (agentic-inbox) y AGPL-3.0 (hqbase) son código abierto sin restricciones de uso comercial; ResolveHQ es source-available, así que conviene leer los términos antes de asumir que se puede modificar y redistribuir libremente.
- Necesitás que el sistema responda automáticamente, no solo archive. hqbase suma el binding
send_emailde Cloudflare para enviar; ResolveHQ resuelve el envío saliente con Resend y requiere configurar sus registros DNS aparte. agentic-inbox está pensado para que un agente de IA lea y actúe sobre los mensajes, no tanto para respuesta humana asistida. - El volumen de correo es alto (varios miles de mensajes por día). Antes de decidir, conviene revisar los límites de D1 según el plan: el Free tiene 100.000 escrituras diarias y 5 GB de storage total por cuenta, mientras que Workers Paid sube a 1 TB. Un volumen alto agota antes el storage que las escrituras, así que ahí el criterio pasa por el plan de D1, no por qué proyecto elegís.
En cualquiera de los tres casos self-hosted, el costo no es el deploy inicial (que la guía original describe como un wrangler deploy y listo), sino sostener las migraciones de esquema, el bucket de R2 y el camino de respuesta con el tiempo.
Si lo que necesitás es simplemente tener un sitio o un dominio alojado en Argentina sin meterte con bindings de Cloudflare, en donweb.com tenés esa parte resuelta con soporte local, y podés dejar el Worker de email solo para lo que realmente justifica el mantenimiento.
Errores comunes al armar un inbox con Cloudflare Email Workers y D1
- Leer message.raw dos veces. Es un stream: la segunda lectura viene vacía, así que envolvelo en un
Responseuna sola vez y guardá el resultado en una variable. - Reenviar a una dirección no verificada.
forward()solo acepta los mismos destinos verificados que aparecen en el dashboard; si te equivocás, el remitente recibe un bounce y vos no te enterás. - Olvidarte del índice en received_at. Sin él, cualquier consulta de “últimos N mensajes” escanea toda la tabla y te come el presupuesto de lecturas de D1 sin necesidad.
- Renombrar el Worker sin reapuntar la regla. El binding de Email Routing queda roto y los correos dejan de llegar, sin ningún error visible en el momento.
- Guardar adjuntos directamente en D1. El límite por fila es de 2 MB según la documentación oficial; para PDFs o imágenes, mandalos a R2 y guardá solo la referencia en D1.
Preguntas Frecuentes
¿Cómo guardo los emails que llegan por Cloudflare Email Routing?
Apuntás la regla de Email Routing a un Worker en vez de a una casilla, y dentro del handler email() parseás el MIME con postal-mime e insertás los campos que necesites en una base D1 antes de llamar a message.forward().
¿Qué es el handler email() en un Cloudflare Worker?
Es un método que exportás junto a fetch() (o en vez de él) y que Cloudflare invoca cada vez que llega un mail a través de una regla de Email Routing. Recibe el mensaje crudo, el entorno del Worker con sus bindings y el contexto de ejecución.
¿Cómo conecto Cloudflare Email Routing con D1?
Declarás el binding d1_databases en tu wrangler.json con el nombre y el ID de la base, y desde el dashboard creás la regla de routing apuntando a ese Worker. No existe un comando de wrangler para crear la regla en sí. Tema relacionado: por qué un Worker no se ejecuta.
¿Cloudflare Email Routing guarda copia de los mensajes?
No. Email Routing acepta la sesión SMTP y reenvía los bytes al destino configurado, sin retención propia. La única forma de conservar una copia es interponer un Worker que escriba el mensaje en algún storage, como D1, antes de reenviarlo.
¿Cuánto cuesta guardar emails en D1 con Cloudflare?
Con el plan Free de D1, tenés 5 millones de filas leídas y 100.000 escritas por día sin costo adicional, y hasta 5 GB de storage total por cuenta. Un buzón de soporte con 100 mensajes diarios usa una fracción mínima de ese presupuesto.
Conclusión
Lo que cambia acá no es que Cloudflare haya sumado una función nueva: el handler email() y los bindings de D1 ya existían. Lo que aporta esta guía es la receta concreta, con el schema, el binding y las advertencias de las tres cosas que rompen el handler en el primer deploy. Si necesitás un registro buscable de lo que llega a una casilla de soporte, sin construir una interfaz completa, esas 30 líneas alcanzan. Si necesitás threading, asignación de casos y respuesta desde el mismo lugar, el criterio de licencia y de qué agrega cada proyecto (send_email vs Resend, IA vs equipo humano) debería pesar más que solo “cuál está más de moda”, sabiendo que la mantenibilidad después queda de tu lado.
Fuentes
- Cloudflare Email Worker inbox: store every message in D1 in 30 lines – guía original con el handler, el schema y los tres proyectos self-hosted
- Workers API de Email Routing – documentación oficial del handler email(), forward(), reply() y setReject()
- Límites de D1 – documentación oficial de Cloudflare sobre cuotas del plan Free y Paid