Boarding-gate: la cola de prioridad para GitHub Actions
En pocas palabras: boarding-gate es una GitHub Action de udondan, licencia Apache-2.0, que ordena los runs de CI en una cola de prioridad según labels del pull request: humanos primero, luego Renovate o Dependabot, y el PR de release último, evitando colisiones al desplegar sobre un recurso compartido.
udondan, mantenedor de varios repositorios en GitHub, publicó boarding-gate, una GitHub Action que ordena por prioridad los runs de CI cuando Renovate, Dependabot, un PR de release y el pipeline de main compiten por el mismo recurso compartido. La herramienta evita colisiones de despliegue y corta runs desperdiciados armando una cola de prioridad GitHub Actions basada en labels de pull request.
boarding-gate es una composite action de código abierto, licencia Apache-2.0, que se coloca como gate en un job previo a cualquier trabajo que toque un recurso compartido: un stack de test, un entorno de staging, un registro de paquetes. Ordena los runs en espera según el peso de las labels de cada pull request, para que los PRs humanos vayan antes que los de Renovate o Dependabot, y el PR de release quede último.
En este artículo:
- En 30 segundos
- ¿Por qué Renovate, Dependabot y el release PR terminan compitiendo por el mismo CI?
- ¿Qué es el bucle de rebuilds y por qué cuesta tanto tiempo de CI?
- ¿Por qué los concurrency groups y el merge queue de GitHub no alcanzan para resolver esto?
- ¿Qué regla propone udondan para armar una cola de prioridad en GitHub Actions?
- ¿Cómo funciona boarding-gate y cómo se configuran las prioridades con labels?
- ¿En qué otros casos del pipeline aplica la misma lógica de cola de prioridad?
- ¿Qué límites tiene boarding-gate y cuándo conviene usarlo junto al merge queue nativo?
- Errores comunes al coordinar Renovate, Dependabot y despliegues en GitHub Actions
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- boarding-gate es una GitHub Action creada por udondan, publicada en el repositorio oficial bajo licencia Apache-2.0.
- Fusionar n pull requests sin coordinación cuesta del orden de n²/2 runs de CI, según el artículo original de udondan que cita el issue tracker de Dependabot.
- Con un pipeline de 20 minutos y 6 PRs abiertos, un día de merges se convierte en un día de espera.
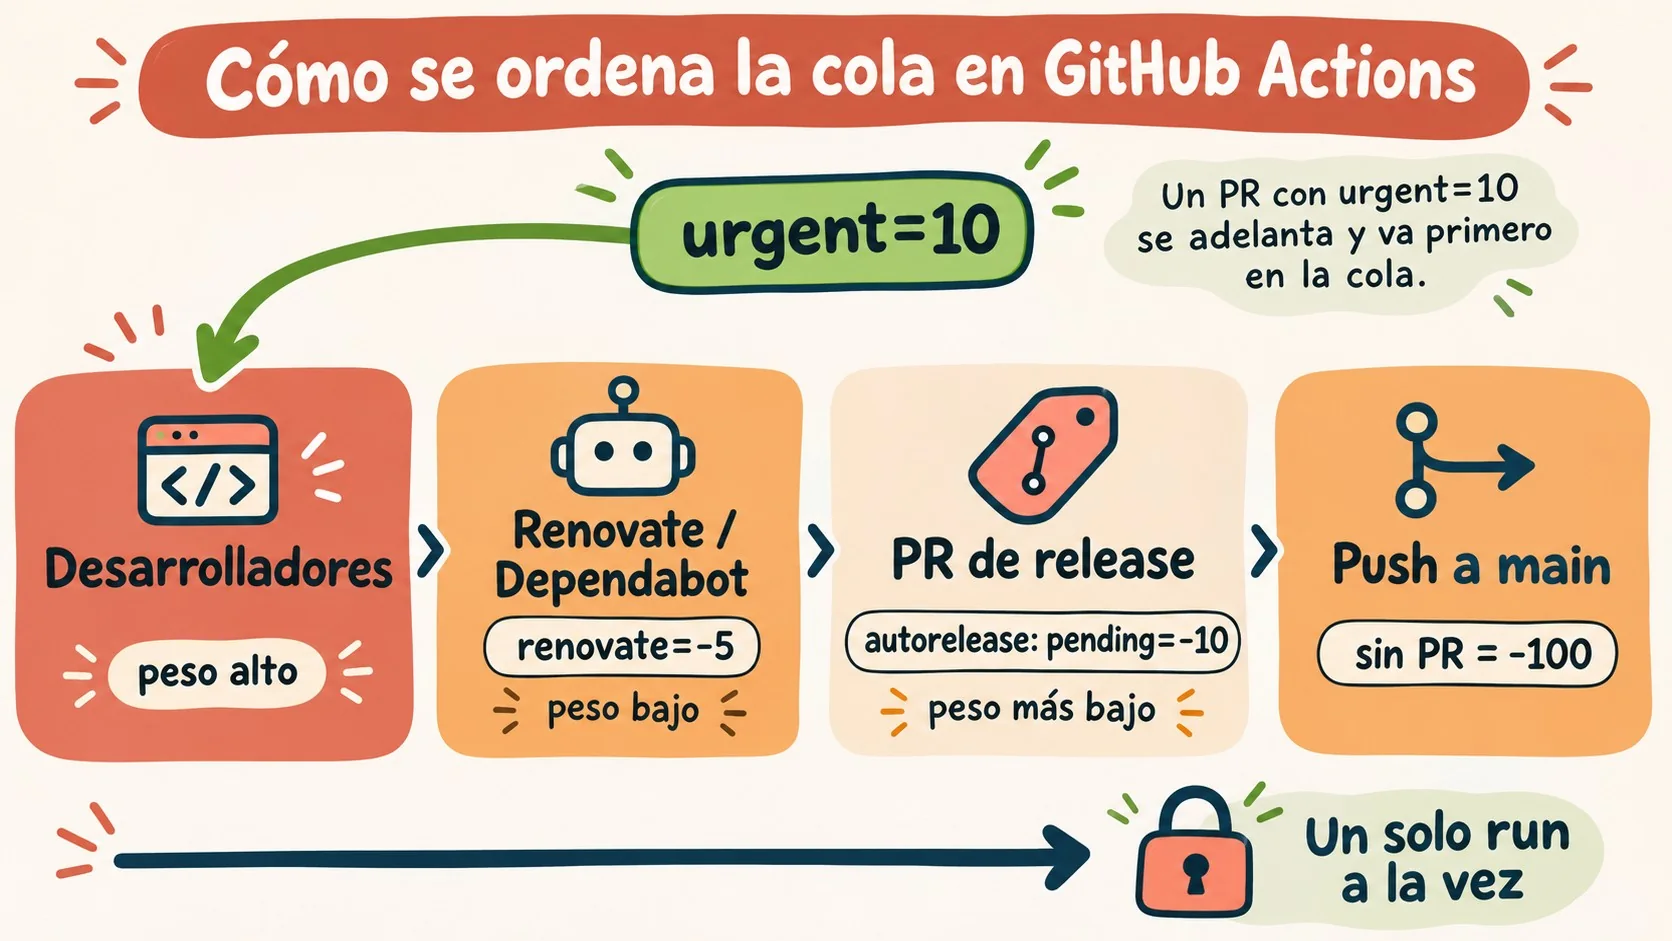
- Las prioridades se configuran con label-weights: Renovate y Dependabot restan 5 puntos, el PR de release resta 10, y la label urgent suma 10.
- El merge queue nativo de GitHub solo existe para repositorios de organizaciones, no para cuentas personales.
¿Por qué Renovate, Dependabot y el release PR terminan compitiendo por el mismo CI?
Porque son cuatro actores que escriben a main sin hablar entre ellos: los desarrolladores, los bots de dependencias, la herramienta de release y el pipeline que corre después de cada merge. Cada uno dispara CI, cada uno se ve afectado por lo que hacen los demás, y GitHub Actions ejecuta todo en el orden en que llega, sin criterio.
Ponele que tenés varios PRs abiertos: algunos tuyos, otros de Renovate o Dependabot, y uno de release-please. Renovate, con rebaseWhen: auto, rebasea cada PR abierto en cuanto main se mueve. Dependabot hace lo mismo a menos que configures rebase-strategy: disabled. Cada rebase es un commit nuevo, y cada commit nuevo dispara otro run de CI completo.
El problema de fondo es que el PR de release (release-please, changesets, python-semantic-release) se actualiza más rápido que cualquier otro apenas main cambia, así que siempre gana el próximo turno de CI. Pero ese PR debería mergearse último, porque describe todo lo que se mergeó antes. El orden lógico queda invertido: lo que debería ir último es lo más rápido en reaccionar, y los bots en el medio son los que generan más runs.
¿Qué es el bucle de rebuilds y por qué cuesta tanto tiempo de CI?
El bucle de rebuilds es la secuencia que se repite cada vez que un PR se mergea: el pipeline de main arranca, el PR de release se reconstruye y hace force-push, los bots rebasean todos sus PRs abiertos, y tus otros PRs quedan atrasados y necesitás actualizarlos a mano. El primero de esos runs que termina se mergea, y todo vuelve a empezar. Ya lo cubrimos antes en nuestra nota donde comparamos las opciones de CI/CD disponibles en 2026, en esta comparativa.
Subís un PR, lo probás en local, funciona bárbaro, lo mergeás, el pipeline de main arranca, el release PR se reconstruye, tres bots rebasean sus ramas, tu siguiente PR queda detrás de todos ellos, lo actualizás, se dispara otro run, y para cuando terminás de mergear los seis PRs del día ya es de noche.
La cifra que cita el artículo de udondan, tomada del issue tracker de Dependabot, es que mergear n PRs cuesta del orden de n²/2 runs. Con un pipeline de 20 minutos y seis PRs abiertos, un día de trabajo de merges se vuelve un día entero de espera. udondan describe haber visto un PR de release pasar por CI cinco veces en un día sin mergearse nunca, mientras un fix urgente quedaba en cola detrás de un bump de linter.
¿Y quién paga ese costo? El equipo, con minutos de runner facturados y desarrolladores mirando un check amarillo que no avanza.
¿Por qué los concurrency groups y el merge queue de GitHub no alcanzan para resolver esto?
Porque ninguno de los dos entiende qué PR es cada run, solo entiende cuándo llegó. Los grupos de concurrency serializan ejecuciones, y desde mayo de 2026 la opción queue: max permite encolar hasta 100 runs pendientes en vez de cancelar todos menos uno. Pero la cola es ciega: corre feliz una rama que ya está atrasada respecto a main, y no tiene idea de que el run que acaba de dejar pasar está a punto de auto-mergearse e invalidar a todos los que esperan detrás.
El merge queue nativo de GitHub es la respuesta correcta al bucle de rebase: apila PRs, los testea en conjunto y los mergea solo. Tiene dos limitaciones concretas. Primero, existe únicamente para repositorios de organizaciones, así que nada en una cuenta personal lo tiene disponible. Segundo, ordena por orden de llegada, no por qué es cada PR, y tampoco controla el pipeline que corre sobre main ni evita que dos despliegues se superpongan.
Las lock actions como softprops/turnstyle, ahmadnassri/action-workflow-queue, ben-z/gh-action-mutex o github/lock resuelven “uno a la vez” y ahí se quedan, sin noción de prioridad. Los merge queues hosteados como Mergify o Graphite sí tienen prioridades, pero ordenan merges, no runs de workflow, y están pensados (y tarifados) para organizaciones. Ninguna de estas opciones te deja decir: humanos primero, bots después, release al final, main después de todos, uno a la vez, y nunca testear una rama que no se puede mergear. Relacionado: ver cómo se compara frente a Jenkins.
¿Qué regla propone udondan para armar una cola de prioridad en GitHub Actions?
La regla que propone udondan tiene seis puntos concretos, pensados para que un solo run use el recurso compartido por vez y el orden respete quién es cada PR, no cuándo llegó.
- Un run a la vez: nada más toca el stack mientras otro run lo está usando.
- Orden por tipo de PR, no por llegada: primero desarrolladores, después bots de dependencias, después el PR de release, después main.
- Un PR urgente puede saltar la fila: incluso mientras ya está esperando su turno.
- Nunca gastar un run en una rama atrasada: rebasearla o fallarla, pero no testearla.
- Esperar el merge antes de dejar pasar al siguiente: si el run que tiene el turno va a auto-mergearse, hay que esperar ese merge, porque si no el próximo arranca con una rama ya desactualizada.
- No dejar que el release PR gane solo por rebasear más rápido: si hay un PR de mayor prioridad por testear, hay que sostener la puerta.
Esa última regla, según cuenta el propio udondan, fue la que más iteraciones le llevó resolver. Y es la que ningún lock genérico puede expresar, porque requiere saber no solo quién tiene el turno sino quién lo necesita más.
¿Cómo funciona boarding-gate y cómo se configuran las prioridades con labels?
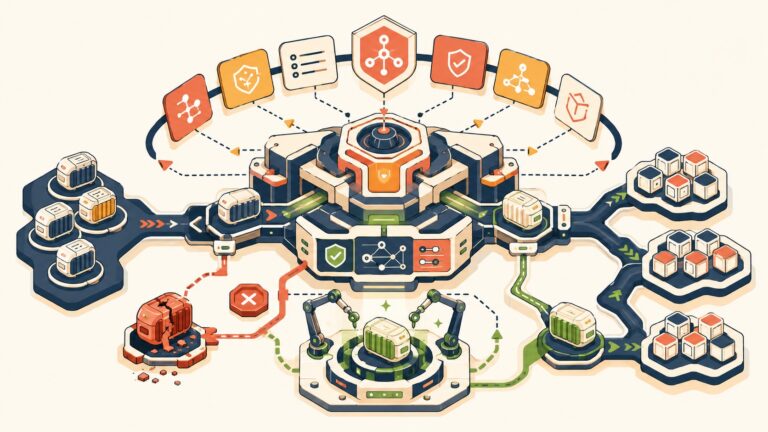
boarding-gate funciona con un job que va primero en el workflow, y todos los demás jobs dependen de él (needs). Cada run en espera suma el peso de las labels de su PR, y el que tiene más peso entra primero; si hay empate, gana el que llegó antes.
La configuración se hace con label-weights, un bloque de texto donde cada línea es label=peso. Los pesos recomendados en el README son urgent=10, renovate=-5, dependencies=-5 y autorelease: pending=-10. Los runs sin PR, como el push directo a main, usan no-pull-request-weight, típicamente en -100 para que main corra al final.
Un ejemplo de configuración, tomado del artículo original:
- require-up-to-date: falla el run en espera apenas su rama queda atrás de main, antes de gastar minutos de runner en una prueba inútil.
- update-pending-branches: es la regla de “sostener la puerta”: después de un merge, rebasea automáticamente los PRs de mayor peso que tengan auto-merge activado y estén atrasados, para que vayan primero.
- status-context: escribe un commit status con la posición en la cola, útil porque los logs de una composite action no se transmiten en vivo.
- update-token: tiene que ser un PAT o un token de GitHub App, porque los pushes hechos con
github.tokenno disparan nuevos workflow runs.
Por debajo, el lock es simplemente una referencia de git (refs/boarding-gate/<workflow>/<n>). Crear una ref que ya existe falla de forma atómica, así que no hay carrera posible ni servicio externo de por medio. Funciona también con forks y PRs de Dependabot, documentado en el README junto con el complemento workflow_run para esos casos. Tema relacionado: qué revisar antes de migrar tus workflows.
¿En qué otros casos del pipeline aplica la misma lógica de cola de prioridad?
La misma lógica aplica a cualquier escenario donde varios runs compiten por un recurso que no tolera superposición, no solo a Renovate y Dependabot. El artículo original lista varios casos concretos que cualquier equipo de infraestructura va a reconocer.
- Infraestructura como código: Terraform, OpenTofu, Pulumi o CloudFormation. El clásico error “Error acquiring the state lock” en CI es este mismo problema con otro mensaje; no arrancar el run hasta que la rama esté al día sale más barato que esperar el timeout del lock.
- Un único entorno de staging: el despliegue no puede superponerse, y el hotfix tiene que pasar antes que los bumps de dependencias. Para eso está la label
urgent=10. - Publicación de paquetes: npm, PyPI, crates.io, Maven Central o GitHub Pages. Sea que el release salga de un PR (release-please, changesets) o directo de main (semantic-release, goreleaser), el run de publicación y los runs de PR comparten el registro y la secuencia de versiones.
- Migraciones de base de datos: dos runs de migración contra la misma base son la misma colisión que dos despliegues contra el mismo stack.
- Runners escasos: dejar que los jobs de build también esperen su turno evita que un runner se use en una rama que ya quedó atrasada.
- Bots de agentes de código: dejar que agentes abran PRs en paralelo genera una tormenta de bots indistinguible de la de Renovate, y la misma lógica de prioridad aplica, con una label por agente si querés que vayan detrás de los humanos.
Si tu staging corre sobre infraestructura cloud administrada, en donweb.com o en cualquier proveedor serio, el problema de fondo es idéntico: no podés tener dos despliegues pisándose en el mismo entorno, sin importar quién lo hostee.
| Solución | Disponible en cuentas personales | Ordena por prioridad | Detecta ramas atrasadas | Controla el pipeline de main |
|---|---|---|---|---|
| Merge queue nativo de GitHub | No, solo organizaciones | No, por orden de llegada | Sí, de forma implícita | No |
| concurrency con queue: max | Sí | No | No | Parcial |
| Lock actions (turnstyle y similares) | Sí | No | No | Parcial |
| Merge queues hosteados (Mergify, Graphite) | Depende del plan | Sí, en el orden de merge | Sí | No |
| boarding-gate | Sí | Sí, con label-weights | Sí, con require-up-to-date | Sí |
¿Qué límites tiene boarding-gate y cuándo conviene usarlo junto al merge queue nativo?
boarding-gate no es un merge queue, y conviene tenerlo claro antes de instalarlo. Encola los runs de un único workflow, no decide qué PRs se mergean, y tampoco predice un merge que vos hagas a mano desde la interfaz de GitHub.
Si tu repositorio es de una organización y ya tenés el merge queue nativo activado, la recomendación del propio udondan es dejar que ese merge queue maneje las ramas al día y el auto-merge, y usar boarding-gate solo para las prioridades y el “uno a la vez” sobre el pipeline de main. En ese caso no hace falta activar require-up-to-date ni el manejo de ramas pendientes, porque el merge queue ya se encarga de eso. Lo que boarding-gate agrega arriba, con o sin merge queue, es el orden por tipo de PR, la label urgent y el control de que main no corra en paralelo con un deploy en curso.
¿Y si no usás ninguna organización, trabajás en una cuenta personal? Ahí boarding-gate es la única opción de las mencionadas que te da coordinación real, porque el merge queue nativo ni siquiera está disponible.
Errores comunes al coordinar Renovate, Dependabot y despliegues en GitHub Actions
- No configurar labels en Renovate ni Dependabot: sin la label
renovateodependenciespuesta en la configuración de cada bot, todos los runs quedan con peso 0 y la cola de prioridad no distingue nada. - Usar github.token para rebasear ramas atrasadas: los pushes hechos con el token por defecto no disparan nuevos workflow runs, así que
update-tokentiene que ser un PAT o un token de GitHub App con permisos de escritura. - Poner el grupo de concurrency en todo el workflow en vez de solo en el job de espera: si el group abarca también los jobs que ya están usando el recurso compartido, un deploy en curso puede cancelarse a mitad de camino.
- No fallar los jobs posteriores cuando la espera falla: un job que depende del gate y queda “skipped” cuenta como aprobado para los checks requeridos de GitHub, así que hay que forzar un
exit 1explícito cuando el resultado no essuccess.
Preguntas Frecuentes
¿Qué es boarding-gate?
boarding-gate es una composite action de código abierto, creada por udondan, que ordena los runs de un workflow de GitHub Actions para que solo uno use un recurso compartido a la vez. Se publica bajo licencia Apache-2.0 en github.com/udondan/boarding-gate.
¿Boarding-gate reemplaza al merge queue de GitHub?
No, boarding-gate no reemplaza al merge queue nativo: no decide qué PRs se mergean, solo ordena los runs del workflow que lo usa. Si el repositorio es de una organización y ya tiene merge queue activado, conviene combinar ambos: el merge queue maneja ramas al día y auto-merge, y boarding-gate agrega las prioridades por label. Esto se conecta con lo que analizamos en por qué conviene evitar credenciales estáticas.
¿Cómo le doy prioridad a un PR urgente sobre los bots de dependencias?
Se le pone la label urgent al pull request, que con el peso por defecto de urgent=10 suma más que los -5 de Renovate o Dependabot y pasa a la cabeza de la cola. La label se puede agregar incluso mientras el run ya está esperando su turno, porque boarding-gate vuelve a leer las labels en cada chequeo.
¿Qué diferencia hay entre require-up-to-date y el merge queue nativo de GitHub?
require-up-to-date es una opción de boarding-gate que falla un run en espera apenas detecta que su rama quedó atrás de main, antes de gastar minutos de runner en probarla. El merge queue nativo de GitHub resuelve algo parecido apilando PRs y testeándolos en conjunto, pero solo existe para repositorios de organizaciones y ordena por llegada, no por prioridad.
¿Boarding-gate funciona con pull requests de forks?
Sí, boarding-gate funciona con PRs de forks y con PRs de Dependabot, usando el complemento workflow_run documentado en el README del proyecto. Como los runs de forks no tienen acceso de escritura, operan en modo de solo lectura y esperan a que otro run tome el turno en su nombre.
Conclusión
El problema que resuelve boarding-gate no es nuevo, pero hasta ahora nadie lo había puesto en una sola herramienta: ordenar runs de CI por quién es cada PR, no por cuándo llegó. Si tu pipeline deploya algo real (un stack de AWS, un entorno de staging, un state de Terraform), el orden de ejecución deja de ser un detalle cosmético y pasa a ser la diferencia entre un deploy limpio y dos despliegues pisándose.
Lo que podés concluir con los datos del artículo original es que el costo de no coordinar escala mal, del orden de n²/2 runs según cita udondan del issue tracker de Dependabot, y que ni el merge queue nativo ni los concurrency groups cubren el caso completo. Lo que esos datos no permiten afirmar es cuánto tiempo de CI te vas a ahorrar en tu repositorio puntual, porque eso depende de cuántos bots tenés activos y de qué tan caro es tu pipeline.
Un criterio práctico para decidir si te sirve: contá cuántos runs de CI se dispararon la semana pasada que no terminaron en un merge. Si ese número es alto, probablemente tengas el mismo bucle que describe udondan, y vale la pena probar boarding-gate en un workflow de bajo riesgo antes de meterlo en el pipeline que toca producción.