Colas de trabajo node.js: la guía para emails diferidos
En pocas palabras: Los cron jobs de Vercel solo disparan un HTTP GET con límite de ejecución de 900 segundos, sin hospedar lógica pesada. Para envíos diferidos de email con reintentos reales hace falta sumar una cola como BullMQ (con el parámetro delay en milisegundos) o Amazon SQS entre el reloj y el worker.
Si programaste un cron job en Vercel para mandar un reporte diario y el job se corta a los 900 segundos sin terminar, no es un bug: es el límite documentado. Los cron jobs solo llaman una URL pública por HTTP, no hospedan la generación del reporte ni los reintentos. Para resolver el envío diferido con garantías reales necesitás colas de trabajo node.js como BullMQ, Amazon SQS o una cola REST entre el reloj y el trabajador.
Las colas de trabajo node.js son sistemas que guardan tareas pendientes (como el envío de un email) y las entregan a un worker cuando corresponde, con reintentos automáticos si el envío falla. A diferencia de un cron job, que solo dispara un evento en un horario fijo, una cola sostiene el intento de entrega mientras el proveedor de email está caído o tarda en responder.
En este artículo:
- En 30 segundos
- ¿Por qué un cron job no alcanza para enviar emails diferidos?
- ¿Qué colas de trabajo node.js existen para programar emails diferidos: BullMQ, SQS, Temporal o REST?
- ¿Cuáles son los límites técnicos de las colas de mensajes para emails?
- ¿Cómo evito que un email se envíe dos veces usando colas de trabajo?
- ¿Qué cambia cuando el sistema de emails diferidos crece en escala?
- Errores comunes al implementar colas de trabajo node.js para emails
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un cron job en Vercel tiene un límite de ejecución de 900 segundos y solo invoca una URL http pública, sin hospedar lógica pesada.
- BullMQ programa envíos con el parámetro
delayen milisegundos, pero el tiempo exacto depende de cuán ocupados estén los workers, según la documentación oficial de BullMQ. - La cola REST descrita en la guía de referencia permite un delay máximo de 604.800 segundos (7 días) y retención de hasta 30 días.
- El tamaño de mensaje tiene techo de 256KB, por eso se manda un
reportIdy no el reporte completo. - La entrega es at-least-once en todos los casos: sin un
eventIdidempotente, el mismo email puede salir dos veces.
¿Por qué un cron job no alcanza para enviar emails diferidos?
Un cron job decide cuándo, no cómo. Hace una sola cosa: dispara un trigger a un horario determinado. El trabajo de sostener un intento de entrega, reintentarlo si el proveedor de email devuelve un error temporal, o esperar a que se libere un worker, es tarea de una cola, no del reloj.
La distinción importa porque cambia la arquitectura antes de que elijas proveedor. Según la documentación de Vercel Cron Jobs, cada ejecución hace un request HTTP GET a tu deployment de producción, con un límite de ejecución que varía según el plan (el caso descrito en la guía de referencia usa 900 segundos) y solo puede llamar a una http_url. No genera el reporte, no reintenta si falla, no guarda estado entre corridas.
Ejemplo hipotético (ilustrativo, no un caso real): pensá en un SaaS que manda un reporte diario a cada usuario y además dispara un webhook saliente a un sistema externo cuando ese reporte se genera. Ahí hay dos trabajos distintos escondidos en una sola frase: algo decide que el reporte debe enviarse, y algo mantiene viva la entrega mientras el proveedor de email o el sistema externo está lento. El cron sirve para lo primero. La cola sirve para lo segundo. Esa distinción es la que define toda la arquitectura que sigue.
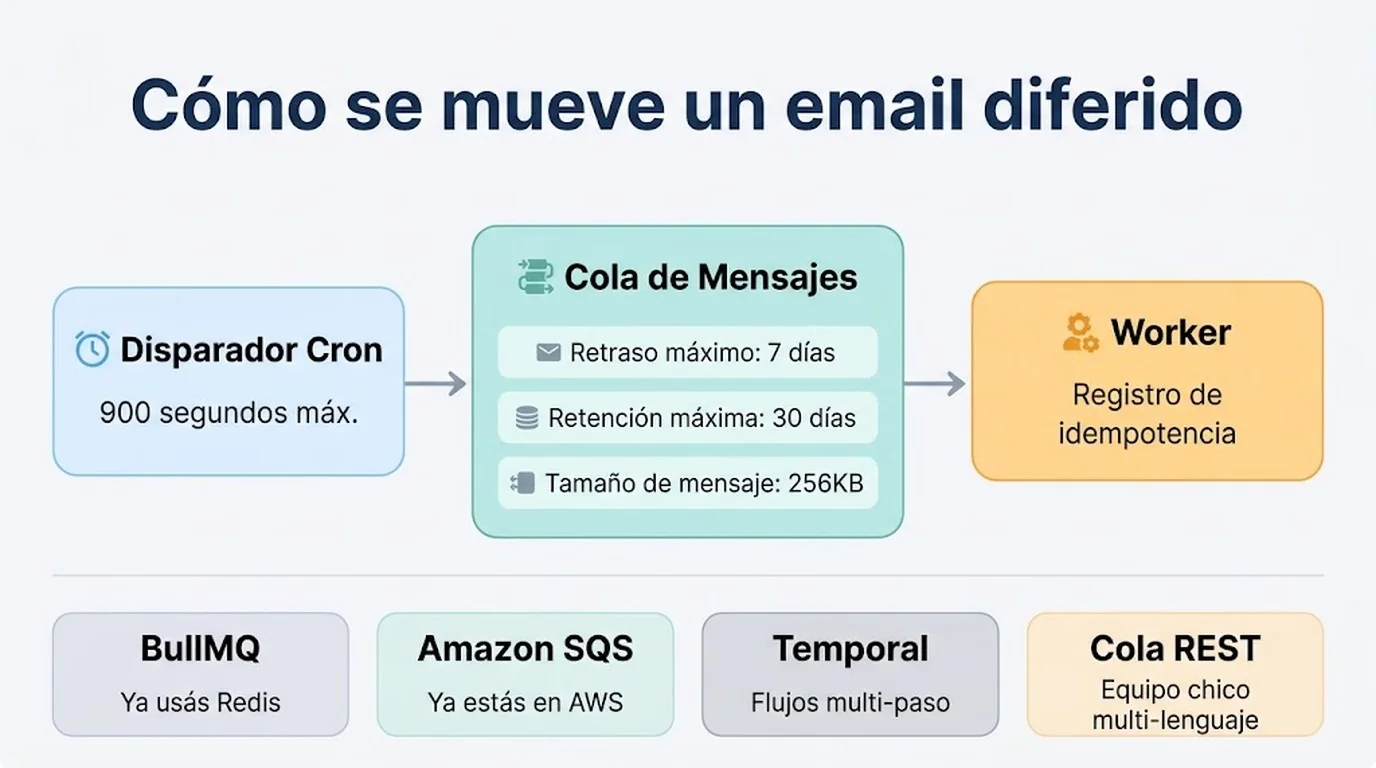
La arquitectura que surge de ahí es simple: cron trigger → queue → worker. El cron dispara, publica un mensaje en la cola, y un worker separado procesa la entrega con reintentos. Si el reporte tarda más de lo que el cron permite ejecutar, ya no es un problema del cron: es un problema de diseño que la cola resuelve de entrada. Te puede servir nuestra cobertura de manejar timeouts y fallos en Node.js.
¿Qué colas de trabajo node.js existen para programar emails diferidos: BullMQ, SQS, Temporal o REST?
Hay cuatro caminos razonables, y cada uno te deja un boundary distinto para operar. BullMQ es la opción natural si tu app Node.js ya corre Redis. Amazon SQS encaja si vivís dentro de AWS. Temporal se justifica cuando “mandar el reporte” se convierte en un proceso con aprobaciones, fan-out o pasos coordinados. Una cola REST genérica funciona cuando tenés workers en distintos lenguajes y querés un solo boundary HTTP.
Ninguna opción gana en todas las dimensiones. Elegís según qué deuda operativa ya estás pagando, no según cuál suena más moderna.
¿Cuándo conviene BullMQ para colas de trabajo node.js?
BullMQ conviene cuando tu servicio Node.js ya corre Redis en producción. Según la documentación de BullMQ, agregás un delay en milisegundos con { delay: 5000 } y el job se coloca en un “delayed set” hasta que pasa ese tiempo. Eso sí: la doc es honesta y aclara que el tiempo no está garantizado al milisegundo, depende de cuán ocupados estén los workers y cuántos otros jobs delayed vencen en ese mismo instante.
El punto que suele pasarse por alto: BullMQ también tiene changeDelay, que reprograma un job que ya está en la cola (pero solo si sigue en estado delayed, no si ya pasó a procesarse). El boundary que te queda a cargo acá es Redis: persistencia y operación.
¿Cuándo conviene Amazon SQS?
Amazon SQS conviene cuando tu stack ya vive adentro de AWS. Te saca la necesidad de operar Redis, pero suma permisos y configuración de IAM como boundary propio. Es la opción menos sorprendente dentro de un estado AWS, nada más.
¿Cuándo conviene Temporal en lugar de una cola?
Temporal conviene cuando el envío del email deja de ser una entrega simple y pasa a ser un flujo con estado: aprobaciones, fan-out a múltiples destinatarios con join posterior, o compensación si un paso falla. Ahí ya no estás resolviendo un problema de cola, estás resolviendo un problema de orquestación. Usar una cola para eso es forzar una herramienta para un trabajo que no le corresponde. Más contexto en ajustar el workflow de CI para Node.js.
¿Cuándo conviene una cola REST en vez de un SDK?
Una cola REST conviene cuando tenés un equipo chico con workers escritos en lenguajes distintos. No hay instalación de SDK ni versión de client library que mantener: es HTTP común, callable desde cualquier runtime sin dependencia adicional. Eso reduce la decisión de “qué cliente de qué lenguaje hay que actualizar” cada vez que alguien agrega un worker nuevo. El costo que no se va a ningún lado es el mismo de siempre: la idempotencia y la política de reintento siguen siendo responsabilidad de tu código, no de la cola.
Cómo decidir en la práctica, sin mirar la tabla
Antes de comparar features, respondé estas cuatro preguntas en orden. La primera que te dé una respuesta clara suele cerrar la decisión:
- ¿Ya pagás el costo operativo de Redis en producción? Si sí, BullMQ no te agrega infraestructura nueva, solo un patrón de trabajo sobre lo que ya tenés.
- ¿Tu aplicación corre adentro de un estado AWS (Lambda, ECS, RDS)? Si sí, SQS es la opción con menos piezas sueltas, aunque te deja la gestión de permisos IAM como tarea propia.
- ¿El envío del email depende de aprobaciones, pasos condicionales o coordinar varios sistemas antes de confirmar? Si sí, ya no es un problema de cola: es un problema de orquestación, y ahí Temporal (u otro motor de workflows) evita que reconstruyas esa lógica a mano con banderas y reintentos.
- ¿Tenés workers en más de un lenguaje, o querés que cualquiera del equipo pueda integrar sin instalar un SDK? Si sí, una cola REST genérica minimiza la fricción de integración, a costa de que vos mismo implementes la capa de idempotencia.
Si ninguna pregunta te da una respuesta contundente, el desempate razonable es la opción que ya conocés operar: la curva de aprendizaje de una pieza nueva de infraestructura rara vez compensa una ganancia marginal de features.
| Opción | Mejor para | Boundary que seguís operando |
|---|---|---|
| BullMQ | Servicio Node.js que ya corre Redis | Persistencia y operación de Redis |
| Amazon SQS | Aplicación centrada en AWS | Permisos y configuración de AWS |
| Temporal | Timers, joins y flujos multi-paso | Operación y modelado del servicio de workflow |
| Cola REST | Workers en distintos lenguajes, un solo boundary HTTP | Idempotencia y política de reintentos del consumidor |
¿Cuáles son los límites técnicos de las colas de mensajes para emails?
Los límites concretos son los que definen qué podés construir antes de elegir proveedor. La guía de referencia detalla, para el caso de una cola REST: delay máximo de 604.800 segundos (7 días), retención de hasta 30 días, y tamaño de mensaje de 256KB.
¿Por qué importa el límite de 256KB? Porque te obliga a mandar un reportId en el mensaje en vez del reporte renderizado completo. El worker busca el contenido real cuando lo necesita, no antes.
Hay otro detalle que rompe expectativas: la ventana de deduplicación FIFO es de 5 minutos. Eso no es una garantía de exactly-once, es una ventana corta. Las colas estándar siguen siendo at-least-once. Si tu worker tarda más que esa ventana en confirmar, o si el proveedor acepta el request pero el cliente nunca ve la respuesta porque el worker se cae, vas a ver el mismo mensaje una segunda vez. Diseñar para eso, no contra eso, es lo que separa un sistema de entrega confiable de uno que manda reportes duplicados cada tanto.
¿Cómo evito que un email se envíe dos veces usando colas de trabajo?
Evitás el doble envío guardando un registro durable de qué eventId ya se procesó, antes de confirmar el mensaje en la cola. La clave identifica el evento de entrega, no el reporte: un mismo reporte puede generar múltiples intentos de entrega, y cada intento necesita su propio control. En resolver errores 500 en endpoints de Vercel profundizamos sobre esto.
Subís el job a la cola, el worker lo toma, llama al proveedor de email, el proveedor tarda, el worker hace timeout, la cola redelivera el mismo mensaje, y si no tenés un registro durable de qué eventId ya mandaste, el usuario recibe el mismo reporte dos veces sin que nadie se dé cuenta hasta que se queja por soporte.
El patrón mínimo que sugiere la fuente separa tres responsabilidades: identidad del evento, política de reintento, y verificación de duplicado antes de llamar al proveedor.
type DeliveryJob = {
 eventId: string;
 reportId: string;
 recipient: string;
 attempt: number;
};

async function deliver(job: DeliveryJob): Promise<void> {
 if (await sentEvents.has(job.eventId)) return;

 try {
 await emailProviderSend({
 to: job.recipient,
 reportId: job.reportId,
 idempotencyKey: job.eventId,
 });
 await sentEvents.record(job.eventId);
 } catch (error) {
 if (job.attempt >= 5) throw error;
 await queuePublish({
 ...job,
 attempt: job.attempt + 1,
 delaySeconds: Math.min(604800, 2 ** job.attempt * 60),
 });
 }
}
sentEvents tiene que ser durable. Un Set en memoria desaparece apenas el worker se reinicia (y se va a reiniciar). El tope de 5 intentos con backoff exponencial, capado en 604.800 segundos, es lo que impide que un error permanente genere reintentos infinitos. Vale la pena notar por qué el backoff es exponencial y no fijo: un error de 1 segundo probablemente se resuelve solo, pero un error que persiste después del tercer o cuarto intento casi nunca se arregla reintentando más rápido — espaciar los intentos reduce la carga sobre un proveedor que ya está fallando, en vez de insistirle con la misma frecuencia. Esta parte no tiene nada de glamorosa, pero es la que evita que un usuario reciba el mismo reporte dos veces.
¿Qué cambia cuando el sistema de emails diferidos crece en escala?
A escala, la recomendación central es separar generación de entrega. El worker que arma el reporte no debería ser el mismo que lo manda, porque así podés escalar cada parte según su propia carga.
- Persistí el estado de cada evento: no solo si se envió, sino en qué intento está y cuándo entró a la cola.
- Trackeá edad y cantidad de intentos: un mensaje que lleva muchos intentos en la cola es una señal de que algo río abajo está roto, no de que hay que seguir reintentando.
- Habilitá un camino de redrive para dead-letter queue: los mensajes agotados necesitan un operador que los revise, no que se pierdan.
- Guardá solo la referencia del reporte, nunca el cuerpo: el techo de 256KB por mensaje ya te lo exige, pero conviene como regla general incluso si el límite fuera mayor.
Ojo con lo que una cola de mensajes no hace bien. No hay debounce ni throttle nativo: un publish no hace fan-out automático hacia múltiples consumer groups, así que si necesitás que varios sistemas reaccionen al mismo evento, necesitás colas separadas por consumidor. Las suscripciones push requieren targets HTTPS públicos, lo cual complica callbacks internos. Y un cron pausado no hace backfill de los triggers que se perdieron mientras estaba pausado: si tu reporte diario no salió el martes porque pausaste el cron, el miércoles no sale “el del martes y el del miércoles”, sale solo el del día que corresponde. Sobre eso hablamos en desplegar tu proyecto en Vercel.
Si tu backend no corre en una plataforma serverless como Vercel sino en un servidor propio, por ejemplo en donweb.com, la lógica de cron → queue → worker es la misma: cambia dónde corre el cron, no el diseño de la entrega.
Errores comunes al implementar colas de trabajo node.js para emails
- Usar el cron job como generador del reporte: si el reporte tarda más que el límite de ejecución (900 segundos en el caso de Vercel), el cron se corta antes de terminar. El cron solo debería publicar en la cola, no generar contenido pesado.
- Guardar el registro de eventos enviados en memoria: un reinicio de proceso borra ese Set y el siguiente intento manda el email de nuevo. El registro de idempotencia necesita persistencia real, no una variable en RAM.
- Confundir la ventana de deduplicación FIFO con exactly-once: una ventana de 5 minutos no te cubre si el proveedor de email tarda más que eso en responder. Las colas estándar son at-least-once siempre, sin excepción.
- Mandar el reporte completo dentro del mensaje: además de chocar contra el límite de 256KB, acopla la cola al contenido del negocio. El mensaje debería llevar un
reportId, nunca el cuerpo renderizado.
Preguntas Frecuentes
¿Qué diferencia hay entre un cron job y una cola de mensajes para enviar emails?
El cron job decide cuándo disparar un evento, con un límite de ejecución fijo (900 segundos en Vercel) y solo llama a una URL pública. La cola de mensajes sostiene el intento de entrega, reintenta si falla, y mantiene el mensaje disponible hasta por 7 días según el caso descrito en la fuente de referencia.
¿BullMQ o Amazon SQS para programar emails diferidos en Node.js?
BullMQ es la opción más natural si tu aplicación Node.js ya corre Redis en producción, porque el modelo mental queda cerca del código. Amazon SQS conviene si tu infraestructura ya vive dentro de AWS y preferís no operar Redis, aunque suma permisos de AWS como boundary propio.
¿Cómo evito que un email se envíe dos veces usando colas de trabajo?
Guardá un registro durable de cada eventId procesado y verificalo antes de llamar al proveedor de email. Mandá ese mismo identificador como idempotencyKey al proveedor, para que incluso si tu worker reintenta, el proveedor también pueda detectar el duplicado.
¿Cuál es el límite de ejecución de un cron job en Vercel?
El cron job en Vercel hace un request HTTP GET a tu deployment de producción y tiene un límite de ejecución que, en el caso analizado, es de 900 segundos. Además, un cron pausado no hace backfill de los triggers que se perdieron durante la pausa.
¿Cuándo conviene usar Temporal en lugar de una cola para enviar emails?
Temporal conviene cuando el envío deja de ser una entrega simple y pasa a tener aprobaciones, fan-out con join posterior, o pasos de compensación si algo falla a mitad de camino. Si solo necesitás reintentar un envío con backoff, una cola alcanza y Temporal es sobreingeniería.
Conclusión
La arquitectura cron → queue → worker no es una moda, es la respuesta a un límite concreto: ningún cron job está pensado para hospedar trabajo pesado ni para sostener reintentos. Elegí BullMQ si ya pagás el costo operativo de Redis, SQS si vivís en AWS, Temporal si el envío es en realidad un flujo con estados, y una cola REST si tenés workers mixtos y querés un solo boundary HTTP. Lo que no cambia con ninguna opción es tu responsabilidad: identidad del evento, política de reintento y manejo de duplicados quedan en tu código, no en el proveedor de la cola.