Cómo funciona el kernel de Linux, explicado simple
En pocas palabras: El kernel de Linux es el programa que administra procesos, memoria y dispositivos entre el hardware y los programas de usuario, corriendo en “modo kernel” privilegiado. Según el resumen del capítulo 1 de How Linux Works (3ra edición, Brian Ward), usa fork(), exec() y la MMU para gestionar todo el sistema.
Entender cómo funciona el kernel de Linux arranca con una idea simple: es el programa que gestiona procesos, memoria y dispositivos entre el hardware y los programas de usuario. El resumen del capítulo 1 de How Linux Works (3ra edición, de Brian Ward), publicado en dev.to el 23 de octubre de 2026, repasa esa lógica con ejemplos concretos como fork(), exec() y la MMU. Más abajo le agregamos algo que el resumen original no cubre: cómo usar ese modelo mental para ubicar, en la práctica, en qué capa buscar cuando algo se rompe.
El kernel es la pieza central del sistema operativo Linux: la interfaz entre el hardware (CPU, memoria RAM, dispositivos) y los programas que corrés en tu terminal. Administra procesos, memoria y drivers, y corre en modo privilegiado o “modo kernel”, distinto del modo usuario, donde operan los programas comunes con permisos restringidos. El sistema operativo completo incluye mucho más que el kernel, pero el kernel es su parte más importante.
En este artículo:
- En 30 segundos
- ¿Qué son las capas de abstracción en Linux (hardware, kernel y usuario)?
- ¿Qué es un proceso y cómo se representa en la memoria RAM?
- ¿Cuál es la diferencia entre modo kernel y modo usuario?
- ¿Cómo funciona el kernel de Linux y qué funciones cumple exactamente?
- ¿Cómo funciona el context switching entre procesos?
- ¿Qué es la MMU y cómo evita que un proceso acceda a la memoria de otro?
- ¿Qué son fork() y exec() y cómo se crea un proceso nuevo?
- ¿Qué rol tienen los usuarios y el superusuario root en Linux?
- Cómo usar este modelo para ubicar un problema: una guía de criterios
- Errores comunes al entender el kernel de Linux
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Linux divide todo en tres capas: hardware, kernel y usuario, según el resumen del capítulo 1 de How Linux Works (3ra edición).
- El kernel corre sin restricciones en modo kernel; los programas comunes operan en modo usuario con memoria separada.
- Cada proceso nuevo nace con fork() (se copia) y exec() (se reemplaza), el mismo mecanismo que usa la terminal con “ls”.
- La MMU traduce direcciones virtuales a físicas para que ningún proceso pise la memoria de otro.
- Todo proceso pertenece a un usuario; root es el único con permisos sin restricciones sobre el sistema entero.
¿Qué son las capas de abstracción en Linux (hardware, kernel y usuario)?
Linux organiza todo el sistema en tres capas que se apoyan una sobre otra: hardware, kernel y usuario. Cada capa esconde la complejidad de la que tiene debajo, así que no necesitás entender los transistores de la CPU para escribir un script en bash.
Es la misma lógica que manejar un auto. Para andar no necesitás saber cómo funciona el motor, solo cómo usar el volante y los pedales. Si sos mecánico, ahí sí tenés que meterte con el motor (sin que te pidan el título de ingeniero), aunque tampoco te importa de dónde salió el hierro con el que se fabricó. Abstracción sobre abstracción, ponele.
- Capa de hardware: los componentes físicos, CPU, memoria RAM, teclado, disco.
- Capa de kernel: es la interfaz entre el hardware y los programas, administra procesos, drivers y memoria.
- Capa de usuario: ahí corren los procesos que ejecutás vos, cada uno con su porción de recursos asignada por el kernel.
Ojo con algo: el kernel no es lo mismo que el sistema operativo. El sistema operativo incluye al kernel más un montón de herramientas, bibliotecas y utilidades alrededor. El kernel es la pieza central, pero no es todo el paquete.
¿Qué es un proceso y cómo se representa en la memoria RAM?
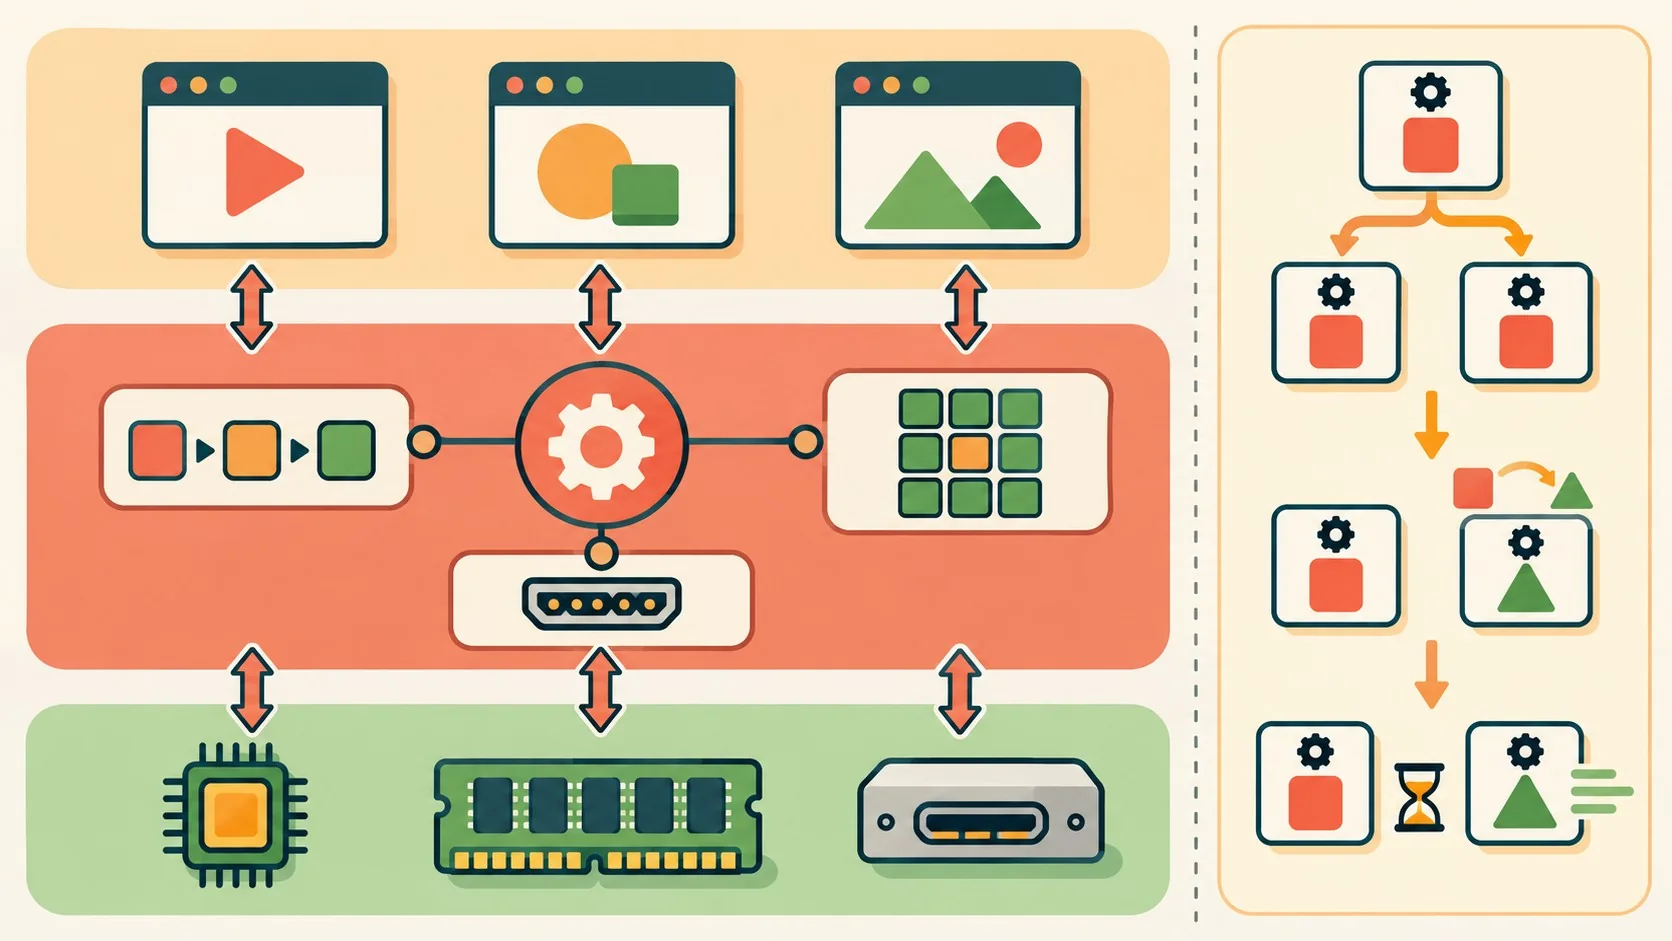
Un proceso en Linux es, nada más y nada menos, el estado de un programa guardado en la memoria RAM en un momento dado. La RAM es una fila gigante de interruptores diminutos que valen 0 o 1 (bits), y la CPU lee y cambia esos bits todo el tiempo.
La combinación exacta de esos bits en un instante determinado se llama estado. Cuando el kernel “pausa” un proceso y después lo retoma, lo único que hace es guardar ese estado y volver a cargarlo después. Nada raro, solo bits moviéndose de un lugar a otro.
¿Cuál es la diferencia entre modo kernel y modo usuario?
La diferencia está en los permisos: el kernel corre en modo kernel, sin restricciones, y los programas comunes corren en modo usuario, con acceso limitado a la memoria y al hardware. Esa separación existe por una razón concreta, si un programa con malas intenciones pudiera tocar la memoria de cualquier otro proceso, todo el sistema quedaría expuesto.
Por eso cada proceso de usuario tiene su propia porción de RAM, separada del resto. ¿Qué pasa si un programa intenta meterse en la memoria de otro proceso? El kernel lo frena ahí mismo, antes de que llegue a tocar nada que no sea suyo. Así de simple.
¿Cómo funciona el kernel de Linux y qué funciones cumple exactamente?
El kernel de Linux cumple cuatro tareas centrales: gestión de procesos, gestión de memoria, manejo de device drivers y soporte para system calls. Esas cuatro responsabilidades son las que lo convierten en la pieza que conecta el hardware con todo lo que corrés en tu sesión.
La gestión de procesos cubre desde que un programa arranca hasta que termina, pasando por pausarlo, reanudarlo y decidir cuándo le toca usar la CPU. La gestión de memoria controla qué está en uso, qué está libre y qué se comparte entre procesos. Los device drivers traducen llamadas genéricas como read() u open() en señales que entiende el hardware real. Las system calls son el canal por el que un programa de usuario le pide favores al kernel, cosas que no puede hacer solo.
Un detalle que se presta a confusión: malloc() no es una system call. Es una función de la biblioteca de C que, por debajo, usa llamadas como brk() o mmap() para pedirle memoria al kernel. La diferencia parece de detalle, pero entenderla te ahorra confusiones cuando estás debuggeando algo de bajo nivel.
¿Cómo funciona el context switching entre procesos?
El context switching es el mecanismo con el que el kernel hace que varios procesos parezcan correr al mismo tiempo en una CPU que, en realidad, atiende a uno solo por vez (hablando de un solo núcleo). El cambio es tan rápido que a simple vista no lo notás.
Según el resumen del capítulo, el proceso tiene varios pasos bien definidos: la CPU interrumpe al proceso en ejecución cuando se le acaba el turno, pasa a modo kernel, guarda el estado completo del proceso (registros, memoria, todo), resuelve cualquier trabajo pendiente como una operación de entrada/salida, revisa la cola de procesos esperando turno, elige uno según la política de scheduling, carga sus datos y por último le dice a la CPU cuánto tiempo va a correr antes de volver a modo usuario.
Ejemplo hipotético: imaginate que tenés una sola CPU y dos procesos corriendo, un compilador y un reproductor de música. Vos escuchás la música sin cortes, pero en realidad el kernel le da unos milisegundos al compilador, lo pausa, guarda su estado, le da su turno al reproductor, lo pausa también, y vuelve al compilador. Ese ida y vuelta pasa cientos de veces por segundo, por eso tu oído no detecta ningún salto. Si el compilador se cuelga o entra en un loop infinito, el kernel sigue haciendo los cortes igual, así que la música no se traba (aunque el compilador nunca termine). Ese es, en esencia, el valor práctico del context switching: aislar el mal comportamiento de un proceso del resto.
¿Qué es la MMU y cómo evita que un proceso acceda a la memoria de otro?
La MMU (Memory Management Unit) es el componente de la CPU que traduce las direcciones de memoria virtuales que usa cada proceso en las direcciones físicas reales de la RAM. Gracias a esa traducción, ningún proceso puede meterse en la memoria física que no le corresponde.
Cuando un proceso pide acceder a una dirección de memoria, no está tocando la dirección real, está usando una dirección virtual que la MMU convierte al vuelo. El kernel también cumple reglas estrictas: tiene su propia zona privada que ningún proceso puede tocar, cada proceso de usuario tiene la suya, y algunos bloques de memoria pueden compartirse entre procesos o quedar marcados como de solo lectura. Si el sistema se queda corto de RAM, puede usar espacio en disco como memoria auxiliar.
¿Qué son fork() y exec() y cómo se crea un proceso nuevo?
fork() y exec() son las dos system calls que Linux usa para crear procesos nuevos: fork() hace una copia idéntica del proceso que la llama, y exec() reemplaza ese proceso (o su copia) por un programa distinto. Con esas dos piezas alcanza para entender cómo nace casi cualquier proceso en el sistema.
Ponele que escribís “ls” en la terminal. Lo que pasa adentro es así: tu shell llama a fork() y se clona a sí mismo, esa copia (el “hijo”) llama a exec(“ls”), que la reemplaza por el programa ls, y mientras tanto el shell original (el “padre”) espera a que termine para devolverte el prompt. El único proceso que no nace de este mecanismo es init, con PID 1, el primer proceso que arranca el kernel al bootear.
Criterio práctico: cuando un proceso hijo se queda “trabado” y no libera recursos aunque ya terminó, suele deberse a que el padre nunca llamó a una función para recoger su estado final (lo que en la jerga se conoce como proceso zombie). No hace falta memorizar el código del kernel para esto: basta con recordar que fork() crea una relación padre-hijo, y que esa relación tiene que cerrarse correctamente para que el sistema libere la entrada en su tabla de procesos.
¿Qué rol tienen los usuarios y el superusuario root en Linux?
En Linux, todo proceso le pertenece a un usuario, y es el kernel el que decide qué puede hacer cada uno según ese dueño. Un usuario normal puede tocar sus propios archivos y procesos, pero no los de otra cuenta.
Después está root, el superusuario, que puede hacer lo que quiera sin que el sistema le pregunte nada. Pensalo como la “llave maestra” de toda la casa. Con ese poder viene la responsabilidad: un comando mal tipeado como root puede romper el sistema entero (sí, en serio, y pasa más seguido de lo que te gustaría admitir).
Cómo usar este modelo para ubicar un problema: una guía de criterios
Tener claras las tres capas y los mecanismos de fork/exec, context switching y MMU no es solo teoría: sirve como mapa para decidir dónde mirar primero cuando algo anda mal. Esta es una forma de ordenar esa búsqueda, apoyada en los conceptos que ya vimos:
- ¿El síntoma es “todo se cuelga de golpe” o un reinicio inesperado? Es señal de que el problema está más cerca de la capa de kernel o hardware (drivers, módulos, memoria del kernel). Ahí tiene sentido revisar los logs del propio kernel antes que los de una aplicación particular.
- ¿Un solo programa se comporta mal pero el resto del sistema sigue andando normal? Eso apunta a la capa de usuario: ese proceso vive en su propio espacio de memoria, así que el problema probablemente está contenido ahí, no en el kernel.
- ¿Aparece un error de “memoria no accesible” o el proceso se cierra solo sin aviso? Pensá en la MMU: el proceso intentó tocar una dirección virtual que no tenía mapeada a una física válida. El kernel corta por lo sano antes de que el daño se propague a otro proceso.
- ¿Un proceso “hijo” quedó dando vueltas después de que su tarea terminó? Repasá la relación fork()/exec() entre padre e hijo: es el lugar más común donde se acumulan procesos que nadie “limpió” del todo.
- ¿Notás que todo responde más lento pero nada se rompe? Puede ser una señal de que el scheduler está repartiendo más context switches de los que la CPU puede sostener cómodamente, algo típico cuando hay demasiados procesos compitiendo por muy poco tiempo de CPU.
Ninguno de estos criterios reemplaza un diagnóstico específico de cada caso, pero ayudan a no perder tiempo buscando en la capa equivocada antes de meterse en el detalle.
Errores comunes al entender el kernel de Linux
- Confundir kernel con sistema operativo: el kernel es una pieza del sistema operativo, no el paquete completo. GNU, las bibliotecas y las herramientas de usuario también forman parte del SO.
- Pensar que malloc() es una system call: es una función de biblioteca que usa brk() o mmap() por debajo. La llamada real al kernel queda un nivel más abajo.
- Creer que los procesos corren en simultáneo de verdad en un solo núcleo: lo que ves es context switching tan rápido que da la ilusión de paralelismo, no paralelismo real.
- Trabajar como root todo el tiempo por comodidad: ahorra un sudo cada tanto, pero multiplica el riesgo de romper algo sin querer. Usá tu usuario normal y escalá privilegios solo cuando haga falta.
Preguntas Frecuentes
¿Qué es el kernel de Linux y para qué sirve?
El kernel de Linux es el programa central del sistema operativo que administra procesos, memoria, dispositivos y las llamadas al sistema. Es la interfaz entre el hardware de la máquina y los programas que corrés en el día a día, decidiendo qué proceso usa la CPU en cada momento y cuánta memoria le toca a cada uno. Relacionado: por qué un servidor cae con CPU libre.
¿Qué diferencia hay entre modo kernel y modo usuario?
En modo kernel, el sistema corre sin restricciones y puede acceder a toda la memoria y el hardware; en modo usuario, los programas comunes tienen acceso limitado a su propia porción de memoria. Esa separación evita que un proceso cualquiera pueda dañar al resto del sistema o leer datos que no le pertenecen.
¿Cómo crea Linux un proceso nuevo con fork y exec?
Linux crea procesos nuevos combinando dos system calls: fork(), que clona el proceso que la llama, y exec(), que reemplaza esa copia por un programa distinto. Es el mismo mecanismo que usa la terminal cada vez que ejecutás un comando como ls o cat.
¿Qué es el context switching y por qué los procesos parecen simultáneos?
El context switching es el proceso por el cual el kernel guarda el estado de un proceso, carga el de otro y cambia entre ellos tan rápido que da la sensación de que corren al mismo tiempo. En una CPU de un solo núcleo, en realidad cada proceso usa la CPU de a uno, por turnos muy breves.
¿Qué hace la MMU en la gestión de memoria de Linux?
La MMU traduce las direcciones de memoria virtuales que manejan los procesos en direcciones físicas reales dentro de la RAM. Ese paso intermedio es lo que impide que un proceso acceda, por error o a propósito, a la memoria física que le corresponde a otro.
Conclusión
Entender estas piezas (procesos, modos de ejecución, context switching, MMU, fork/exec) cambia la forma de leer cualquier error o log del sistema. La próxima vez que veas un “segmentation fault” o un proceso zombie, vas a saber en qué capa de esas tres buscar el problema, y el cuadro de criterios de arriba te da un punto de partida concreto en lugar de tirar comandos al azar.
El resumen del capítulo 1 de How Linux Works deja algo claro: no hace falta memorizar código del kernel para operar Linux con criterio. Alcanza con tener el modelo mental correcto, el que separa hardware, kernel y usuario, y que explica por qué cada proceso vive aislado hasta que decide, con fork() y exec(), convertirse en otra cosa.