Deploy sin downtime en Kubernetes: probes, preStop y PDB
En pocas palabras: Un deploy sin downtime en Kubernetes se logra combinando probes de readiness, liveness y startup, RollingUpdate con maxUnavailable: 0, un preStop con sleep 10 más manejo de SIGTERM y un PodDisruptionBudget con minAvailable: 3 sobre 4 réplicas, según la guía de ByteBridge Talent del 14/10/2026.
El deploy sin downtime en Kubernetes necesita cuatro piezas trabajando juntas: probes que frenen el tráfico a pods no listos, maxUnavailable: 0, un preStop con manejo de SIGTERM y un PodDisruptionBudget. Lo detalla una guía de ByteBridge Talent publicada el 14/10/2026.
Un deploy sin downtime en Kubernetes es una actualización de la imagen de un Deployment durante la cual el Service nunca se queda sin pods que puedan atender y ninguna conexión en curso se corta. Lo conseguís combinando readiness, liveness y startup probes, la estrategia RollingUpdate con maxUnavailable en 0, un cierre ordenado del pod y un PodDisruptionBudget que limita los drains y las evicciones voluntarias.
En este artículo:
- En 30 segundos
- ¿Por qué aparecen errores 502 en cada deploy de Kubernetes aunque uses rolling update?
- ¿Cómo configurar readiness, liveness y startup probes con rolling update y maxUnavailable: 0?
- ¿Cómo hacer un graceful shutdown con preStop y SIGTERM en Kubernetes?
- ¿Para qué sirve un PodDisruptionBudget y qué pasa si minAvailable es igual a las réplicas?
- ¿Cómo comprobar que un deploy sin downtime en Kubernetes funciona?
- Errores comunes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
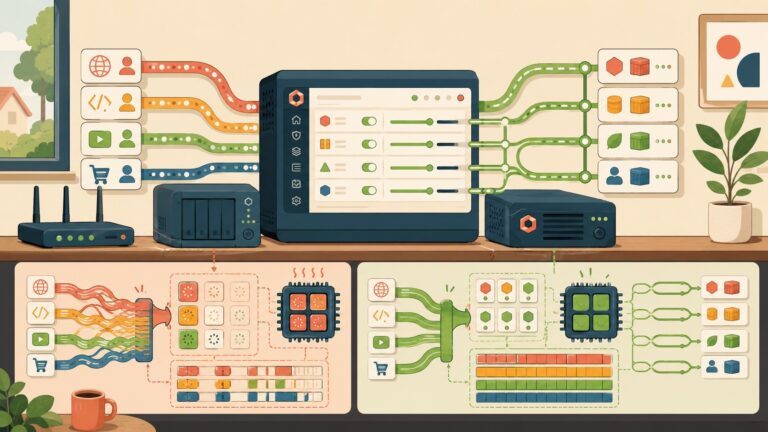
- Los 502 aparecen por tres causas: pods nuevos que reciben tráfico sin estar listos, pods viejos que se apagan con requests en vuelo y demasiados pods que desaparecen a la vez.
- La guía usa 4 réplicas,
maxSurge: 25%,maxUnavailable: 0yminReadySeconds: 10. - El
preStopconsleep 10y unterminationGracePeriodSecondsde 45 s mantienen al pod sirviendo mientras se actualizan los endpoints. - Un PDB con
minAvailable: 3sobre 4 réplicas deja evictar un pod por vez. ConminAvailableigual a las réplicas, los drains quedan bloqueados.
¿Por qué aparecen errores 502 en cada deploy de Kubernetes aunque uses rolling update?
Los 502 aparecen cuando el tráfico llega a un pod que todavía no puede atenderlo o a uno que ya se está apagando. Según la guía de ByteBridge, los defaults del rolling update son solo una parte: hacen falta probes correctas, una estrategia de rollout sensata, cierre ordenado y protección contra disrupciones voluntarias.
- Pods nuevos sin estar listos. El proceso corre, pero los caches, los pools de base de datos o el warm-up del JIT no terminaron. OneUptime agrega que, sin readiness probe, Kubernetes da el contenedor por listo apenas está corriendo.
- Pods viejos con requests en vuelo. La quita de endpoints y el SIGTERM pasan en paralelo, así que el pod puede recibir conexiones nuevas después de empezar a apagarse.
- Caen demasiados pods al mismo tiempo. Un rollout combinado con un drain de nodo o un scale-down del autoscaler puede dejar la capacidad por debajo de lo que pide el tráfico.
Ponele que deployás a media tarde, el pod nuevo levanta el proceso, el Service lo suma a los endpoints porque no hay readiness probe, el JIT está frío, el pool a la base ni arrancó y los primeros requests devuelven 502 mientras el pod viejo, que ya recibió SIGTERM, sigue aceptando conexiones nuevas durante unos segundos.
Aclaración: esto es una guía práctica, no un lanzamiento de Kubernetes. Tampoco trae mediciones de cuánto bajan los 502, así que son configuraciones razonables, no resultados comprobados. Te puede servir nuestra cobertura de cómo se comportan los StatefulSets con los datos.
¿Cómo configurar readiness, liveness y startup probes con rolling update y maxUnavailable: 0?
Se configura una readiness probe que controle la entrada al Service, una liveness probe que solo reinicie procesos trabados y una startup probe que dé tiempo de arranque, junto con RollingUpdate y maxUnavailable: 0. El manifiesto de ByteBridge usa 4 réplicas, maxSurge: 25% (un pod extra) y minReadySeconds: 10.
- Readiness: decide si el pod está en los endpoints del Service. Si falla, deja de recibir tráfico y no se reinicia. En el ejemplo apunta a
/ready, cada 5 s, con timeout de 2 s y 2 fallos de umbral. - Liveness: decide si el kubelet reinicia el contenedor. Es para “este proceso está colgado” y nada más. En el ejemplo apunta a
/healthz, cada 10 s, con 3 fallos. - Startup: retrasa la liveness mientras la app arranca. Con
periodSeconds: 5yfailureThreshold: 24le da hasta 120 s de arranque.
Los probes los ejecuta el kubelet, como explica la documentación oficial del ciclo de vida del Pod. El detalle fino es el endpoint de liveness: tiene que ser barato y local. Si /healthz consulta la base y la base parpadea, se reinician todos los pods a la vez. Ahí la liveness deja de ser protección y pasa a ser el problema.
Eso también aplica a la configuración de OneUptime, que usa /health para readiness y liveness. Es válido solo si ese endpoint no mira dependencias externas (inferencia mía a partir del pitfall que marca ByteBridge).
strategy:
 type: RollingUpdate
 rollingUpdate:
 maxSurge: 25%
 maxUnavailable: 0
minReadySeconds: 10
Con maxUnavailable: 0, Kubernetes no saca un pod viejo hasta que haya uno nuevo Ready. minReadySeconds: 10 exige que el nuevo se mantenga Ready 10 s antes de contar como disponible, y así atrapa apps que pasan el primer chequeo y se caen después.
El costo es capacidad: necesitás lugar para los pods extra. Si el cluster está justo, el rollout se queda en Pending en vez de tirar tráfico, que es el modo de falla que conviene (si corrés el cluster en VPS o servidores cloud, por ejemplo en donweb.com, dejá ese margen previsto). Definí también progressDeadlineSeconds (default 600) para que un rollout trabado se reporte como fallido y rollout status salga con error.
¿Cómo hacer un graceful shutdown con preStop y SIGTERM en Kubernetes?
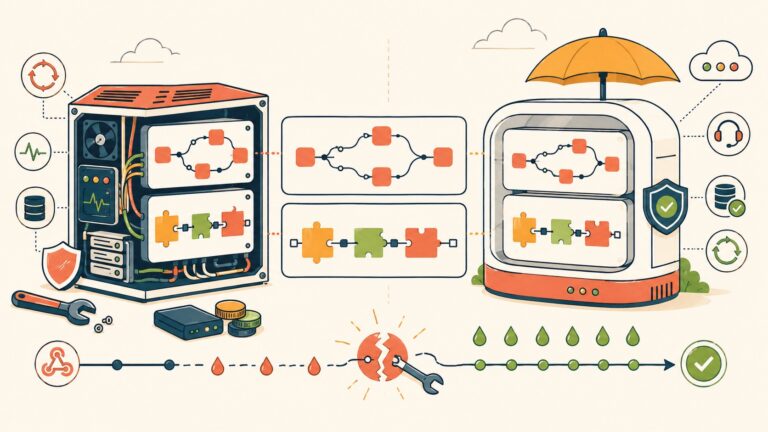
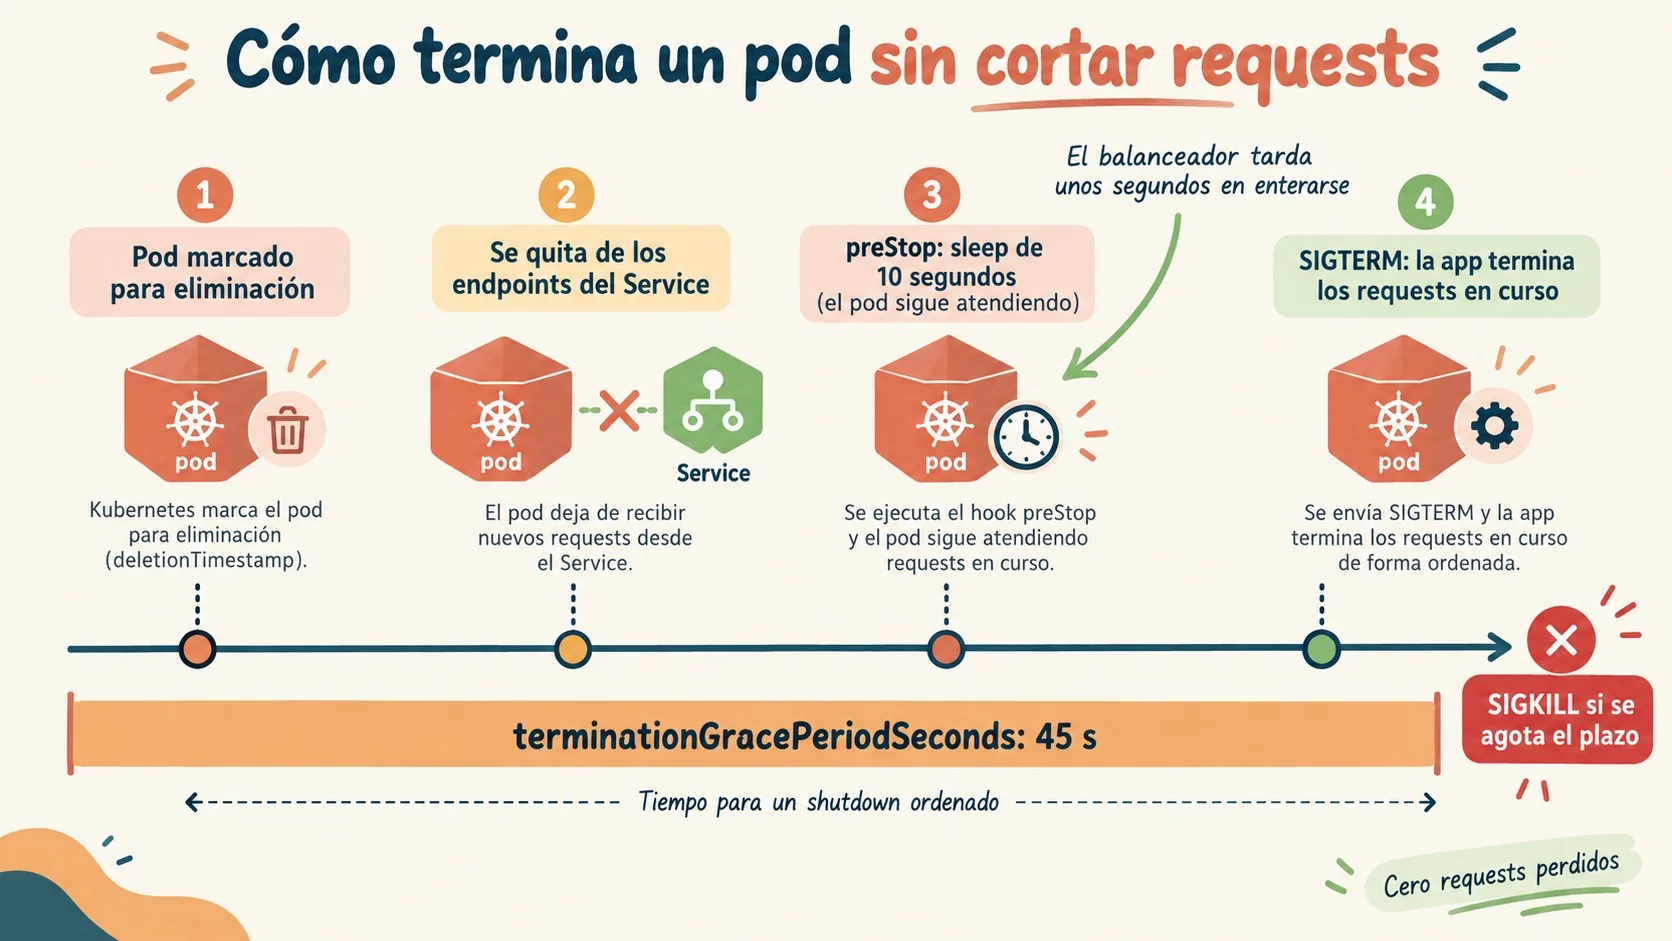
Cuando Kubernetes borra un pod, manda SIGTERM y en paralelo lo saca de los endpoints; kube-proxy, los ingress controllers y los balanceadores cloud tardan unos segundos en enterarse. El preStop con sleep 10 mantiene al pod sirviendo en esa ventana, y recién después SIGTERM llega al proceso. Si te interesa otro tipo de despliegue, mirá nuestra guía para desplegar una app React con Vite.
Las dos guías coinciden en el sleep y difieren en el valor: ByteBridge usa 10 s con terminationGracePeriodSeconds: 45, y OneUptime usa 15 s con 60 s de gracia. El default del grace period es 30 s, según la documentación oficial. Tomalo como punto de partida y ajustalo a lo que tarde tu balanceador en sacar al pod.
La app también tiene que cooperar. El ejemplo en Python de ByteBridge atrapa SIGTERM y llama a server.shutdown() en un thread aparte, porque shutdown() bloquea hasta que serve_forever termina. El ejemplo en Node.js de OneUptime rechaza requests nuevas con 503, cierra el server y fuerza la salida a los 25 s.
La cuenta es simple. El grace period tiene que superar el preStop más tu request más largo; con 45 s y un sleep de 10, quedan 35 s para terminar requests (cálculo propio). Pasado ese tiempo, el kubelet manda SIGKILL en plena respuesta.
Ojo con command: ["sh", "-c", "python app.py"]. Puede dejar sh como PID 1, y no reenvía SIGTERM. Usá exec o un init como tini. En qué hacer cuando fallan los deploys profundizamos sobre esto.
¿Para qué sirve un PodDisruptionBudget y qué pasa si minAvailable es igual a las réplicas?
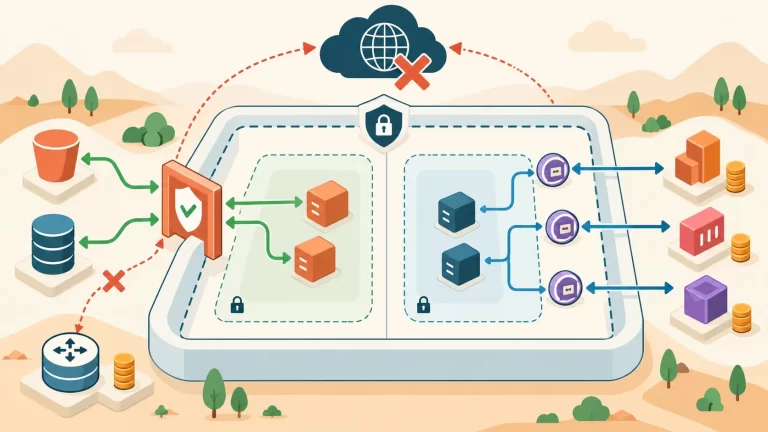
Un PodDisruptionBudget (PDB) le indica a la Eviction API cuántos pods de una aplicación tienen que seguir disponibles durante disrupciones voluntarias: kubectl drain, upgrades de cluster o scale-down del autoscaler. Según la documentación oficial, es estable desde Kubernetes v1.21.
Con 4 réplicas y minAvailable: 3, un drain evicta como máximo un pod de web por vez y espera a que el reemplazo esté Ready. Para que un solo drain no se lleve a la mayoría, ByteBridge suma topologySpreadConstraints con maxSkew: 1 y topologyKey: kubernetes.io/hostname.
El PDB tiene límites que conviene tener presentes:
- No cubre fallas involuntarias. Si un nodo se cae con el conjunto en el mínimo, la disponibilidad baja igual.
- Un budget en cero bloquea los drains. Con
minAvailableigual a las réplicas, omaxUnavailable: 0, el drain de un nodo con esos pods nunca termina y los upgrades quedan colgados. - Los pods que no reportan Ready también cuentan. Con la política por defecto (
IfHealthyBudget), aplicaciones enCrashLoopBackOffpueden bloquear drains. Desde Kubernetes 1.31 existeunhealthyPodEvictionPolicy: AlwaysAllowpara evitarlo.
La documentación recomienda maxUnavailable sobre minAvailable porque se adapta solo si cambia la cantidad de réplicas.
¿Cómo comprobar que un deploy sin downtime en Kubernetes funciona?
Se comprueba corriendo un loop de requests contra el Service mientras hacés el deploy: cualquier línea que se imprima es un request perdido. El script de ByteBridge cambia la imagen con kubectl set image, anota el change-cause, espera con rollout status --timeout=300s y ejecuta rollout undo si falla.
while true; do
 code=$(curl -s -o /dev/null -w '%{http_code}' http://web.default.svc.cluster.local/)
 [ "$code" != "200" ] && echo "$(date +%T) got $code"
 sleep 0.1
done
Esta parte es mi propuesta editorial, no de la fuente ni probada por nosotros. Corré el loop desde un pod dentro del cluster durante tres rollouts seguidos y, en uno de ellos, un drain de nodo. Si no se imprime ninguna línea, la configuración pasa en ese entorno. Si aparece un solo 502, mirá primero el preStop y la readiness. Cubrimos ese tema en detalle en evitar errores de YAML en Kubernetes.
Hay límites. El loop corre un request cada 0,1 s desde un solo cliente y apunta al DNS interno del Service, o sea que no pasa por tu ingress ni por el balanceador externo, que es donde suelen estar los segundos de desfasaje. Tampoco cubre conexiones largas como websockets. Y la guía es evidencia de un solo equipo: validala con el tráfico y el ingress de cada entorno.
Errores comunes
- Liveness idéntica a la readiness y chequeando la base. Una caída de la dependencia se vuelve una tormenta de reinicios. Hacé que
/healthzsolo diga si el proceso está vivo. - Sin
preStop. El tráfico sigue llegando a pods que se están terminando y aparecen connection resets. Agregá el sleep. - Una sola réplica. Ni probes ni PDB hacen zero-downtime con un pod. Corré al menos dos.
- Timeouts de probe demasiado ajustados. Un timeout de 1 s en una JVM con mucho GC genera flapping bajo carga. Subilo.
- Grace period menor al
preStopmás el request más largo. El kubelet manda SIGKILL a mitad de respuesta. Hacé la cuenta antes de deployar.
Preguntas Frecuentes
¿Cuál es la diferencia entre readiness, liveness y startup probe?
La readiness decide si el pod recibe tráfico (si falla, sale de los endpoints y no se reinicia), la liveness decide si se reinicia el contenedor y la startup retrasa la liveness hasta que la app terminó de arrancar. Usá la liveness solo para procesos colgados.
¿Qué hace el preStop con sleep en un pod de Kubernetes?
Mantiene al pod sirviendo unos segundos después de empezar su baja, antes de que SIGTERM llegue al proceso. Compensa el tiempo que tardan kube-proxy, los ingress y los balanceadores en dejar de enviarle conexiones. Las guías citadas usan 10 y 15 s.
¿Para qué sirve un PodDisruptionBudget y cuándo se usa?
Limita cuántos pods de una app pueden estar caídos durante evicciones voluntarias como drains, upgrades de cluster o scale-downs del autoscaler. Se usa en apps replicadas que no pueden perder capacidad. No protege contra la caída involuntaria de un nodo.
¿Se puede hacer un deploy sin downtime con una sola réplica?
No. ByteBridge advierte que ninguna probe ni PDB logra zero-downtime con un único pod, y recomienda correr al menos dos réplicas.
Conclusión
Los 502 en cada rollout casi nunca tienen una sola causa, y por eso ningún setting aislado los arregla. Si hoy tu Deployment no tiene readiness, preStop ni PDB, empezá por ahí: son cambios chicos con efecto directo sobre los tres escenarios que describe la guía.
Después sumá maxUnavailable: 0, minReadySeconds y el loop de requests en tu pipeline de staging. La guía es de un solo equipo y sin métricas, así que el criterio de aceptación lo ponés vos: cero respuestas distintas de 200 en varios rollouts y en un drain, pasando por el mismo camino que usan tus usuarios.
Fuentes
- Kubernetes – Specifying a Disruption Budget for your Application (documentación oficial)
- Kubernetes – Pod Lifecycle (documentación oficial)
- ByteBridge Talent – Zero-Downtime Kubernetes Deploys: Probes, Rolling Updates, and PodDisruptionBudgets (14/10/2026)
- OneUptime – How to Implement Rolling Updates with Zero Downtime (25/01/2026)