Así se despliega una app Django en producción en 2026
En pocas palabras: El esquema usa dos VPS de netcup: una app box (6 vCPU, 8 GB) corre Django, WebSockets, Celery y Postgres con deploys en carpetas por release y symlink atómico; la monitoring box (4 vCPU, 8 GB) corre Prometheus, Grafana y pull backups diarios a las 03:00 UTC con claves SSH de solo lectura y cifrado con age.
El 18 de octubre de 2026, un desarrollador actualizó el servidor de ExtraTime, su sitio de quizzes de fútbol, de Ubuntu 24.04 a 26.04. El upgrade tardó 20 minutos. El sitio volvió cinco horas después, por un loop de reinicios con exit code 126 que terminó destapando todo el esquema de deploys, backups y monitoreo detrás de la app.
Desplegar una aplicación Django en producción es el proceso de llevar el código, la base de datos y los procesos en segundo plano de un proyecto desde desarrollo hacia servidores reales que atienden tráfico real. Incluye migraciones, manejo de dependencias, reinicio de procesos sin tiempo muerto y backups verificables. En el caso de ExtraTime, esa tarea se reparte entre dos VPS de netcup descriptos en el relato original: uno corre la app, el otro vigila y respalda (dos servidores chicos, no uno grande: esa decisión aparece una y otra vez a lo largo del caso, y vale la pena mirarla con lupa).
En este artículo:
- En 30 segundos
- ¿Qué arquitectura usa esta app Django de dos servidores?
- ¿Cuándo conviene separar la app en dos servidores en vez de usar uno solo?
- ¿Cómo desplegar una aplicación Django en producción sin downtime con carpetas de release?
- ¿Cómo proteger los backups para que no se puedan borrar desde el servidor atacado?
- ¿Qué causó las cinco horas de caída tras el upgrade de Ubuntu?
- ¿Qué aprendizajes deja este caso para quienes operan servidores propios?
- Errores comunes al desplegar y monitorear una app Django en dos servidores
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El 18 de octubre un upgrade de Ubuntu 24.04 a 26.04 dejó caído el servidor de ExtraTime durante 5 horas, por un reemplazo del intérprete Python en los virtualenvs.
- La app box tiene 6 vCPU y 8 GB de RAM, con CPU promedio de 6.6% en 30 días, pero la memoria disponible bajó a 0.63 GB el 27 de octubre.
- Cada deploy crea una carpeta nueva en releases/<sha> y cambia el symlink current de forma atómica, manteniendo las últimas 5 versiones.
- Los backups se “pullean” desde la monitoring box con llaves SSH de solo lectura (rrsync -ro), una por directorio, nunca se empujan desde el servidor que los genera.
- HealthReporter, armado con Claude Code, cruza cada reporte semanal contra el anterior para confirmar si un fix bajó realmente la métrica.
¿Qué arquitectura usa esta app Django de dos servidores?
ExtraTime separa la carga en dos VPS de netcup: uno corre la aplicación, el otro vigila y guarda las copias. La app box tiene 6 vCPU y 8 GB de RAM con Ubuntu 26.04, y ejecuta la API Django, los WebSockets, Celery, PostgreSQL 18 y Redis. La monitoring box, con 4 vCPU y 8 GB sobre Ubuntu 24.04, corre Prometheus, Grafana, Alertmanager, n8n, HealthReporter y el proceso de backups.
El frontend en Next.js vive en Vercel (Frankfurt), con Cloudflare cacheando el HTML. Los dos servidores hablan entre sí por WireGuard. Grafana no tiene URL pública (nada, cero exposición): para verla hay que abrir un túnel SSH. Hasta este mes la app box también corría un mail server propio, reemplazado por uno gestionado.
| Servidor | Specs | Disco usado | OS | Qué corre |
|---|---|---|---|---|
| App box | 6 vCPU, 8 GB RAM | 28 GB de 251 GB | Ubuntu 26.04 | API, WebSockets, Celery, Postgres, Redis |
| Monitoring box | 4 vCPU, 8 GB RAM | 41 GB de 251 GB | Ubuntu 24.04 | Prometheus, Grafana, Alertmanager, n8n, HealthReporter, backups |
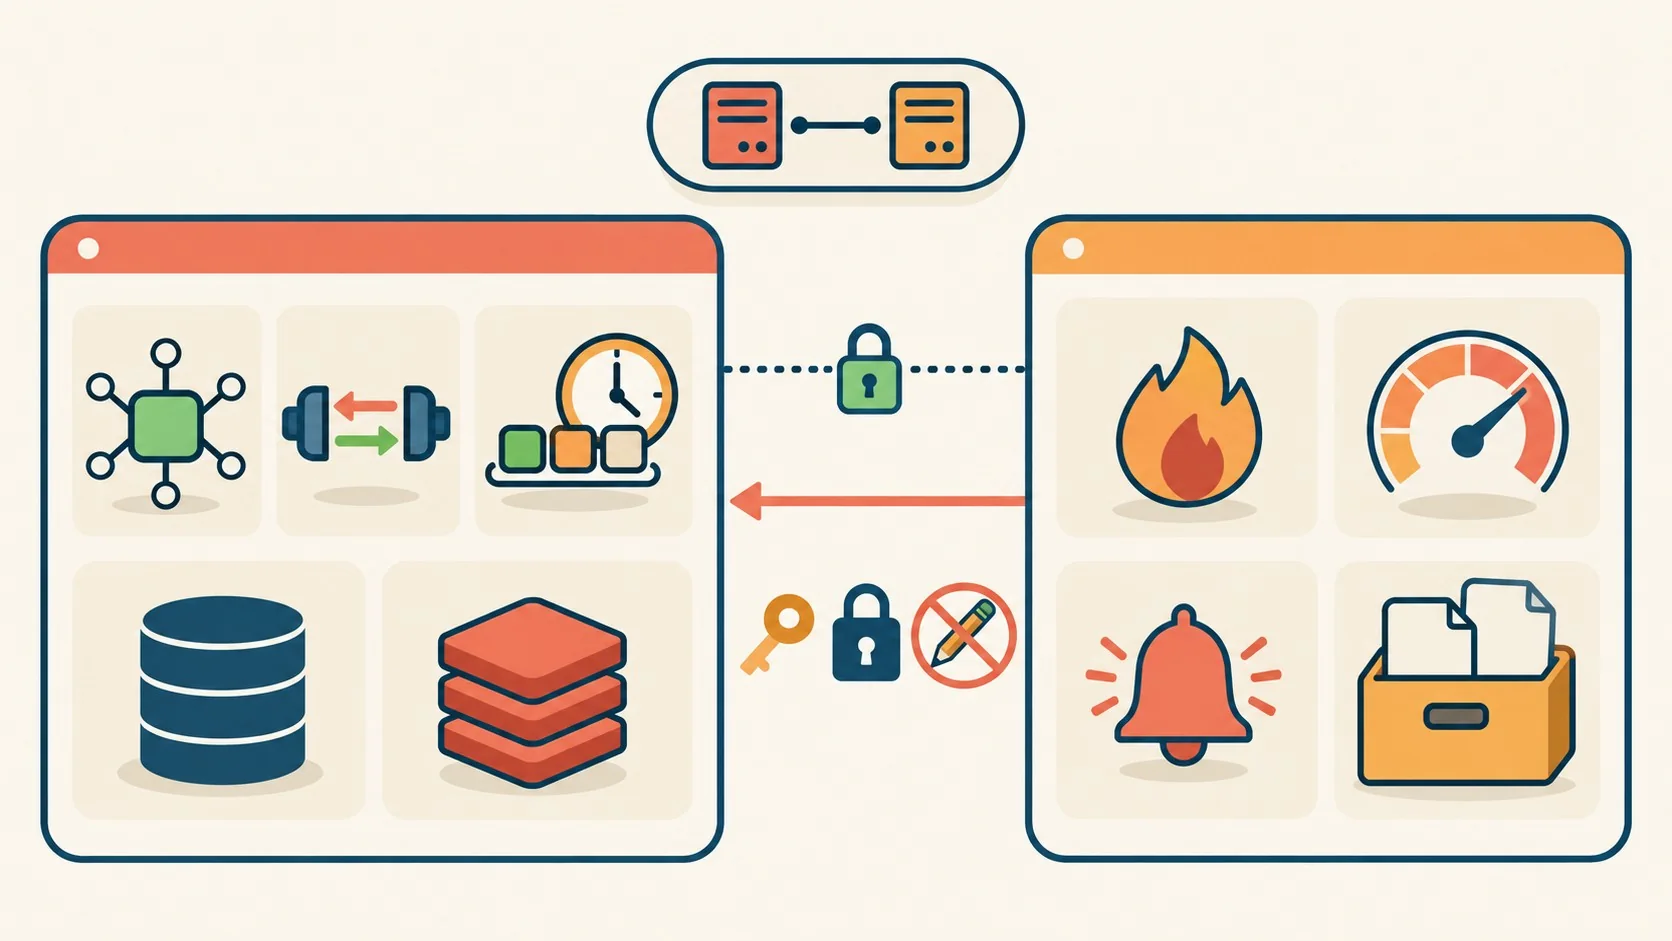
En pm2, ocho procesos Python conviven en la app box: dos gunicorn (~170 MB cada uno), dos Daphne para WebSockets (~310 MB), tres workers de Celery (~195 MB) y un Celery Beat (~200 MB). Postgres guarda 2.6 GB de datos. Redis usa apenas 16 MB de un límite de 512 MB. nginx hace de puerta de entrada, y un bot de Discord más tres exporters de Prometheus corren en Docker. Sobre eso hablamos en los errores típicos al pasar a producción.
¿Cuánto tráfico mueve todo esto? Entre 61.574 y 142.410 requests diarios según los logs de nginx de las últimas dos semanas, con un tiempo de respuesta mediano de 37 ms sobre 127.304 requests el día de la última medición. El CPU promedió 6.6% en 30 días de Prometheus. La memoria disponible, en cambio, llegó a bajar a 0.63 GB el 27 de octubre, con 100 GB de tráfico saliente en el mismo período.
¿Cuándo conviene separar la app en dos servidores en vez de usar uno solo?
Los números de ExtraTime dejan ver un criterio concreto para decidir esto, más allá del gusto personal por tener “una caja de respaldo”:
- Si tu backup es lo único que te separa de perder la base, no lo dejes en la misma máquina que puede comprometerse. Con 2.6 GB de Postgres y sin equipo de guardia, una segunda VPS barata que solo pullea y cifra dumps cuesta menos que reconstruir esos datos a mano.
- Si tu stack en producción corre con un solo operador (vos), automatizar el pull de solo lectura compensa la falta de alguien revisando logs en tiempo real. La llave `rrsync -ro` hace ese trabajo sin que nadie tenga que acordarse de copiar nada a mano.
- Si tus procesos pesan más en RAM que en CPU —como pasa aquí, con ocho procesos Python, Postgres y Redis residentes todo el tiempo—, separar el monitoreo en otra máquina libera memoria real para la app, no solo ciclos de CPU que de todos modos están casi idle.
- Si Grafana, n8n o cualquier panel de administración no necesitan estar expuestos a internet, moverlos a una segunda caja sin IP pública (como hace la monitoring box) reduce superficie de ataque sin tocar la app en producción.
Si ninguno de estos cuatro puntos aplica a tu caso —tráfico bajo, sin datos críticos, un solo entorno de prueba—, una sola VPS con backups automáticos a un storage externo (sin necesidad de una segunda máquina completa) puede ser suficiente.
¿Cómo desplegar una aplicación Django en producción sin downtime con carpetas de release?
Desplegar una aplicación Django en producción sin tiempo muerto se logra creando una carpeta nueva por cada versión y cambiando un symlink de forma atómica, en vez de sobrescribir el código en el lugar. Antes, cada deploy era un git reset --hard directo, lo que dejaba procesos importando módulos nuevos mientras el resto del código seguía viejo (spoiler: eso rompía cosas).
La estructura actual queda así:
- repo/: el repositorio git, del que cada release es un worktree.
- releases/<sha>/: una carpeta por deploy, se guardan las últimas 5.
- shared/: .env, media, staticfiles y logs, enlazados por symlink en cada release.
- venvs/<hash>/: un venv por cada contenido distinto de requirements.txt.
- current: symlink que apunta a releases/<sha> vigente.
Cada deploy sigue el mismo orden: dumpea la base, crea el worktree y enlaza los archivos compartidos, construye un venv solo si cambió requirements.txt, corre migraciones y collectstatic desde la release nueva mientras la vieja sigue atendiendo, cambia current con ln -sfn y mv -T (atómico), reinicia gunicorns y Daphnes de uno en uno para que siempre haya al menos uno activo, y corre un smoke test real que revierte el symlink si algo devuelve un 500.
Dos lecciones salieron caras. pm2 nunca relee el script ni el cwd de una app al reiniciarla, así que cada proceso arranca con un wrapper que resuelve la release actual al momento de iniciar. Y los procesos tienen que correr desde la ruta real, no a través del symlink, porque si no Python importa los archivos de la próxima release en el instante en que current cambia. Ya lo cubrimos antes en cómo pueden robarte los secretos de CI/CD.
Todavía no es perfecto. El último deploy generó 775 errores 502 de WebSocket en un minuto, sobre los sockets de notificaciones y logros. El frontend reconecta solo, pero sigue en la lista de pendientes. Un watchdog por cron prueba cada gunicorn cada minuto; después de tres fallos guarda stack traces con py-spy, las queries más lentas de Postgres y el slow log de Redis, reinicia solo esa instancia y avisa por Discord.
¿Cómo proteger los backups para que no se puedan borrar desde el servidor atacado?
Los backups se protegen pulleándolos desde un segundo servidor en vez de dejar que el servidor protegido los empuje. Postgres se dumpea cada noche a las 02:00 UTC y antes de cada deploy. A las 03:00, la monitoring box va y los trae. La app box no tiene ninguna credencial para escribir en ningún lugar donde se guarden backups, así que si alguien toma control de esa máquina, no puede borrarlos.
La monitoring box tiene dos llaves SSH en la app box, una por directorio, cada una encadenada en authorized_keys con algo así: command="rrsync -ro /var/backups/extratime/daily",restrict,from="<IP WireGuard>". Cada llave puede leer solo su carpeta correspondiente, desde una sola dirección, y nada más. El script de pull tampoco confía en los nombres de archivo que vienen de la app box para decidir qué conservar, así que un archivo plantado no puede empujar un backup real fuera de la ventana de retención.
Cada dump se cifra con age hacia una clave pública; la clave privada no vive en ningún servidor. Hoy la monitoring box guarda 4.3 GB de dumps, con retención de 14 diarios, 8 semanales y 6 mensuales, más 1.9 GB de media.
¿Qué causó las cinco horas de caída tras el upgrade de Ubuntu?
La caída de cinco horas la causó un loop de reinicios con exit code 126, disparado porque Ubuntu 26.04 trajo Python 3.14 y reemplazó el intérprete que usaban los virtualenvs viejos. El upgrade corrió de 12:03 a 12:25, con reboot incluido. Desde ese momento, cada proceso Python moría apenas arrancaba, y pm2 lo reiniciaba al instante. Te puede servir nuestra cobertura de armar un pipeline CI/CD seguro.
¿Cuántas veces pasó eso? Alrededor de 1.9 millones de veces entre las 12:00 y las 17:14, cuando todo volvió. La distribución por hora:
| Hora | Reinicios (exit 126) |
|---|---|
| 12:00 | 259.190 |
| 13:00 | 357.503 |
| 14:00 | 370.953 |
| 15:00 | 415.395 |
| 16:00 | 416.869 |
| 17:00 | 89.900 |
Ejemplo hipotético: para entender por qué una alerta basada solo en CPU no sirve acá, imaginemos un sitio distinto, un foro chico con un único proceso Gunicorn. Si ese proceso reinicia tres veces en una hora durante un deploy normal, no pasa nada raro. Pero si la alerta de Prometheus del foro está configurada para avisar solo cuando el CPU supera el 80%, un loop como el de ExtraTime —donde cada arranque fallido consume CPU durante una fracción de segundo antes de morir, sin llegar nunca a servir una sola request— puede sostener ese 80% durante horas sin que nadie se entere, porque la alerta mira el síntoma (CPU alto) y no la causa (reinicios en bucle). La métrica que sí lo agarraría a tiempo es comparar la cantidad de restarts por hora contra la cantidad de deploys hechos ese día: si no hiciste un deploy y el contador de restarts se dispara igual, ahí está el problema.
nginx registró 7.604 errores 502 ese día. Prometheus mostró el CPU en 60%, todo consumido en reiniciar procesos una y otra vez. Al principio, esa cifra se leyó como el día de mayor carga del mes. Era, en realidad, el día en que el sitio estaba caído. Un loop de reinicios se disfraza de tráfico alto si no mirás con qué frecuencia se están reiniciando los procesos.
¿Qué aprendizajes deja este caso para quienes operan servidores propios?
El aprendizaje central es que hay que dimensionar y alertar por memoria y por frecuencia de reinicios, no solo por CPU. En este caso puntual, el CPU estuvo prácticamente idle durante 30 días (6.6% de promedio) mientras la memoria rozó los 0.63 GB disponibles, el verdadero cuello de botella estaba ahí y nadie lo estaba mirando con la misma atención.
Cinco conclusiones concretas quedan del incidente:
- Snapshot antes de cualquier upgrade de OS, incluso en un proyecto personal sin mucho tráfico.
- Alertar sobre procesos que reinician mucho más seguido de lo que deployás, no solo sobre picos de CPU.
- Las carpetas de release con symlink atómico salen baratas y terminan con una clase entera de bugs de deploy a medio camino.
- Pullear los backups con una llave de solo lectura desde otro servidor, en vez de confiar en que el servidor atacado los empuje.
- Dimensionar el VPS por memoria, no por CPU: subís el disco, probás en local, funciona bárbaro, lo mandás a producción y de golpe la memoria se agota porque nadie midió el pico real de tu carga de trabajo.
Errores comunes al desplegar y monitorear una app Django en dos servidores
- Hacer un upgrade mayor de OS sin snapshot previo. Si algo sale mal, no hay forma rápida de volver atrás. Un snapshot antes de tocar la versión del sistema operativo cuesta minutos y evita horas de downtime.
- Monitorear solo CPU y memoria, sin mirar la tasa de reinicios de procesos. Un loop de crashes puede generar picos de CPU que parecen tráfico alto cuando en realidad es el sitio cayéndose en bucle.
- Dejar que el mismo servidor que genera los backups tenga permiso para borrarlos o sobrescribirlos en destino. Si ese servidor se compromete, el atacante también se lleva las copias. La llave de pull debe ser de solo lectura y vivir en otra máquina.
- Confiar en que pm2 (o cualquier process manager) relee el script o el cwd al reiniciar un proceso. No lo hace. Si tu deploy usa carpetas de release, necesitás un wrapper que resuelva la ruta vigente en cada arranque.
Preguntas Frecuentes
¿Qué causó la caída de 5 horas en el servidor de ExtraTime?
Un upgrade de Ubuntu 24.04 a 26.04 el 18 de octubre reemplazó el Python que usaban los virtualenvs por Python 3.14, lo que generó un loop de reinicios con exit code 126. El sitio estuvo caído desde las 12:25 hasta las 17:14, con cerca de 1.9 millones de reinicios acumulados. Complementá con diseñar una arquitectura AWS de producción.
¿Cómo se evita que los backups se puedan borrar desde el servidor atacado?
Se evita pulleando los dumps desde un segundo servidor con llaves SSH restringidas (rrsync -ro), una por directorio, que solo pueden leer su carpeta correspondiente. El servidor principal no guarda ninguna credencial para escribir en el destino de los backups, así que no puede borrarlos aunque se vea comprometido.
¿Qué es un deploy atómico con symlinks en Django?
Es un esquema donde cada versión del código vive en su propia carpeta (releases/<sha>) y un symlink llamado current apunta a la versión activa. El cambio de versión se hace moviendo ese symlink con ln -sfn y mv -T, operación atómica que evita que un proceso quede importando archivos mezclados de dos releases distintas.
¿Por qué hay que dimensionar un VPS por memoria y no por CPU?
Porque el CPU puede estar casi idle (6.6% de promedio en 30 días en este caso) mientras la memoria disponible llega a niveles críticos, como los 0.63 GB registrados un día puntual. Si solo alertás sobre CPU, un problema de memoria puede pasar inadvertido hasta que la app empieza a fallar.
¿Qué es HealthReporter?
HealthReporter es un servicio FastAPI con SQLite y frontend en Next.js que genera un reporte semanal del estado del servidor, usando Claude Code para convertir queries de Prometheus, logs y capturas del watchdog en hallazgos con causas probables. Cada reporte nuevo revisa los hallazgos del anterior y confirma, con métricas, si el fix aplicado realmente movió la aguja.
Conclusión
El caso de ExtraTime deja un punto claro para cualquiera que opere su propio servidor: el riesgo real casi nunca está donde uno mira primero. Acá el CPU estaba tranquilo todo el mes y la memoria fue la que se vino abajo, y el upgrade de OS que debía ser rutina terminó en cinco horas de downtime por un detalle tan específico como el intérprete Python de los virtualenvs.
Si estás por desplegar una aplicación Django en producción con un esquema similar, la lista de chequeo es concreta: snapshot antes de tocar el sistema operativo, carpetas de release con switch atómico, backups pulleados con llave de solo lectura desde otra máquina, y alertas por frecuencia de reinicios además de CPU y memoria. Ninguna de estas prácticas es exótica. La diferencia la hace aplicarlas antes del incidente, no después.