Event-driven en DevOps: el error que nadie ve
Un sistema procesaba millones de eventos con 30 segundos de latencia por evento. Más máquinas no ayudaron. La causa y la solución real.

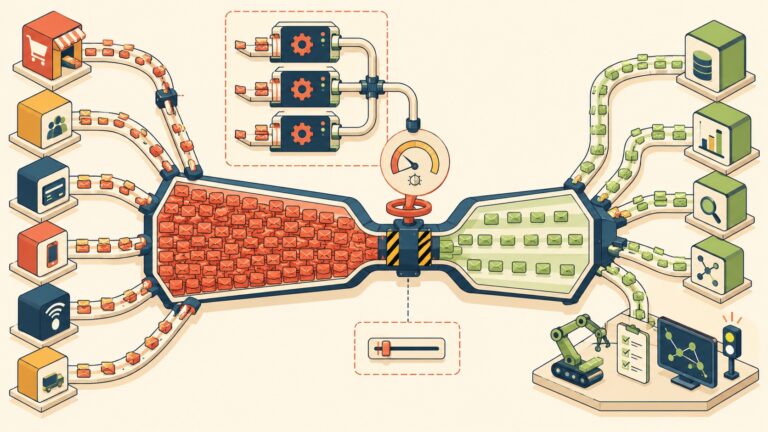
Un sistema procesaba millones de eventos con 30 segundos de latencia por evento. Más máquinas no ayudaron. La causa y la solución real.
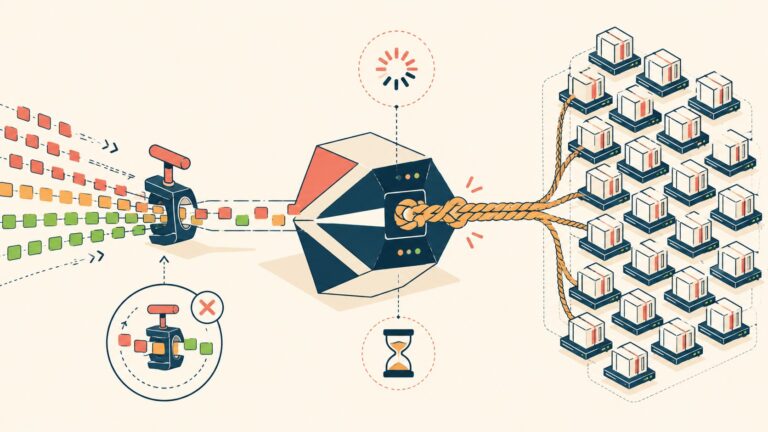
El equipo de Veltrix intentó resolver un stall de servidor bajando el límite de concurrencia en el balanceador. El resultado fue peor. Así lo resolvieron.
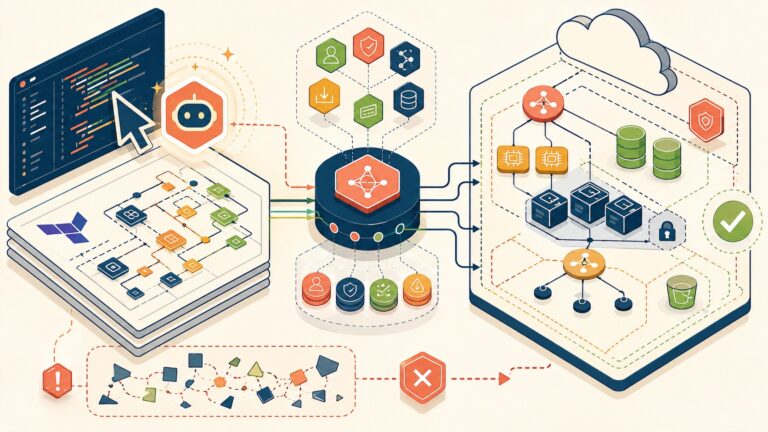
Cómo usar Terraform con IA de verdad: Cursor en Agent Mode + MCP Server de HashiCorp para generar infraestructura AWS que pasa el apply sin romperse.
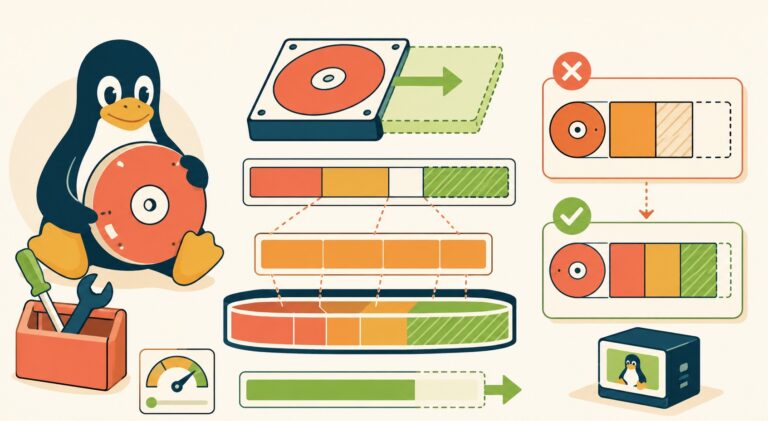
Expandir almacenamiento LVM en Ubuntu sin bajar el servidor es posible en cinco pasos. Estos son los errores que hacen que el espacio no aparezca.
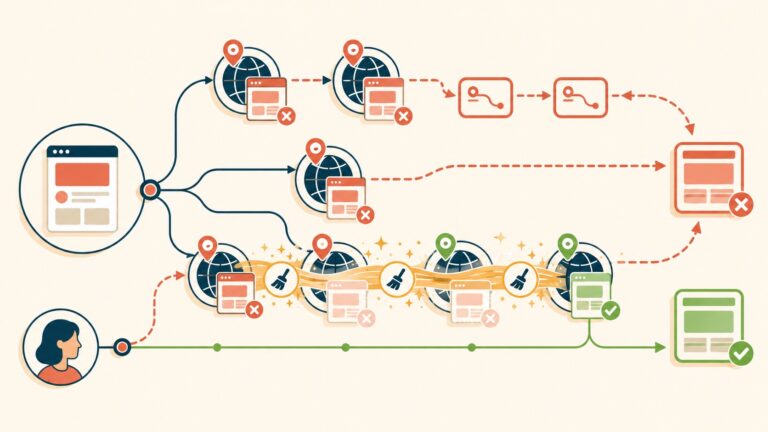
Cómo invalidar caché en un CDN correctamente: diferencia entre purga hard y soft, configuración de TTL y solución a redirects que persisten después de limpiar.
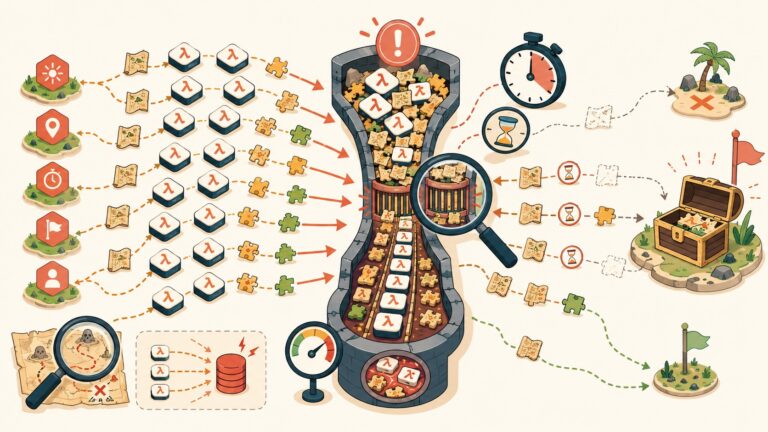
Un motor serverless con latencias de 10 segundos en producción: diagnóstico, errores cometidos y solución arquitectónica real.
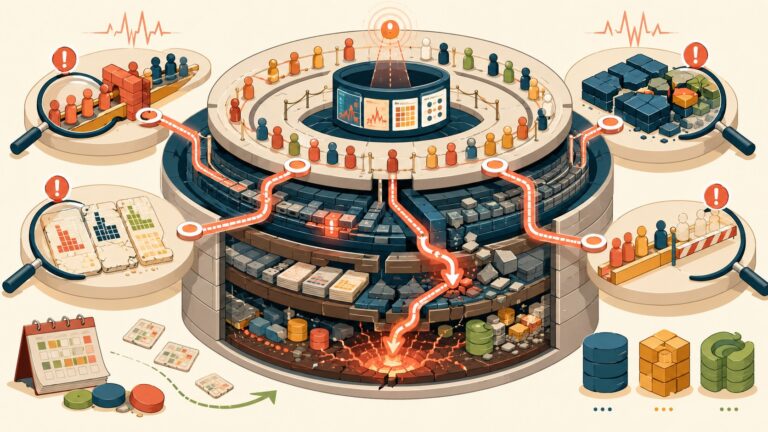
Cómo trazar incidentes de producción a su causa raíz usando wait states, fragmentación de índices y contención de locks en SQL Server, PostgreSQL y MySQL.
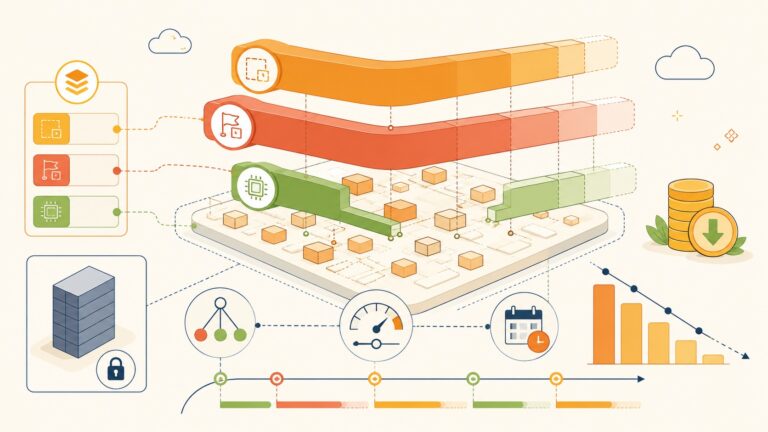
Cómo estructurar una AWS Savings Plan estrategia en capas: qué tipo comprar primero, cómo calcular el commitment y cuándo renovar sin perder descuentos.
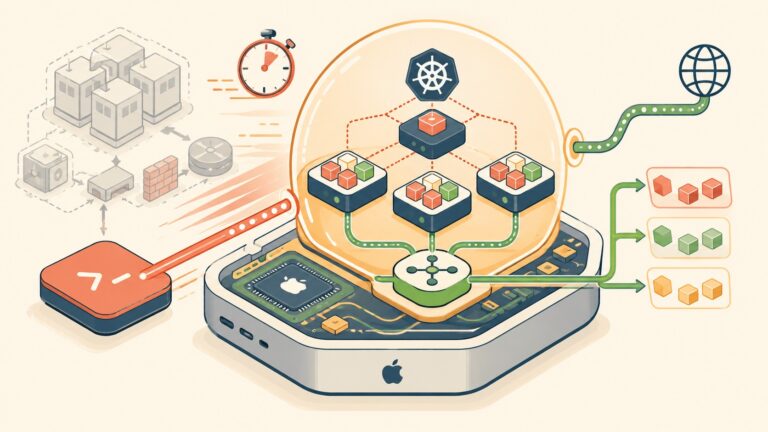
OrbStack levanta un cluster Kubernetes 1.33.x en Mac en menos de 30 segundos, con LoadBalancer nativo y DNS wildcard sin MetalLB ni configuración adicional.
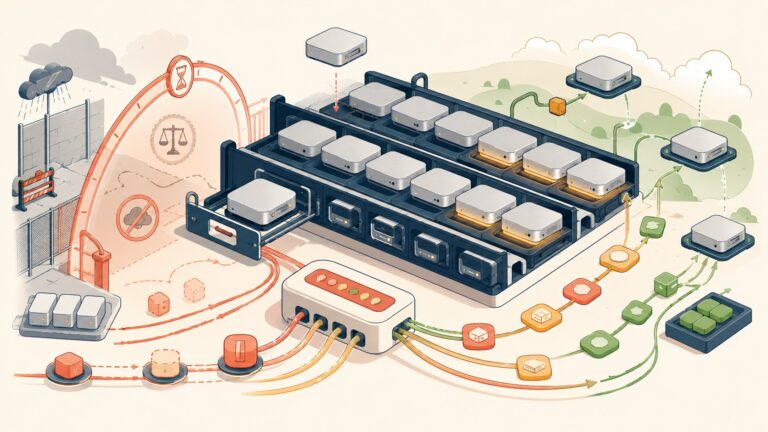
Configurar workers macOS en CI/CD es difícil por el EULA de Apple y el mínimo de 24h en AWS. Esta guía compara opciones reales con costos y arquitectura práctica.
End of content
End of content