Exit code Docker: leé el número antes de reiniciar
En pocas palabras: Antes de reiniciar un contenedor, leé el exit code con docker inspect: 0 es salida limpia, 1 error de la aplicación, 127 comando no encontrado, 137 SIGKILL y 143 SIGTERM. Si es mayor a 128, restás 128 y obtenés la señal. Es una pista, no un diagnóstico.
El exit code docker es el número con el que termina el proceso principal de un contenedor, y aparece en docker ps -a como Exited (N). Leelo con docker inspect antes de reiniciar: 137 es SIGKILL, 127 comando no encontrado, 143 SIGTERM y 0 salida limpia.
Un exit code es el estado de salida que un proceso le devuelve al sistema cuando termina, y Docker lo guarda en State.ExitCode del contenedor. Sirve para distinguir un cierre limpio (0), un error de la aplicación (1), un fallo de Docker (125) o una señal del sistema (por encima de 128). Es una pista sobre qué pasó, no un diagnóstico, y conviene leerla antes de tocar el contenedor.
En este artículo:
- En 30 segundos
- ¿Cómo ver el exit code Docker de un contenedor que quedó en Exited?
- ¿Qué significan los exit codes 0, 1, 2, 125, 126, 127 y 255 en Docker?
- ¿Exit 137, 139 y 143 en Docker significan que el contenedor se cayó por un error?
- ¿Cómo encontrar el primer error en los logs de un contenedor que se cayó?
- ¿Cuándo conviene reiniciar el contenedor y cuándo no?
- Errores comunes al interpretar un exit code
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El comando
docker inspectte da ExitCode, OOMKilled y State.Error, que son tres datos distintos y no se mezclan. - Por encima de 128 suele ser una señal: restás 128 y tenés el número (137 es SIGKILL, 139 es SIGSEGV, 143 es SIGTERM).
- Los códigos 125, 126 y 127 son problemas de arranque, y un reinicio no los arregla.
- El 137 solo no prueba falta de memoria, y el 143 no es un crash.
La base de esta nota es una guía publicada en dev.to el 11 de octubre de 2026 por el equipo de itops, que desarrolla OpsMate (una terminal SSH con asistente de IA). La guía es técnica y de solo lectura. Acá la ordeno por decisiones: qué mirar, qué concluir y qué no.
¿Cómo ver el exit code Docker de un contenedor que quedó en Exited?
Corré docker ps -a con --format para ver nombre, estado e imagen, y después docker inspect con ExitCode, OOMKilled y State.Error. Son tres datos separados: el código de salida, si el kernel mató el proceso por memoria y el error de Docker al intentar arrancarlo. Los comandos son de solo lectura, pero usalos únicamente en servidores donde tengas autorización.
docker ps -a --format 'table {{.Names}}\t{{.Status}}\t{{.Image}}'
docker inspect --format '{{.State.ExitCode}} {{.State.OOMKilled}} {{.State.Error}}' TU_CONTENEDOR
Reemplazá TU_CONTENEDOR por el nombre o ID real. Con Compose, docker compose ps -a incluye los detenidos, y el nombre suele ser <proyecto>-<servicio>-1.
- Exited (1) 8 seconds ago: una salida única con código 1.
- Restarting (1) 3 seconds ago: una política de reinicio en bucle. El número es el de la última salida.
- Created: el contenedor nunca corrió. Según la guía, suele ser un problema del comando de ejecución o de la imagen.
State.Error se completa cuando Docker no pudo arrancar el proceso. En la mayoría de los crashes de aplicación viene vacío. Cubrimos ese tema en detalle en cómo depurar contenedores matados por falta de memoria.
Ponele que CI marca el deploy en verde, abrís el dashboard, el servicio no responde, entrás por SSH, corrés docker ps -a, ves Exited (127) y tu primer impulso es un docker restart, que va a fallar igual porque el comando nunca existió en esa imagen. Para evitarlo, mirá los tiempos:
docker inspect --format 'started={{.State.StartedAt}} finished={{.State.FinishedAt}} restarts={{.RestartCount}} policy={{.HostConfig.RestartPolicy.Name}}' TU_CONTENEDORUnos pocos segundos entre started y finished es el patrón de “se cae justo después del deploy”. Los timestamps están en UTC (terminan en Z), así que convertilos antes de compararlos con logs en hora local.
¿Qué significan los exit codes 0, 1, 2, 125, 126, 127 y 255 en Docker?
El 0 es salida correcta, el 1 es error genérico de la aplicación, el 2 es sintaxis o uso incorrecto, el 125 es una falla de Docker, el 126 es un comando que existe pero no se puede ejecutar, el 127 es comando no encontrado y el 255 tiene tres orígenes posibles. La tabla resume lo que dice la guía, incluyendo las señales que se explican más abajo.
| Código | Significado habitual | Lo que no prueba |
|---|---|---|
| 0 | El proceso principal terminó bien | Que el servicio esté sano: solo terminó limpio |
| 1 | Error genérico de la aplicación | Cuál fue el error: hay que leer el log |
| 2 | Sintaxis, uso incorrecto o error definido por la app | Nada específico de Docker |
| 125 | Docker no pudo ejecutar el contenedor | Un bug de la aplicación |
| 126 | Comando encontrado pero no ejecutable | Que falte el binario |
| 127 | Comando no encontrado | Un crash posterior al arranque |
| 132 | Instrucción ilegal, SIGILL (128 + 4) | Que un reinicio o más memoria lo arreglen |
| 137 | SIGKILL (128 + 9) | Falta de memoria, si OOMKilled es false |
| 139 | Segmentation fault, SIGSEGV (128 + 11) | La causa, sin logs ni dmesg |
| 143 | SIGTERM (128 + 15) | Un fallo: es una parada normal |
| 255 | exit(-1), ssh fallido o proceso perdido por Docker | Un veredicto de la aplicación |
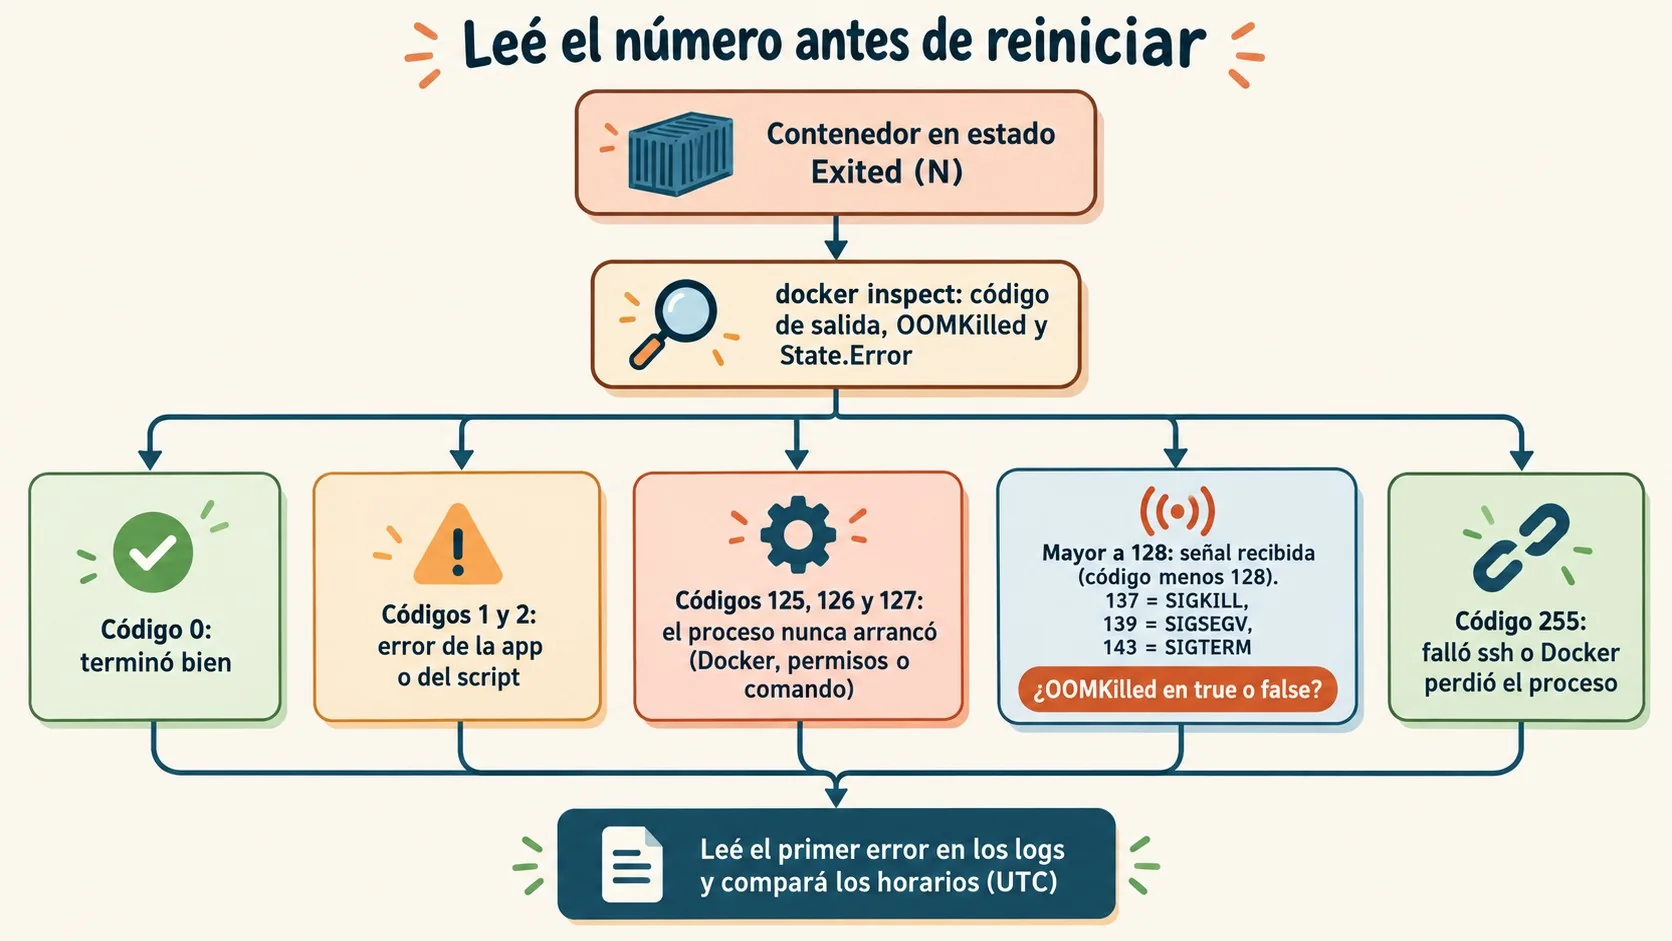
La columna del medio es de la guía de itops. La de la derecha es mi lectura de las advertencias que la propia guía hace código por código.
¿Qué significa exit code 0 en Docker?
Significa que el proceso principal terminó sin errores. Es lo esperable en una migración o un backup. Si un servicio web sale con 0, lo más probable es que se haya puesto en segundo plano o que haya corrido una tarea de una sola vez. Revisá el entrypoint y el cmd:
docker inspect --format 'entrypoint={{json .Config.Entrypoint}} cmd={{json .Config.Cmd}}' TU_CONTENEDOR¿Por qué un entrypoint da exit 2 o 127 por CRLF?
Porque un script con finales de línea de Windows (CRLF) rompe al intérprete de shell. La guía cuenta que suele aparecer syntax error: unexpected end of file en bash o Syntax error: end of file unexpected en dash, con exit 2. Fuera de un if o un case, el mismo problema puede dar not found y exit 127. Cualquiera que haya editado un script en Windows y lo haya empaquetado en una imagen Linux se topó con esto (y suele perder una hora buscando la causa). Más contexto en el error de exit code 1 en Raspberry Pi.
bash -n entrypoint.sh # solo parsea
grep -c $'\r' entrypoint.sh # 0 = finales LF
sed -i 's/\r$//' entrypoint.sh # arreglo
# en .gitattributes: *.sh text eol=lf y después reconstruir la imagen
¿Qué significa exit 255 en un contenedor Docker?
Tiene tres orígenes. Uno es un programa que devolvió -1 (solo los 8 bits más bajos llegan al proceso padre, por eso se ve 255). Otro es un ssh que falló por conexión, autenticación o host key, algo habitual en jobs de backup o deploy que terminan en ssh. El tercero es Docker perdiendo el proceso tras un crash del host o del daemon.
En ese último caso, dockerd marca el contenedor como Exited (255) y es contabilidad de Docker, no veredicto de la app. Si finished coincide con el arranque del host (uptime -s) o con una línea “Starting up” de dockerd en journalctl -u docker.service, la pregunta es por qué se reinició la máquina.
¿Exit 137, 139 y 143 en Docker significan que el contenedor se cayó por un error?
No siempre. Por encima de 128 el código suele ser una señal (código menos 128), y kill -l 137 imprime KILL. De los tres, solo el 139 apunta a un fallo del proceso. El 137 y el 143 dependen de quién mandó la señal.
- 137 (SIGKILL): si OOMKilled es true, la pista es memoria. Si es false, puede ser un
docker kill, undocker stopque venció su timeout u otro proceso del host. La guía lo dice así: 137 solo no prueba OOM. Antes de subir límites, mirá el log del kernel, los límites de memoria ydocker events. - 139 (SIGSEGV): acceso inválido a memoria. Leé los logs alrededor de la salida y corré
sudo dmesg -T | grep -i segfault | tail -n 20. Fijate si hubo upgrades de dependencias nativas o del runtime, y contá solo las líneas del kernel cuyo horario coincida con finished. - 143 (SIGTERM): una parada normal. Averiguá quién la pidió: redeploy,
docker stop, recreate de Compose, apagado del host u orquestador, y si el reemplazo levantó.
Para el 143, la guía propone consultar los eventos del contenedor:
docker events --since 1h --until "$(date +%s)" --filter container=TU_CONTENEDOROjo con la retención: según la guía, Docker conserva solo los últimos 256 eventos. En un host con mucho movimiento, la evidencia de hace un rato puede no estar. Si tenés un VPS en donweb.com, estos comandos de kernel y journalctl los corrés igual por SSH con sudo.
El 132 merece aparte. Es SIGILL: la CPU recibió una instrucción que no puede ejecutar. Las causas que lista la guía son un binario que pide AVX, AVX2, AVX-512 o x86-64-v3 en un host que no los tiene, una VM con un modelo de CPU básico, emulación QEMU de otra arquitectura o un trap deliberado del programa (ud2, __builtin_trap()), que es un bug y no un desajuste de CPU. Una política de reinicio no lo arregla. Descartá el trap antes de comprar un servidor nuevo.
¿Cómo encontrar el primer error en los logs de un contenedor que se cayó?
Corré docker logs --since 30m --timestamps TU_CONTENEDOR 2>&1 | head -n 80 y leé el primer error posterior al deploy, no solo la última línea. El 2>&1 importa porque la mayoría de los errores salen por stderr. Un contenedor detenido conserva sus logs hasta que lo eliminás (con --rm se borran junto con él). Complementá con instalar SafeLine WAF con Docker.
docker logs --since 30m --timestamps TU_CONTENEDOR 2>&1 | grep -n -i -E 'error|fatal|panic|exception|denied|not found|refused' | head -n 20Los mensajes frecuentes son hipótesis hasta que las verificás:
- connection refused: una dependencia caída o una dirección equivocada. Dentro de un contenedor, localhost es el propio contenedor.
- permission denied: dueño de un mount o usuario de runtime.
- no such file or directory en un script que existe: a menudo CRLF en el shebang o un intérprete que falta.
- exec format error: arquitectura equivocada. Comparás
docker image inspect --format '{{.Os}}/{{.Architecture}}' TU_IMAGENconuname -m. - clave de entorno faltante: comparás los nombres de las variables con el último deploy bueno, sin imprimir los valores.
Redactá contraseñas, tokens, cadenas de conexión y datos de clientes antes de pegar logs en cualquier lado. La propia nota avisa que su asistente manda la salida reciente de la terminal a una IA en la nube, y esa advertencia sirve para cualquier herramienta similar.
¿Cuándo conviene reiniciar el contenedor y cuándo no?
No conviene reiniciar si el comando no existe (127), si Docker no pudo ejecutarlo (125), si la CPU no soporta una instrucción (132) o si falta una dependencia en la imagen. En esos casos el reinicio repite el mismo fallo. Reiniciar sí tiene sentido cuando el log muestra algo transitorio, como una dependencia que ya volvió.
La guía trae un ejemplo que ella misma marca como ilustrativo y no real. Tras pasar a una imagen base más liviana, docker ps -a muestra Restarting (127). El inspect devuelve 127 false con error vacío: el proceso arrancó y no fue memoria. Started y finished están separados por alrededor de un segundo. La primera línea del log dice /app/start.sh: 5: exec: gunicorn: not found.
Lectura: el entrypoint corre, pero la base nueva no trae el servidor de la app. Ni reiniciar ni dar más memoria ayudan. El siguiente paso es volver al tag anterior o reconstruir con la dependencia, y después verificar que el contenedor se mantenga arriba.
Una propuesta editorial para el equipo (no viene de la fuente ni la probamos): antes de reiniciar, anotá en el ticket cuatro datos. El ExitCode, el OOMKilled, la diferencia entre finished y started, y la primera línea de error con su hora. Si no podés completar las cuatro, todavía no tenés diagnóstico. ¿Y si el log dice otra cosa que el número? Gana el log. Relacionado: instalación de Docker Desktop en Windows.
Un detalle sobre la fuente: es de un proveedor de herramientas y menciona su producto al final. Según su descripción, OpsMate ejecuta solo las acciones de bajo riesgo, pide aprobación para las de riesgo medio y, si nadie responde en 30 minutos, las ejecuta igual. Tomalo con pinzas: es un diseño del fabricante y yo no lo evalué. La parte técnica de los comandos se sostiene sola, sin comprar nada.
Errores comunes al interpretar un exit code
- Declarar “se quedó sin memoria” con solo ver 137. Corrección: mirá OOMKilled, el log del kernel y
docker events. Con OOMKilled en false, el culpable puede ser undocker killo un stop con timeout. - Tratar el 143 como un crash. Corrección: es SIGTERM, una parada normal. La pregunta es quién la pidió y si el reemplazo levantó.
- Leer solo la última línea del log. Corrección: buscá el primer error después del deploy. Lo que viene después suele ser consecuencia.
- Comparar horarios sin convertir. Corrección: StartedAt y FinishedAt están en UTC. Convertilos antes de cruzarlos con dmesg o con logs locales, o vas a descartar la línea correcta del kernel.
Preguntas Frecuentes
¿Cómo ver el exit code de un contenedor Docker?
Con docker inspect --format '{{.State.ExitCode}} {{.State.OOMKilled}} {{.State.Error}}' TU_CONTENEDOR. También aparece entre paréntesis en la columna de estado de docker ps -a, por ejemplo Exited (137).
¿Qué significa Exited (137) en Docker?
Significa que el proceso recibió SIGKILL (128 + 9). Si OOMKilled es true, apunta a memoria; si es false, puede ser un docker kill, un stop con timeout vencido u otro proceso del host. El 137 solo no prueba que faltó memoria.
¿Por qué mi contenedor Docker sale con código 127?
Porque el comando no se encontró: el programa nunca arrancó. Confirmá que el binario exista en esa imagen y esté en el PATH. Las bases livianas y los errores de tipeo en el command: de Compose son causas habituales.
¿Exit code 143 en Docker es un error?
No, es una parada normal por SIGTERM (128 + 15). Averiguá quién la pidió: un redeploy, un docker stop, un recreate de Compose, un apagado del host o un orquestador.
¿Cómo ver por qué se cayó un contenedor Docker después de un deploy?
Combiná tres cosas: el exit code, los tiempos de started y finished, y el primer error de docker logs --since 30m --timestamps TU_CONTENEDOR 2>&1. Si los logs te los llevaste con --rm, ya no hay de dónde leerlos.
Conclusión
El hábito que vale la pena instalar es corto: antes de un docker restart, leé el exit code docker, mirá OOMKilled y State.Error, compará started con finished y buscá el primer error del log. Con eso descartás en un minuto los casos donde reiniciar no sirve (125, 126, 127, 132). En los demás, sabés qué señal llegó y quién tiene que explicarla.
Los límites también cuentan. Los datos de esta nota vienen de una sola guía, de un proveedor de herramientas, y el ejemplo del gunicorn es ilustrativo, no un caso real. Aun así, la frase de cierre de la guía resume bien el criterio: un exit code es una pista, no un diagnóstico.