LogCarver: recuperá filas eliminadas en SQL Server sin CDC
En pocas palabras: LogCarver, herramienta open source bajo licencia MIT creada por caiderek, lee directamente fn_dblog —función no documentada de SQL Server— para reconstruir el historial de INSERT, UPDATE y DELETE de una tabla, generando SQL de Undo y Replay sin necesidad de CDC, Change Tracking o Auditoría activados previamente.
LogCarver es una herramienta de código abierto que lee directamente fn_dblog, la función no documentada de SQL Server, y reconstruye el historial completo de INSERT, UPDATE y DELETE de una tabla. El objetivo: recuperar filas eliminadas en SQL Server sin haber activado CDC, Change Tracking ni Auditoría antes del incidente, según describe su creador en la publicación original.
LogCarver es un ejecutable de línea de comandos (LogCarver.exe), de código abierto bajo licencia MIT, publicado en GitHub por el desarrollador identificado como caiderek. Se conecta a una instancia viva de SQL Server, decodifica el contenido de fn_dblog y arma, por tabla, el historial de cambios con los valores antes/después de cada UPDATE, además de generar SQL de Undo y Replay para revisar antes de ejecutar.
En este artículo:
- En 30 segundos
- ¿Cómo recuperar filas eliminadas en SQL Server sin backup ni CDC?
- ¿Por qué fn_dblog es la clave para recuperar datos sin CDC ni Auditoría?
- Cómo LogCarver reconstruye el historial de INSERT, UPDATE y DELETE
- El bug de las tablas Heap que hacía desaparecer eventos
- Por qué los índices adicionales rompían la detección de la tabla correcta
- Qué tipos de datos soporta LogCarver hasta el 2026-10-01 y qué limitaciones tiene
- ¿Qué pasa si fn_dblog ya no muestra los datos borrados?
- Dónde conseguir LogCarver y en qué versiones de SQL Server fue probado
- Errores comunes al intentar recuperar filas eliminadas en SQL Server
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Qué es: LogCarver lee
fn_dblogy reconstruye INSERT, UPDATE (antes/después) y DELETE sin CDC ni Auditoría previos. - El hallazgo clave: las tablas Heap usan el tag
LCX_HEAP, que el filtro original no reconocía, así que esos eventos desaparecían silenciosamente. - El segundo bug: cualquier índice extra rompía el matching por nombre; la solución fue consultar
sys.indexesen vez de adivinar patrones de texto. - Qué tipos decodifica hasta el 2026-10-01: int, bigint, date, datetime2, decimal/numeric, char/nchar, varchar/nvarchar, con money, smallint, bit y uniqueidentifier todavía pendientes.
- Costo: MIT, gratis, disponible en github.com/caiderek/LogCarver.
¿Cómo recuperar filas eliminadas en SQL Server sin backup ni CDC?
Se puede, siempre que la transacción que borró las filas siga visible en el transaction log activo. SQL Server graba cada INSERT, UPDATE y DELETE en su log por diseño, más allá de que el equipo de DBA haya configurado algo o no. El problema histórico era el acceso: nadie documentó de forma oficial cómo leer ese log con fn_dblog.
Ponele que borraste por error 4.000 filas de una tabla de pedidos un viernes a la tarde. Si nunca activaste Change Data Capture (CDC), Change Tracking o Auditoría, la mayoría de las herramientas de recuperación asumen que estás en el horno. Acá está el matiz: el log ya tiene esa data, el tema es tener con qué leerla.
¿Por qué fn_dblog es la clave para recuperar datos sin CDC ni Auditoría?
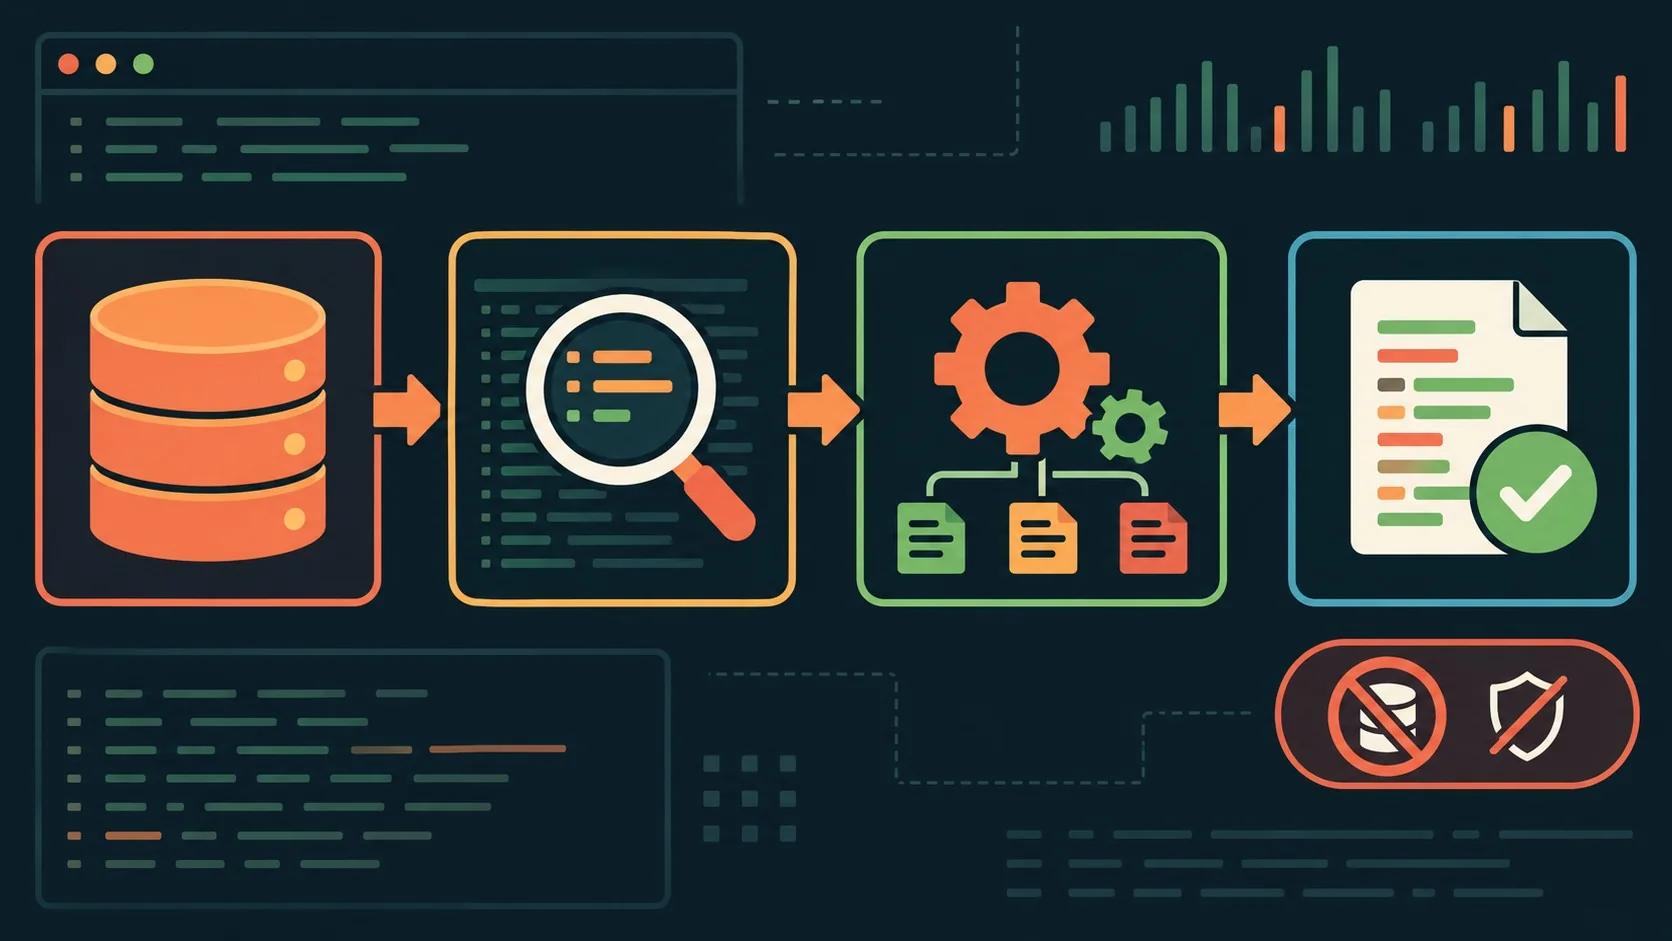
fn_dblog es la función que le permite a cualquiera con permisos suficientes leer el transaction log activo, fila por fila, tal como quedó grabado. El problema: Microsoft nunca publicó el layout de bytes de la imagen de cada fila, así que no hay documentación oficial de cómo interpretarlo. Relacionado: recuperar secretos expuestos con hex dump.
El autor de LogCarver tuvo que reconstruir ese formato corriendo experimentos reales contra una base de datos viva, byte por byte, según cuenta en su publicación. Nada de inferir desde la documentación, porque documentación casi no hay. CDC, dicho sea de paso, es la función nativa de SQL Server que sí registra cambios de forma estructurada en tablas espejo, pero hay que activarla antes del incidente. Si nunca la prendiste, fn_dblog queda como la única puerta de entrada.
Cómo LogCarver reconstruye el historial de INSERT, UPDATE y DELETE
LogCarver arma la línea de tiempo completa de una tabla a partir del log: qué se insertó, qué cambió (con el valor antes y el valor después) y qué se borró. Con eso genera dos tipos de SQL listo para revisar: Undo, que deshace cada evento, y Replay, que lo reproduce.
El punto fuerte acá es que ninguno de los dos se ejecuta solo. LogCarver solo imprime el SQL sugerido, nunca se conecta con intención de escritura. Eso sí: la cláusula WHERE del Undo y el Replay matchea contra todas las columnas observadas, no solo la primary key, así que si la fila cambió de nuevo después de que LogCarver la vio, el statement se convierte en un no-op seguro en vez de pisar datos nuevos.
La herramienta también soporta filtrar por ventana de tiempo (--from/--to), buscar el historial completo de una sola fila con --key, y reconstruir una foto exacta de cómo estaba la tabla en un momento puntual con --snapshot.
El bug de las tablas Heap que hacía desaparecer eventos
El bug hacía que LogCarver reportara cero eventos en cualquier tabla Heap, es decir, sin índice clustered, y eso incluye las tablas con PRIMARY KEY NONCLUSTERED. El mensaje de error, encima, sonaba razonable: decía que el VLF probablemente se había reciclado y los datos estaban perdidos. Cubrimos ese tema en detalle en la reescritura de SQLite en Rust.
Esa explicación era falsa. ¿Y cuál era la causa real? Un filtro incompleto. Las operaciones sobre tablas Heap quedan etiquetadas con LCX_HEAP en el campo Context, pero el filtro original solo reconocía LCX_CLUSTERED y LCX_MARK_AS_GHOST. Cada registro de una tabla Heap quedaba excluido desde el arranque, nada que ver con VLFs reciclados.
Acá viene lo interesante: el propio autor admite que si no hubiera vuelto a mirar la salida cruda de fn_dblog, se habría quedado con la explicación plausible y equivocada de su propia herramienta. La regla que aplicó de ahí en más fue simple, cada supuesto se verifica contra una instancia real de SQL Server, nunca se infiere.
Por qué los índices adicionales rompían la detección de la tabla correcta
Cualquier tabla con un índice extra, sea la primary key nonclustered de una Heap o un índice común agregado para performance, rompía la lógica de matching de tabla. El motivo: el filtro adivinaba el patrón de texto del AllocUnitName a partir del nombre de la tabla, y los registros internos de mantenimiento del índice usaban un patrón parecido, así que terminaban mezclados con los de la tabla real.
La solución fue dejar de adivinar. LogCarver ahora consulta sys.indexes para conocer la estructura real de almacenamiento de la tabla (index_id 0 es Heap, 1 es índice clustered) y arma el AllocUnitName exacto a partir de ese dato, matcheando de forma precisa en vez de aproximada. El mismo filtro faltante existía en la consulta que lee el esquema de columnas, así que una vez corregido, los índices extra dejaron de contaminar también el layout de columnas. Tema relacionado: arquitecturas híbridas y serverless en 2026.
Qué tipos de datos soporta LogCarver hasta el 2026-10-01 y qué limitaciones tiene
Según la publicación del autor, hasta el 2026-10-01 LogCarver decodifica int, bigint, date, datetime2, decimal/numeric, char/nchar y varchar/nvarchar. Quedan pendientes money, smallint, bit, uniqueidentifier y algún otro tipo fijo menos común.
Ojo con esto: el repositorio en GitHub describe un alcance más acotado al momento de escribir esto (2026-10-01), int, datetime2(3)/datetime2(4), char, nchar, varchar y nvarchar, y aclara que cualquier otro tipo (decimal/numeric/money, bigint/smallint/tinyint, bit, float/real, uniqueidentifier, entre otros) se rechaza de forma explícita con el mensaje “not shown – … is not implemented yet” en vez de arriesgarse a adivinar el valor. Si tu tabla tiene columnas financieras en decimal o money, convendría confirmar el soporte vigente en el repositorio antes de depender de esto.
Hay una limitación conocida y todavía sin resolver: TRUNCATE TABLE genera el mismo tipo de registro de log (LOP_HOBT_DDL) que un ALTER TABLE real, así que LogCarver lo trata como un cambio de esquema y oculta todos los eventos anteriores a ese punto, aunque un TRUNCATE nunca cambia el layout de columnas. El historial sigue ahí, decodificable, solo que la herramienta todavía no lo muestra.
¿Qué pasa si fn_dblog ya no muestra los datos borrados?
Si LogCarver reporta cero eventos para una tabla que cambiaste hace poco, no es necesariamente un bug: puede significar que SQL Server ya dejó de reportar esa historia, incluso corriendo SELECT * FROM fn_dblog(NULL, NULL) a mano. fn_dblog solo puede mostrar lo que está en los VLF activos del log, y apenas SQL Server marca un VLF como reutilizable, deja de reportar todo lo que había ahí.
Bajo el modelo de recuperación SIMPLE esto puede pasar en segundos después de un checkpoint, porque no hay un backup de log que lo retrase. Una base chica y de bajo tráfico puede reciclar todo su log, incluidos los INSERT originales, antes de que termines de investigar el incidente. El dato importante: “marcado como reutilizable” no es lo mismo que “sobrescrito físicamente”. Los bytes pueden seguir en el archivo .ldf aunque fn_dblog ya no te los muestre. Para ese escenario específico, el mismo autor ofrece LogCarverOffline, una versión paga que lee el .ldf directo y tiene una prueba gratuita de los primeros 10 eventos recuperados.
Dónde conseguir LogCarver y en qué versiones de SQL Server fue probado
LogCarver está disponible en github.com/caiderek/LogCarver bajo licencia MIT, con un ejecutable autocontenido que no requiere instalar .NET en la máquina destino. Después de corregir los dos bugs de Heap e índices, el autor corrió la misma batería de pruebas contra SQL Server 2016, 2019 y 2022 el mismo día, antes de llamar “validado” al fix.
El repositorio en GitHub amplía esa lista de versiones confirmadas a 2025, 2022, 2019 y 2016 SP2, y avisa (en vez de fallar en silencio) cuando detecta una versión todavía no validada. Para correrlo hace falta una cuenta con permisos de sysadmin o db_owner sobre la base, porque fn_dblog exige acceso elevado. Si administrás tu propia instancia de SQL Server en un VPS o servidor dedicado, como los que ofrece donweb.com, tener esta clase de herramienta a mano es una red de contención barata frente a un borrado accidental.
Errores comunes al intentar recuperar filas eliminadas en SQL Server
- Confundir “cero eventos” con “datos perdidos para siempre”: puede ser que el VLF ya se haya marcado reutilizable sin estar sobrescrito, un escenario distinto que requiere lectura offline del .ldf, no significa que la data ya no exista.
- Ejecutar el SQL de Undo o Replay sin revisarlo primero: LogCarver solo imprime sugerencias, la responsabilidad de validar contra una copia no productiva es de quien lo corre.
- Asumir que todos los tipos de columna están soportados: columnas en money, bit o uniqueidentifier pueden quedar sin decodificar según la versión del tool, y eso importa especialmente en tablas financieras.
- No considerar el efecto de un TRUNCATE previo: si la tabla tuvo un TRUNCATE en su historia, todo lo anterior queda oculto hoy por esta limitación conocida, aunque la data siga ahí.
Preguntas Frecuentes
¿Se pueden recuperar filas eliminadas en SQL Server si nunca activé CDC o Auditoría?
Sí, mientras la transacción siga visible en los VLF activos del transaction log. Herramientas como LogCarver leen fn_dblog directamente y reconstruyen el historial sin necesidad de haber configurado CDC, Change Tracking o Auditoría antes del incidente.
¿Qué es fn_dblog y por qué no está documentado oficialmente?
fn_dblog es una función de SQL Server que expone el contenido del transaction log activo. Microsoft nunca publicó el layout de bytes de la imagen de cada fila, así que su interpretación se reconstruyó de forma experimental, corriendo pruebas reales contra una base viva.
¿Cómo reconstruye LogCarver el historial de INSERT, UPDATE y DELETE de una tabla?
LogCarver decodifica los registros de fn_dblog y arma la línea de tiempo de cada tabla, mostrando valores antes y después en cada UPDATE. Con ese historial genera SQL de Undo y Replay para que el usuario los revise antes de ejecutarlos manualmente.
¿LogCarver funciona en tablas Heap sin índice clustered?
Sí, después de corregir un bug donde el filtro original no reconocía el tag LCX_HEAP en el campo Context y excluía todos los eventos de tablas sin índice clustered. El fix ahora consulta sys.indexes para identificar correctamente la estructura de la tabla.
¿LogCarver es gratis y de código abierto?
Sí, LogCarver tiene licencia MIT y está disponible gratis en GitHub. Existe una versión paga separada, LogCarverOffline, pensada para el caso en que fn_dblog ya no reporta los datos porque el VLF correspondiente fue marcado como reutilizable.
Conclusión
Lo que cambia acá no es que SQL Server guarde los cambios, eso ya lo hacía. Lo que cambia es que ahora hay una herramienta gratuita, MIT, que lee esa historia sin pedirte que hayas configurado nada antes del desastre. Para equipos chicos que nunca activaron CDC, eso es la diferencia entre un viernes arruinado y un viernes recuperable.
Si administrás SQL Server sin CDC ni Auditoría, probar LogCarver contra una copia de tu base, no la productiva, es el primer paso razonable antes de confiar en cualquier SQL de Undo. Y si fn_dblog te devuelve cero eventos, no asumas que la data desapareció: confirmá si el VLF fue reciclado antes de descartar la recuperación.