Filers: la API en Rust que procesa archivos 40x más rápido
En pocas palabras: Filers es una API open source en Rust con framework Axum, compartida por venturaproject el 27 de octubre de 2026, que procesa un xlsx de 1,1 millones de celdas en ~0,5 segundos de servidor, frente a ~20 segundos de un stack típico con PHP.
Filers es una API de código abierto para procesamiento de archivos con Rust que un desarrollador del proyecto venturaproject compartió en dev.to el 27 de octubre de 2026. Según el repositorio oficial en GitHub, un archivo xlsx de 1,1 millones de celdas se procesa en aproximadamente 0,5 segundos de tiempo de servidor, contra unos 20 segundos que tarda la misma tarea en un stack típico armado con PHP.
Filers es un servicio HTTP construido con Rust y el framework Axum, pensado para que una aplicación de negocio delegue el procesamiento pesado de archivos (planillas, PDFs, validaciones, conversiones) en una API dedicada en vez de ejecutarlo dentro del backend principal. El proyecto es de código abierto, incluye un panel de administración hecho en React y expone operaciones de parseo, transformación, comparación de filas y workflows batch sobre formatos xlsx, xls, ods y csv.
En este artículo:
- En 30 segundos
- ¿Qué problema de procesamiento de archivos busca resolver Filers?
- ¿Qué funcionalidades ofrece Filers?
- ¿Con qué tecnologías está construido Filers?
- ¿Dónde conseguir el código y probar Filers?
- ¿Qué está confirmado y qué no sobre Filers?
- Errores comunes al evaluar Filers
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un xlsx de 1,1M de celdas se procesa en ~0,5 s de tiempo de servidor, según el repositorio del proyecto, frente a ~20 s en un stack PHP equivalente.
- El backend usa Rust 2024, axum 0.7, tokio y calamine; el frontend admin usa React, Vite y TanStack.
- Cubre parse, profile, validate, transform, convert, diff y pipeline sobre xlsx/xls/ods/csv, más operaciones PDF (info, text, forms, split, merge) y OCR opcional vía LLM.
- Se instala con Docker (
make up) y queda disponible enlocalhost:8085, sin costo de licencia por tratarse de un proyecto open source. - El autor lo publicó el 27 de octubre de 2026 sin métricas de adopción externas ni benchmarks de terceros que confirmen los números del repositorio.
¿Qué problema de procesamiento de archivos busca resolver Filers?
Filers busca sacarle a tu aplicación de negocio el trabajo pesado de abrir, parsear y validar archivos, y mandarlo a un servicio aparte escrito en Rust. La idea, según describe el propio autor en su publicación en dev.to, es simple: una aplicación externa llama a esta API y recibe el archivo ya parseado en la respuesta.
Si alguna vez tuviste un endpoint de Node o PHP que se cuelga cada vez que un usuario sube una planilla grande, entendés el dolor. Subís el archivo, el servidor se pone a leerlo celda por celda, el request queda colgado, y si dos usuarios suben archivos grandes al mismo tiempo el proceso completo colapsa. Filers propone mover esa carga a un proceso Rust con paralelismo real vía rayon, separado del resto de la app.
¿Qué funcionalidades ofrece Filers?
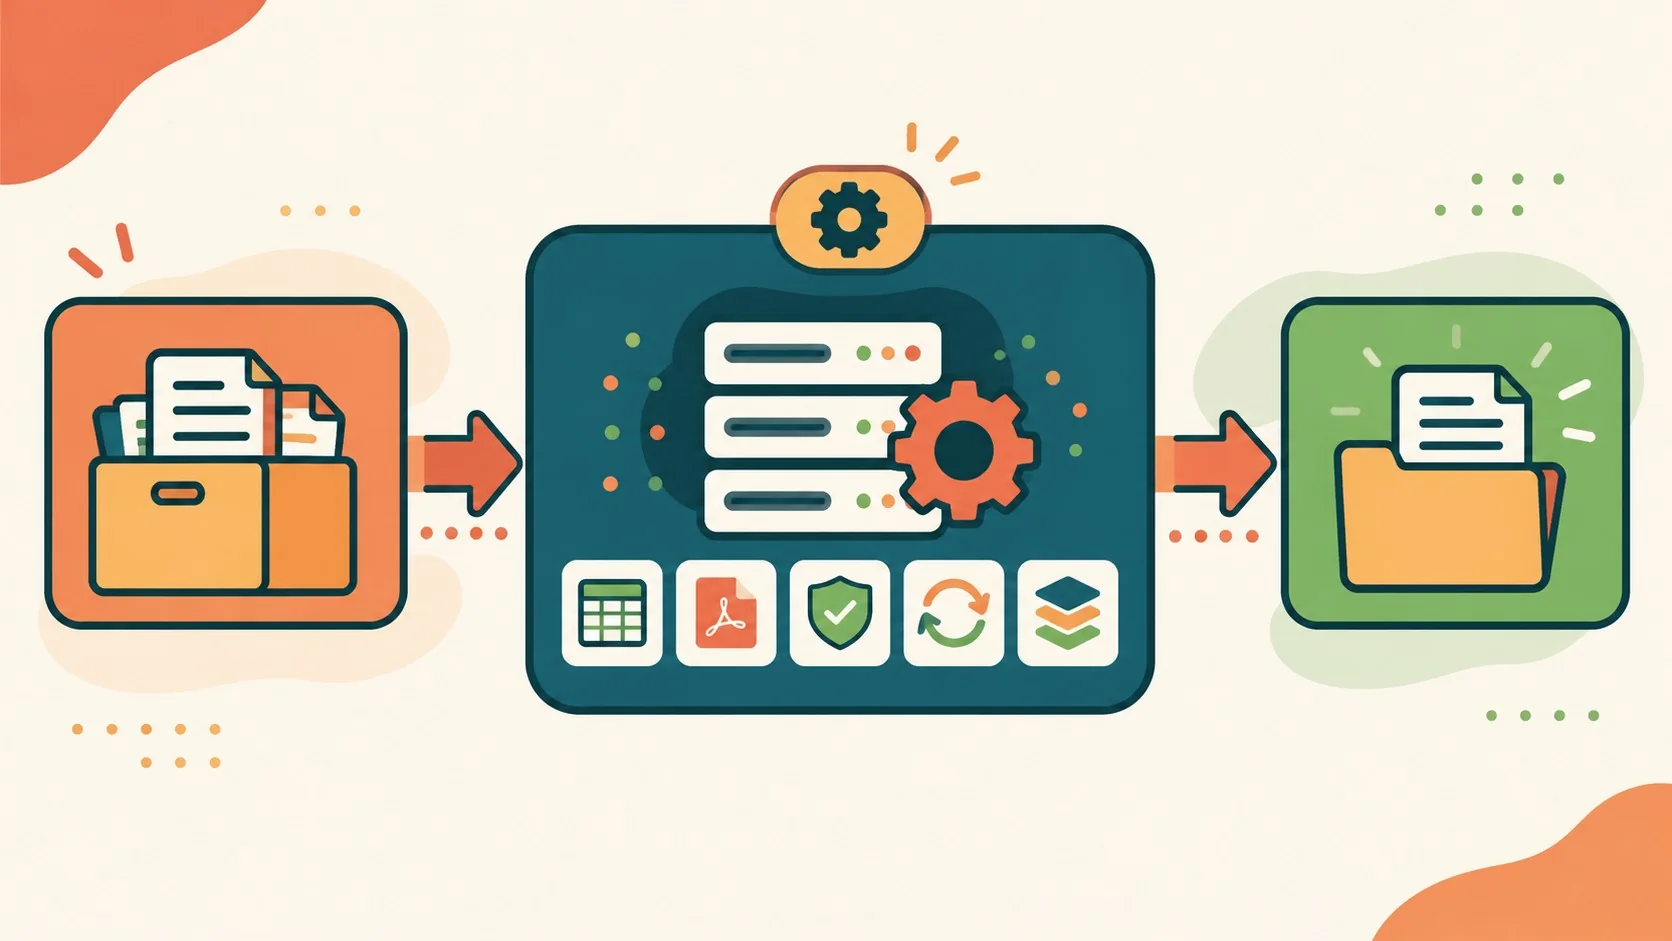
Filers ofrece siete operaciones principales sobre spreadsheets (parse, profile, validate, convert, transform, diff y pipeline) más un set separado de operaciones para PDF y procesamiento batch. Todo se expone como endpoints HTTP que reciben un archivo multipart y devuelven JSON o un archivo convertido. Esto se conecta con lo que analizamos en la reescritura de SQLite en Rust.
Procesamiento de planillas
- Parse: convierte xlsx, xls, ods o csv en
{ columns, data, stats, errors, timings }, con desglose de tiempo real de CPU versus tiempo de espera, útil para detectar si el cuello de botella es el host y no el parseo. - Profile: infiere el tipo de cada columna, cardinalidad, mínimo, máximo, promedio y valores más frecuentes.
- Validate: aplica un schema declarativo (campos requeridos, tipo, regex, enum, únicos, rangos) y devuelve errores fila por fila.
- Transform y convert: encadena cast, filtro, selección de columnas y renombrado, y exporta a csv, json, ndjson o xlsx.
- Diff: compara dos archivos por clave y muestra filas agregadas, eliminadas y campos cambiados, con un tope de 5000 resultados por respuesta.
Operaciones con PDF y OCR
El módulo PDF funciona en Rust puro (sin dependencias nativas) para info, texto, formularios, split y merge, y suma una extracción asistida por LLM para convertir cualquier layout en el JSON que pida quien llama a la API. El OCR extrae texto de imágenes vía un modelo de visión y queda apagado por defecto: solo se activa si configurás una OCR_LLM_API_KEY.
Workflows batch y autenticación
El modo batch procesa un directorio completo de archivos en segundo plano y avisa por webhook firmado con HMAC cuando termina. Para autenticarse hay tres caminos: clave de servicio fija por header, OAuth2 client-credentials con rotación de refresh tokens, o cookie de sesión para el panel admin. Cada cliente externo puede tener su propio límite de rate, cuota mensual de páginas y una cuota independiente de tokens de IA para OCR y extracción de PDF.
¿Con qué tecnologías está construido Filers?
Filers está construido con Rust 2024, el framework web axum 0.7 y el runtime asíncrono tokio en el backend, más React, Vite y TanStack Query/Table en el frontend admin. Para persistencia opcional usa sqlx 0.8 contra Postgres y Redis para compartir límites de rate entre réplicas. Sobre eso hablamos en procesamiento sin asignación de memoria con SIMD.
¿Por qué Rust y no Node o Python para esto? Porque el parseo de un xlsx es trabajo intensivo de CPU: leer bytes, decodificar XML, construir estructuras. Rust garantiza seguridad de memoria en tiempo de compilación sin recolector de basura, lo que elimina pausas de garbage collection justo en el tipo de carga donde más duelen. El proyecto usa calamine para leer xlsx sin clonar los shared strings, quick-xml para stream de filas sin armar la matriz completa en memoria, y rayon para paralelizar la conversión celda a JSON entre núcleos. También tiene un cap de celdas (MAX_CELLS) y un guard contra zip-bombs (MAX_UNCOMPRESSED_MB) que rechazan archivos patológicos antes de materializar nada en memoria.
¿Dónde conseguir el código y probar Filers?
El código fuente está en el repositorio de GitHub venturaproject/filers, y la demo del proyecto vive en venturaproject.github.io/filers. Es gratis: no hay plan pago ni versión enterprise mencionada, porque es software open source que se autohospeda.
Para levantarlo en local hace falta Docker. El flujo es cp .env.example .env seguido de make up, que levanta nginx, la API, el frontend y Postgres/Redis detrás de un único entrypoint en http://localhost:8085. El login admin por defecto es [email protected] con contraseña admin1234, y la clave de servicio de desarrollo es dev-key (se manda en el header x-api-key). Ojo: esas credenciales son para desarrollo; el propio proyecto marca como error fatal en producción dejar una API_KEYS por defecto o una contraseña débil de admin cuando APP_ENV=production.
¿Qué está confirmado y qué no sobre Filers?
Confirmado, según la fuente primaria: la arquitectura (Rust, axum, React), el set de endpoints, los esquemas de autenticación y el benchmark de 0,5 s contra 20 s publicado por el propio autor en el repositorio. No confirmado: no hay benchmarks independientes que repliquen esa comparación con PHP, no hay métricas de adopción ni número de instalaciones, y no hay un roadmap público más allá de lo descrito en el post original de dev.to. Para más detalles técnicos, mirá nuestro controlador Ingress hecho en Rust.
Un criterio razonable antes de meter esto en producción: corré el benchmark del cell cap con tu propio dataset real, no con el archivo de prueba del repo, y mirá el desglose parse_ms versus parse_cpu_ms que trae la respuesta. Si la diferencia es grande, el problema es contención de CPU en tu host, no el parser.
Errores comunes al evaluar Filers
El primero es comparar el benchmark de 0,5 s tal cual, sin aclarar que es tiempo de servidor medido por el propio autor, no un test independiente con metodología publicada. Tomalo como punto de partida, no como verdad absoluta para tu caso.
El segundo es dejar las credenciales de ejemplo (dev-key, admin1234) en un deploy real. El proyecto mismo las bloquea con validaciones fatales cuando detecta APP_ENV=production, pero si corrés sin esa variable seteada, nada te avisa. Cubrimos ese tema en detalle en este gestor de túneles SSH en Rust.
El tercero es asumir que el módulo PDF hace OCR de PDFs escaneados. No lo hace: la extracción de texto es best-effort sobre PDFs con texto real, y un PDF escaneado necesita pasar por el endpoint de OCR aparte, que además queda apagado hasta que configures una API key de un LLM de visión.
Preguntas Frecuentes
¿Qué es Filers y qué problema resuelve?
Filers es una API de código abierto escrita en Rust que procesa archivos de spreadsheet y PDF fuera del backend principal de una aplicación. Resuelve el problema de aplicaciones web que se cuelgan o consumen demasiada CPU al parsear planillas grandes, delegando esa tarea a un servicio dedicado y optimizado.
¿Qué tipos de archivos puede procesar Filers?
Filers procesa xlsx, xls, ods y csv para operaciones de spreadsheet, y PDF para info, texto, formularios, split, merge y extracción asistida por LLM. También acepta imágenes en el endpoint de OCR cuando está configurado un modelo de visión.
¿Por qué usar Rust para procesar archivos en vez de Node o Python?
Rust no tiene recolector de basura, así que evita las pausas de garbage collection que aparecen en Node o Python justo cuando más CPU necesitás, durante el parseo de archivos grandes. Filers combina eso con calamine, quick-xml y rayon para leer y paralelizar sin clonar datos de más, algo que explica la diferencia de tiempos reportada frente a un stack PHP típico.
¿Filers es gratuito y de código abierto?
Sí, Filers es un proyecto open source disponible en GitHub bajo venturaproject/filers, sin costo de licencia. Se autohospeda con Docker y no hay versión SaaS paga mencionada por el autor hasta el 27 de octubre de 2026.
¿Cómo se integra Filers a una aplicación existente?
Tu aplicación llama a los endpoints de Filers por HTTP, mandando el archivo como multipart y recibiendo JSON o un archivo convertido como respuesta. La autenticación se hace con una clave de servicio fija por header o con OAuth2 client-credentials si sos un cliente externo con scopes y cuotas propias.
Conclusión
Filers suma una opción concreta para quien necesita sacar el procesamiento de archivos del backend principal sin armar esa infraestructura desde cero. El dato que más pesa hoy es el benchmark propio del autor (0,5 s contra 20 s), que vale como indicio de diseño correcto (lectura sin copias, paralelismo con rayon) pero todavía no tiene validación independiente. Si estás evaluando moverlo a producción, el paso lógico es clonar el repositorio, correr tu propio dataset contra el endpoint de parse, y mirar el desglose de tiempos antes de sacar conclusiones sobre tu caso puntual.