Parsers webhooks sin allocation con SIMD en Go y Rust
En pocas palabras: Un parser webhook sin allocation usa SIMD para indexar la estructura JSON sin construir un árbol de objetos: simdjson-go corre a 40-60% de la velocidad del simdjson en C++ y es ~10x más rápido que encoding/json, mientras que simd-json en Rust parsea in-place reutilizando buffers entre requests.
Un gateway de webhooks que recibe 50.000 requests por segundo a 2 KB promedio mueve apenas 100 MB/s de tráfico, pero puede fundir la CPU igual. El cuello de botella no es la red: son las allocations y el árbol de objetos que cada request construye antes de leer un solo campo. Ahí entran los parsers webhooks sin allocation con SIMD.
Un parser webhook sin allocation es una técnica de parseo JSON que evita construir un árbol completo de objetos en memoria, usando instrucciones SIMD para indexar la estructura del documento y leer solo los campos necesarios para enrutar el evento. La describe en detalle un artículo técnico publicado el 25 de octubre de 2026, centrado en implementaciones con Go y Rust.
En este artículo:
- En 30 segundos
- ¿Por qué los endpoints de webhooks se saturan bajo ráfagas de tráfico?
- ¿Cómo afecta la alta tasa de allocation al garbage collector de Go y al allocator de Rust?
- ¿Qué hace realmente SIMD en el parseo de JSON (y qué no hace)?
- ¿Cómo se implementa un parser webhook sin allocation en Go con simdjson-go?
- ¿Cómo se implementa el borrowing de buffers en Rust con simd-json?
- ¿’Zero allocation’ es una garantía real o un objetivo a optimizar?
- Errores comunes al optimizar parsers de webhooks
- Qué significa esto para equipos de infraestructura en Latinoamérica
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- 50.000 req/s a 2 KB promedio son ~100 MB/s: el costo real está en las allocations y el tree building, no en el tráfico de red.
- simdjson-go (github.com/minio/simdjson-go) corre a 40-60% de la velocidad del simdjson en C++ y es ~10x más rápido que encoding/json según benchmarks propios del proyecto.
- simdjson-go requiere CPU con AVX2 y CLMUL (Intel Haswell 2013+ o AMD Ryzen/EPYC 2017+), y su última release tagueada es v0.4.5 de marzo de 2023.
- simd-json en Rust parsea in-place y modifica el buffer de entrada: la firma HMAC se verifica siempre antes de parsear, nunca después.
- Ningún sketch de código del artículo logra cero allocations reales: net/http sigue allocando por request y BorrowedValue en Rust también alloca para objects y arrays.
¿Por qué los endpoints de webhooks se saturan bajo ráfagas de tráfico?
Se saturan porque cada request repite un patrón caro: lee el body en un buffer nuevo, copia bytes a strings, construye un árbol completo de objetos y recién después verifica la firma. Ponele que te llega una ráfaga de GitHub o de un procesador de pagos mandando miles de eventos chiquitos por segundo: un handler armado como endpoint REST común no distingue esa carga de tráfico normal, y ahí empieza el problema.
En Go, net/http alloca un Request y un header map por cada conexión, y io.ReadAll va agrandando un slice a medida que lee. Convertir []byte a string copia los datos en el caso general (el compilador evita la copia solo en casos puntuales, como comparaciones o lookups de mapa). En Rust pasa algo parecido con String::from_utf8 o to_owned. Lo caro no es leer 100 MB/s de red, eso cualquier servidor lo bancás sin despeinarte. Lo caro es construir un map[string]interface{} o un serde_json::Value completo cuando el handler solo necesita un campo, típicamente el tipo de evento, para decidir a dónde rutear.
¿Cómo afecta la alta tasa de allocation al garbage collector de Go y al allocator de Rust?
En Go, el colector tri-color mark-and-sweep es concurrente y usa aproximadamente 25% de CPU en marking durante un ciclo activo, además de “mark assists” que conscriptan goroutines que allocan rápido para que ayuden con el trabajo de GC. Tiene dos fases stop-the-world por ciclo, pero el runtime las mantiene en el rango de sub-milisegundos. El tema es que, si tu p99 de pausas de GC supera los 10 ms, eso es señal de que el colector está peleando contra un heap que crece y se achica todo el tiempo. Te puede servir nuestra cobertura de si tu hardware de borde también importa.
Rust no tiene garbage collector. ¿Entonces no hay problema? No exactamente. Cada String, Vec y HashMap implica una llamada al allocator, y bajo alta concurrencia eso genera contención del allocator, mala localidad de caché y latencia que depende del estado interno del allocator en ese momento. La solución en los dos lenguajes apunta al mismo lugar: tomar prestado (borrow) del buffer de entrada en vez de copiar, y reusar buffers en vez de allocar nuevos en cada request.
¿Qué hace realmente SIMD en el parseo de JSON (y qué no hace)?
SIMD acelera el parseo y la validación de JSON procesando el input en bloques de 64 bytes con vectores de 128, 256 o 512 bits según el set de instrucciones (NEON, AVX2 o AVX-512), pero no toca la lectura del socket, TLS, el framing HTTP ni la verificación de firma. Eso sigue corriendo a la velocidad de siempre.
El diseño de referencia es simdjson, de Geoff Langdale y Daniel Lemire, descrito en el paper Parsing Gigabytes of JSON per Second como el primer parser JSON estándar-compliant en procesar gigabytes por segundo en un solo core con procesadores comunes, usando una cuarta parte o menos de las instrucciones que necesita un parser convencional como RapidJSON. Funciona en dos etapas: primero construye un índice estructural detectando comillas, backslashes y caracteres estructurales con comparaciones vectoriales y bitmasks; después camina ese índice y arma un “tape”, un array plano que describe la estructura del documento sin construir un árbol de objetos en el heap.
Ojo con un par de mitos dando vueltas. SIMD no procesa un bloque “en un solo ciclo de CPU” (son varias instrucciones vectoriales sin branches dependientes de datos), y tampoco está atado a AVX-512: simd-json en Rust soporta AVX2, SSE4.2, NEON y WebAssembly SIMD128, mientras que simdjson-go requiere AVX2 y CLMUL, usando AVX-512 solo para acelerar la primera etapa donde está disponible. Para más detalles técnicos, mirá cuando el pipeline no arranca por webhooks.
¿Cómo se implementa un parser webhook sin allocation en Go con simdjson-go?
Se implementa con github.com/minio/simdjson-go, un port pure Go de simdjson sin cgo, reusando la estructura *ParsedJson entre requests con un sync.Pool en vez de reallocarla cada vez. El proyecto reporta en su propio README correr a 40-60% de la velocidad del simdjson en C++ y ser aproximadamente 10x más rápido que encoding/json en sus benchmarks internos.
El requisito de hardware es concreto: necesita AVX2 y CLMUL, lo que implica CPU Intel Haswell (2013) o posterior, o AMD Ryzen/EPYC (2017) o posterior. Antes de meterlo en producción conviene chequear dos cosas. Primero, el estado real de mantenimiento: la última release tagueada en pkg.go.dev, v0.4.5, es de marzo de 2023, y al menos un fork (el de DataDog) está archivado. Segundo, que el 10x es un resultado de benchmark del propio proyecto, no una promesa, y depende de la forma del payload y de cuánto del documento efectivamente leés. El flujo correcto en un handler es: leer el body en un buffer pooled con límite de tamaño, verificar la firma HMAC-SHA256 sobre esos bytes crudos con hmac.Equal, y recién ahí llamar a simdjson.Parse pasándole el *ParsedJson anterior para reusar tape y buffers de strings.
¿Cómo se implementa el borrowing de buffers en Rust con simd-json?
Se implementa parseando in-place sobre un &mut [u8], porque simd-json unescapa las strings directamente en el buffer de entrada para que el valor parseado pueda tomar prestados (borrow) los datos sin copiarlos. Esa es literalmente la fuente del beneficio zero-copy: el borrow checker ata el lifetime de las strings parseadas al del buffer.
Hay que distinguir dos crates que se confunden fácil. simd-json es el port Rust de simdjson con compatibilidad serde, soporta AVX2, SSE4.2, NEON y WASM SIMD128 con fallback nativo, y ofrece tipos DOM borrowed y owned además de una API de tape de menor overhead. simdjson-rust, en cambio, son bindings a la librería C++ original, y su última versión listada en docs.rs es un 0.4.0-alpha, todavía pre-release. Para producción, simd-json es la opción más establecida de las dos. Acá viene el punto que no se puede saltear: como el parser modifica el buffer mientras unescapa strings, después de parsear esos bytes ya no son los que firmó el emisor. Verificás la firma, copiás al buffer reusable, y recién ahí parseás. En ese orden, siempre. Tema relacionado: las fallas silenciosas que pueden pasar desapercibidas.
¿’Zero allocation’ es una garantía real o un objetivo a optimizar?
Es un objetivo a optimizar, no una garantía (spoiler: ningún sketch del artículo original llega a cero allocations de punta a punta). En Go, net/http sigue allocando un Request por conexión y hmac.New alloca salvo que también lo pooles. En Rust, BorrowedValue toma prestadas las strings del buffer, pero sigue allocando para objects y arrays, así que para un workload de puro routing la API de tape reduce más ese overhead.
¿Cómo se mide esto en serio, entonces? Con go test -bench . -benchmem y mirando la columna allocs/op, no la intención de diseño del código. Si el costo de GC sigue siendo un problema en Go, GOGC y GOMEMLIMIT (disponible desde Go 1.19) son palancas separadas: GOMEMLIMIT fija un límite de memoria soft, y combinado con un GOGC ajustado reduce la frecuencia de ciclos de recolección a cambio de usar más memoria.
| Parser | Lenguaje | Velocidad relativa | Requisito de CPU | Estado (oct. 2026) |
|---|---|---|---|---|
| encoding/json | Go | Base (1x) | Ninguno | Stdlib, activo |
| simdjson-go | Go (pure Go, sin cgo) | ~10x vs encoding/json; 40-60% del simdjson en C++ | AVX2 + CLMUL (Haswell 2013+ / Ryzen-EPYC 2017+) | Última release v0.4.5, marzo 2023 |
| serde_json::Value | Rust | Base (1x) | Ninguno | Activo |
| simd-json | Rust | Acelerado por SIMD, parsea in-place | AVX2, SSE4.2, NEON, WASM SIMD128 | Activo |
| simdjson-rust | Rust (bindings a C++) | Velocidad del simdjson original | Según build de simdjson | 0.4.0-alpha (pre-release) |
Errores comunes al optimizar parsers de webhooks
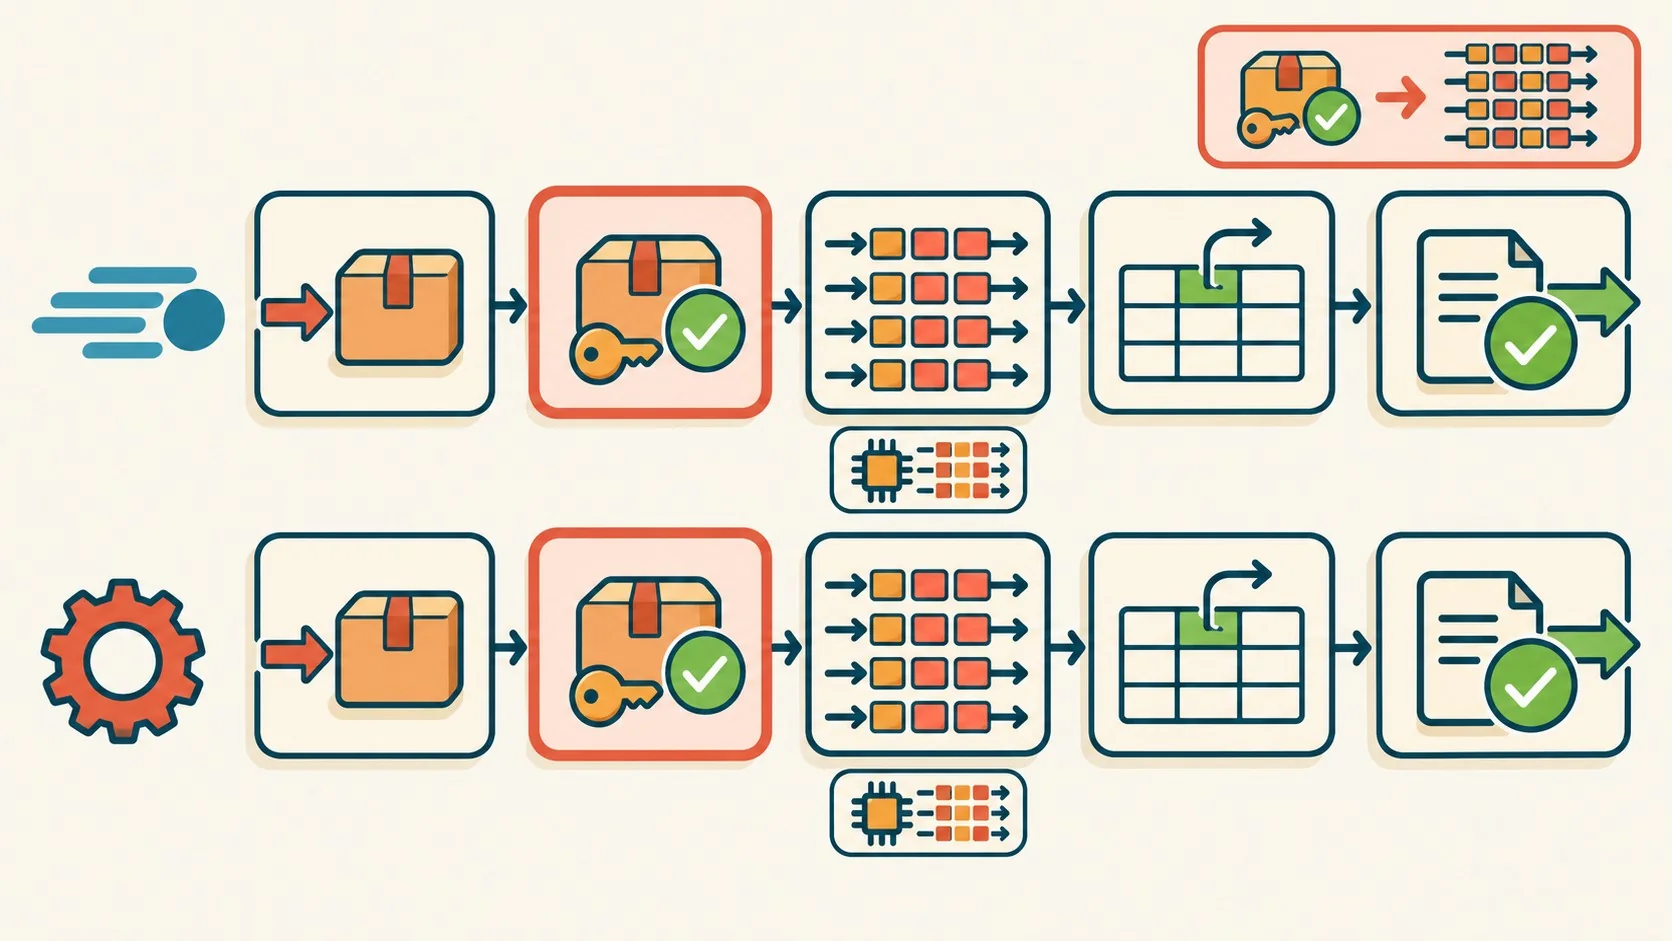
- Verificar la firma después de parsear. En Rust, simd-json modifica el buffer in-place al unescapar strings. Si parseás primero y verificás después, estás comparando contra bytes que ya no son los que firmó el emisor, y la verificación pasa a ser inútil aunque el código “compile y corra”.
- Confiar en el “10x” sin medir tu propio caso. El número de simdjson-go es un resultado de benchmark del proyecto con sus payloads. El tuyo puede tener campos distintos, anidamiento distinto y un patrón de lectura distinto. Sin
-benchmemcorriendo contra tu propio tráfico, es un dato de marketing técnico, no una promesa. - Desplegar sin chequear el set de instrucciones del CPU. simdjson-go necesita AVX2 y CLMUL. Si tu contenedor corre en una VM vieja o en un plan de cloud genérico sin esas extensiones, el handler falla en runtime. Conviene llamar a
simdjson.SupportedCPU()antes de servir tráfico real, no descubrirlo en producción. - Construir el árbol completo para leer un solo campo. Si el handler solo necesita el tipo de evento para rutear, armar un
map[string]interface{}o unserde_json::Valuecompleto es tirar CPU a la basura. La ventaja real de un tape o de un parser on-demand está justo ahí: leer un campo sin construir todo el documento.
Qué significa esto para equipos de infraestructura en Latinoamérica
Si tu equipo opera un gateway de webhooks propio (para pagos, integraciones con control de versiones o flotas IoT), la pregunta de fondo no es si SIMD “vale la pena” en abstracto, sino si tu CPU soporta las extensiones que estos parsers necesitan. AVX2 y CLMUL están disponibles en instancias cloud comunes desde hace años, pero conviene chequearlo antes de migrar, sobre todo en VPS más viejos o en planes genéricos donde la CPU virtualizada no siempre expone todo el set de instrucciones del host físico. Si vas a levantar un gateway de este tipo en infraestructura propia en Argentina, un VPS o cloud con CPU moderna en donweb.com te saca esa duda de encima desde el arranque.
Preguntas Frecuentes
¿Qué es un parser JSON zero-allocation?
Es un parser diseñado para minimizar o eliminar las asignaciones de memoria en el heap durante el parseo, generalmente tomando prestados (borrowing) los datos del buffer de entrada en vez de copiarlos a nuevas estructuras. En la práctica es un objetivo de optimización medible con allocs/op, no una garantía absoluta.
¿Cómo funciona SIMD en el parseo de JSON?
SIMD procesa el input en bloques de hasta 64 bytes usando registros vectoriales (128 a 512 bits) para detectar comillas, backslashes y caracteres estructurales con una sola pasada, generando bitmasks en vez de recorrer byte por byte. Con eso construye un índice estructural y después un “tape” que describe el documento sin armar un árbol de objetos en el heap. Relacionado: un enfoque de blindaje zero trust en el ingreso.
¿simdjson-go sigue mantenido en 2026?
Su última release tagueada en pkg.go.dev es v0.4.5, publicada en marzo de 2023, y al menos un fork conocido (el de DataDog) está archivado. Antes de adoptarlo en un gateway de producción conviene revisar la actividad actual del repositorio en github.com/minio/simdjson-go.
¿Por qué hay que verificar la firma HMAC antes de parsear el body?
Porque la firma cubre los bytes exactos que mandó el emisor, y en Rust simd-json modifica el buffer in-place al unescapar strings durante el parseo. Si verificás después de parsear, estás comparando contra bytes que ya no coinciden con los que se firmaron originalmente, y la verificación queda invalidada.
¿Qué diferencia hay entre simd-json y simdjson-rust?
simd-json es un port nativo de Rust compatible con serde, con soporte para AVX2, SSE4.2, NEON y WASM SIMD128, y es la opción más establecida para producción. simdjson-rust son bindings a la librería C++ original y su última versión en docs.rs es un 0.4.0-alpha, todavía pre-release.
Conclusión
Lo que cambia con SIMD en el parseo de webhooks no es la velocidad de red, sino dónde se va la CPU: de construir árboles de objetos completos a indexar estructura y leer solo lo que necesitás para rutear. simdjson-go te da ese salto en Go con un port pure Go sin cgo, pero con una señal de alarma clara sobre mantenimiento que hay que chequear antes de meterlo en un sistema crítico. simd-json en Rust te da lo mismo con borrowing nativo, a cambio de la disciplina de verificar la firma antes de tocar el buffer.
Si estás armando o rearmando un gateway de ingesta de webhooks, el paso concreto es simple: medí tu allocs/op actual con tu propio tráfico, confirmá que tu CPU soporta AVX2 y CLMUL (o el equivalente NEON/AVX-512), y recién después decidí si el salto a SIMD se justifica para tu volumen real de requests por segundo.