Pod atascado en ContainerCreating: guía de diagnóstico
En pocas palabras: Un pod atascado en ContainerCreating con FailedCreatePodSandBox indica que containerd no pudo armar el sandbox (contenedor pause + namespace de red) antes de iniciar los contenedores. La solución depende del mensaje exacto: falta de IP en el CNI, token de service account vencido, imagen pause inalcanzable o timeout del runtime por sobrecarga del nodo.
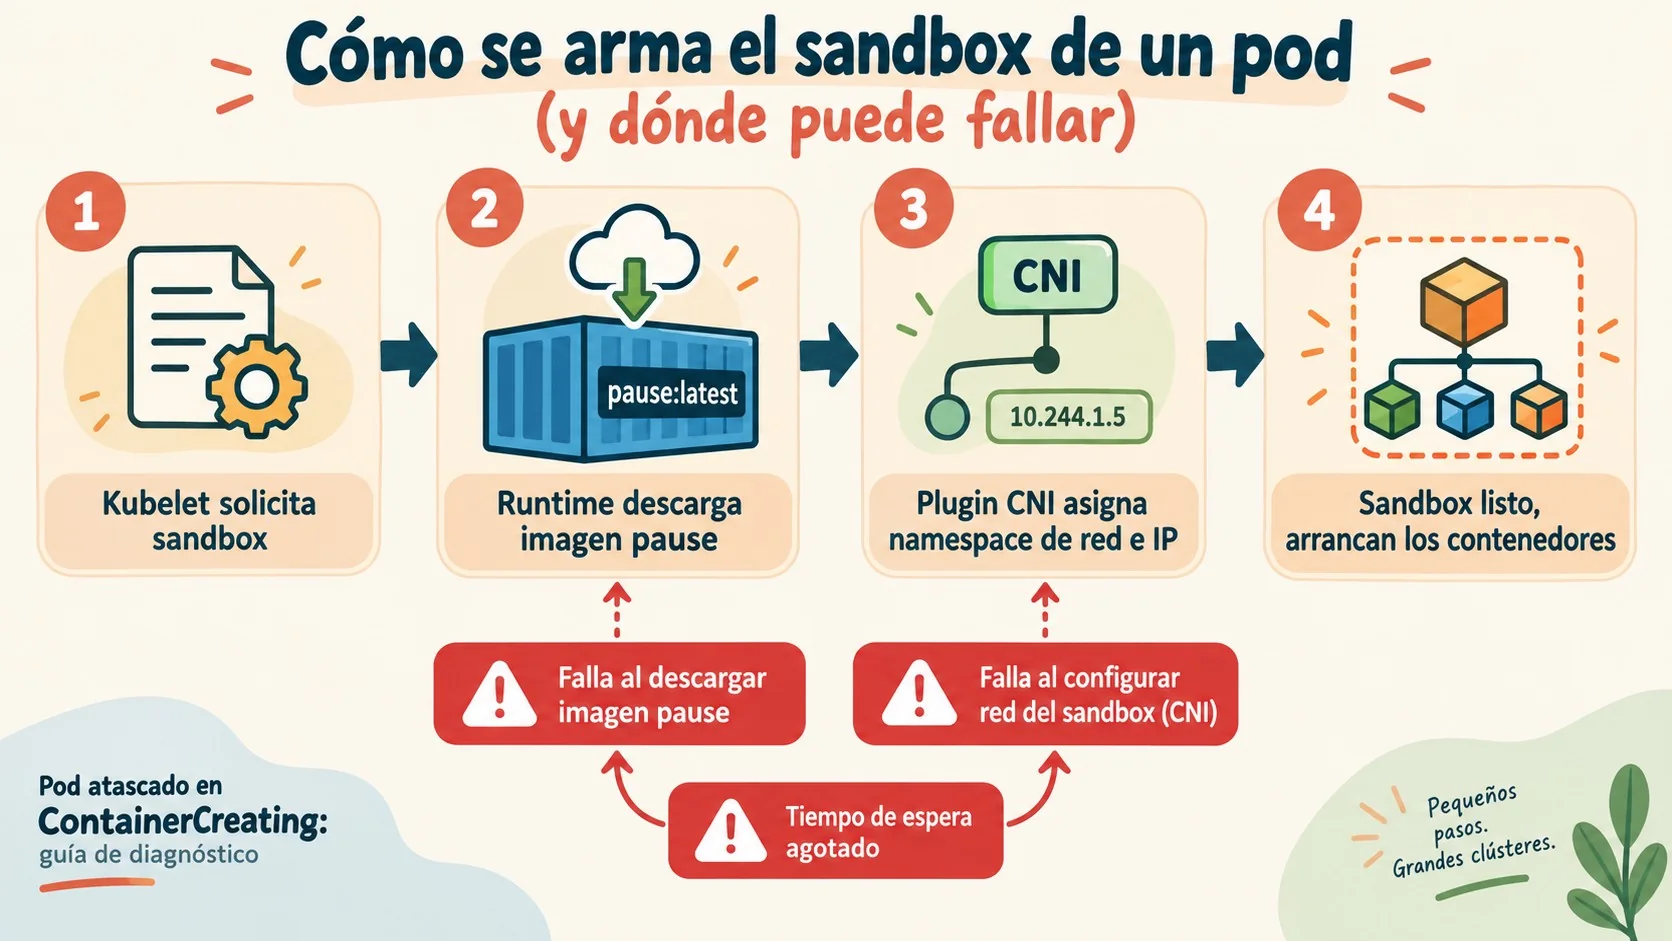
El evento aparece cuando el kubelet le pide a containerd armar el sandbox del pod —el proceso pause que sostiene el namespace de red compartido por todos los containers— y esa operación falla antes de que arranque un solo contenedor de la aplicación. El pod queda en ContainerCreating, con cero reinicios y sin logs propios que revisar, porque técnicamente nada tuyo llegó a ejecutarse todavía. La guía de devtocash sobre este error documenta bien los mensajes típicos; acá los organizamos como una secuencia de preguntas para decidir rápido qué mirar primero.
En este artículo:
- En 30 segundos
- ¿Qué diferencia hay entre ContainerCreating, FailedMount y un nodo NotReady?
- ¿Cómo leer el error real detrás de FailedCreatePodSandBox?
- ¿El problema es de un pod, de un nodo o de todo el clúster?
- ¿Por qué falla la asignación de IP en el CNI de AWS (VPC CNI / EKS)?
- ¿Qué hacer cuando el plugin CNI no puede autenticarse o no responde?
- ¿Por qué no se puede descargar la imagen pause y cómo se soluciona?
- ¿Qué otros errores de sandbox existen (timeout, nombre reservado, RuntimeClass)?
- ¿Cómo prevenir que un pod vuelva a quedar atascado en ContainerCreating?
- Errores comunes al diagnosticar FailedCreatePodSandBox
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- FailedCreatePodSandBox es un fallo del handshake entre kubelet, containerd y el plugin CNI, distinto de FailedMount o de un nodo NotReady.
- El mensaje “failed to setup network for sandbox” señala un fallo del CNI (aws-cni, calico, cilium). Cualquier otro texto es un fallo de runtime previo al CNI.
- En EKS, la causa más común es agotamiento de IPs del VPC CNI, que se soluciona de forma durable con prefix delegation (ENABLE_PREFIX_DELEGATION=true).
- crictl pods –state NotReady y crictl inspectp muestran sandboxes que el kubelet ya abandonó, útiles para diagnosticar nodo por nodo.
- Una alerta sobre la métrica awscni_total_ip_addresses menos awscni_assigned_ip_addresses previene el problema antes de que aparezca el primer pod atascado.
¿Qué diferencia hay entre ContainerCreating, FailedMount y un nodo NotReady?
FailedCreatePodSandBox no tiene nada que ver con volúmenes. Los volúmenes se adjuntan antes de que se construya el sandbox, así que si tu pod tiene ese problema vas a ver FailedMount o FailedAttachVolume en los eventos, no este error. Y si el nodo entero está en estado NotReady, ahí el diagnóstico arranca por el nodo (su runtime, su CNI), porque ningún pod puede sandboxear sobre un nodo que ya está caído.
Lo que queda, una vez descartados esos dos casos, es exactamente lo que vamos a diagnosticar acá: el nodo está Ready, los volúmenes están bien, y el pod sigue sin levantar. El sandbox es el contenedor pause más el namespace de red que todos los containers del pod comparten. Sin eso armado, tu imagen ni siquiera se descarga.
¿Cómo leer el error real detrás de FailedCreatePodSandBox?
El texto completo del evento importa más que el status ContainerCreating. Corré kubectl describe pod api-7d9f-x2kq -n prod | grep -A3 FailedCreatePodSandBox y fijate en el mensaje exacto, porque ahí está la pista. Si además te preocupan los costos de la infraestructura mientras estás en esto, tenemos un análisis aparte sobre optimizar los costos de tu infraestructura cloud.
El armado del sandbox sigue siempre el mismo orden de dos pasos: primero containerd descarga la imagen pause y crea el sandbox, después llama al plugin CNI para darle IP y conectarlo a la red del clúster. De ahí sale un criterio simple para no perder tiempo: si el mensaje contiene “failed to setup network for sandbox”, el sandbox ya existe y el fallo es del CNI ADD —el nombre del plugin (aws-cni, calico, cilium-cni, flannel) te dice a quién culpar—; cualquier otro texto ocurrió antes de que el CNI fuera siquiera invocado, así que ni te molestes en revisar logs del CNI todavía.
¿Y si los eventos ya rotaron y no ves nada útil? El kubelet y containerd guardan el historial completo en sus journals del nodo: journalctl -u kubelet --since -30m | grep -i sandbox y lo mismo con -u containerd filtrando por “sandbox|cni”.
¿El problema es de un pod, de un nodo o de todo el clúster?
El radio de impacto cambia el diagnóstico completo. kubectl get pods -A --field-selector status.phase=Pending -o wide filtrado por ContainerCreating te muestra todos los afectados de una: si es un solo nodo, mirá su CNI DaemonSet o su containerd; si es una AZ entera, sospechá de la subred sin IPs libres; si es todo el clúster, buscá una credencial CNI vencida o un registry inalcanzable.
Regla práctica para no perder tiempo: si el problema aparece en más de un nodo pero no en todos, conviene sospechar primero de la subred o del pool de esa AZ antes que de un cambio de configuración global. Un fallo verdaderamente cluster-wide casi siempre coincide con algo que le pasó a todos los nodos al mismo tiempo —un despliegue reciente del CNI, un token o certificado que venció para todos a la vez— y no con una coincidencia de carga.
En el caso de un solo nodo, crictl te da la vista del runtime antes que la de Kubernetes. crictl pods --state NotReady muestra sandboxes que el kubelet ya dio por perdidos, y crictl inspectp <id> | jq '.status.network' te dice exactamente dónde quedó trabado.
¿Por qué falla la asignación de IP en el CNI de AWS (VPC CNI / EKS)?
“failed to assign an IP address to container” es la causa más común en EKS. El scheduler ya ubicó el pod porque el nodo tiene lugar bajo su max-pods, pero el daemon aws-node se quedó sin IP para entregar. Dos pools distintos pueden estar vacíos, y cada uno pide un fix diferente. Para más detalles técnicos, mirá automatizar la sincronización entre tus herramientas.
El warm pool del nodo se agota durante un burst (un rollout grande, un reboot que reprograma 60 pods de golpe) y se autorresuelve solo en 30 a 90 segundos. Chequealo con las métricas del propio daemon en el puerto 61678. El otro caso, cuando AvailableIpAddressCount de la subred llega a cero, no se arregla esperando: ahí todo nuevo pod en toda esa subred falla hasta que se libere una IP. Un /24 te da unos 250 IPs usables para nodos, ENIs, balanceadores y pods combinados, y los clústeres se quedan cortos sin que nadie lo note hasta que explota.
Ejemplo hipotético: imaginá un rollout que reprograma varios pods de golpe en un mismo nodo de EKS. Algunos sandboxes se crean sin drama, pero el resto queda en ContainerCreating con “failed to assign an IP address to container” y a los pocos segundos se resuelve solo, sin que nadie haya tocado nada. Ese patrón —falla puntual que desaparece sin intervención— es la firma del warm pool agotándose de forma transitoria, no de la subred. La señal para cambiar de diagnóstico es otra: si los pods siguen sin levantar pasado ese margen de autorrecuperación, o si AvailableIpAddressCount de la subred marca cero, ahí ya no alcanza con esperar y hace falta prefix delegation o una subred nueva.
La solución durable es prefix delegation: kubectl set env daemonset aws-node -n kube-system ENABLE_PREFIX_DELEGATION=true WARM_PREFIX_TARGET=1, que asigna bloques /28 (16 IPs) por ENI en vez de IPs sueltas. Ojo con esto: necesita bloques /28 contiguos, así que en una subred fragmentada al 95% puede directamente no encontrar espacio, y ahí toca sumar un CIDR secundario con custom networking.
| Mensaje de error | Causa raíz | Cómo confirmarlo |
|---|---|---|
| failed to assign an IP address to container | Warm pool o subred de EKS sin IPs libres | Métricas de aws-node en puerto 61678 |
| connection is unauthorized: Unauthorized | Token de service account vencido en Calico | Revisar /etc/cni/net.d/calico-kubeconfig |
| failed to get sandbox image pause | Registry inalcanzable o proxy mal configurado | crictl pull registry.k8s.io/pause:3.9 |
| context deadline exceeded | Runtime saturado (I/O, rollout masivo) | kubectl top node + iostat -x en el nodo |
| name is reserved for | Sandbox huérfano tras reinicio del kubelet | crictl pods –name <pod> –namespace <ns> |
| no runtime for gvisor is configured | RuntimeClass sin handler instalado en el nodo | cat /etc/containerd/config.toml |
¿Qué hacer cuando el plugin CNI no puede autenticarse o no responde?
El mensaje “connection is unauthorized: Unauthorized” de Calico es la firma clásica de un token de service account vencido que el CNI del nodo sigue usando. Calico escribe un kubeconfig en /etc/cni/net.d/calico-kubeconfig, y si calico-node estaba caído justo cuando el token rotó, ese archivo queda desactualizado y cada CNI ADD en ese nodo se rechaza.
La solución es simple: borrar el pod calico-node de ese nodo puntual para que regenere el kubeconfig con kubectl delete pod -n kube-system -l k8s-app=calico-node --field-selector spec.nodeName=<nodo>. Cilium tiene su equivalente con “unable to connect to Cilium daemon”, que pasa cuando el agente cilium está reiniciando o crasheado. En ambos casos, revisá si el DaemonSet CNI está en CrashLoopBackOff (ahí está tu causa raíz) y comparé los binarios de /opt/cni/bin contra lo que pide el conflist en /etc/cni/net.d/, porque un upgrade de CNI que cambió el nombre del plugin sin actualizar el conflist rompe cada ADD por igual.
¿Por qué no se puede descargar la imagen pause y cómo se soluciona?
“failed to get sandbox image” no aparece como ImagePullBackOff porque la imagen pause la gestiona containerd directamente, no tu spec del pod (una distinción que confunde a más de uno, seamos honestos). Pasa en nodos air-gapped o detrás de un proxy que containerd no ve.
El nombre de la imagen sale de la config de containerd. Revisalo con grep sandbox_image /etc/containerd/config.toml y probá el pull directo con crictl pull registry.k8s.io/pause:3.9. El fix es configurar el proxy en la unidad systemd de containerd (lee Environment=HTTPS_PROXY=… ahí, no en /etc/environment) o apuntar sandbox_image a un mirror interno, que es exactamente lo que hacen las AMI de EKS con su copia regional en ECR.
¿Qué otros errores de sandbox existen (timeout, nombre reservado, RuntimeClass)?
“context deadline exceeded” significa que containerd no respondió al kubelet dentro del timeout del CRI durante la llamada RunPodSandbox que describe el Sandbox API de containerd. La distinción importa: esto pasa cuando el runtime está sobrecargado, no cuando está roto, así que el criterio de diagnóstico cambia —no se trata de arreglar una configuración sino de aliviar presión sobre el nodo. Los sospechosos de siempre: un nodo con más de 100 pods en medio de un rollout, I/O saturado bajo /var/lib/containerd, o un CNI que se cuelga esperando una API cloud lenta.
¿Cómo se diagnostica? Mirando el nodo, no el pod: kubectl top node, iostat -x 5 3 en el nodo, y crictl info | jq '.status.conditions'.
El mensaje “name is reserved for” aparece cuando containerd ya tiene un sandbox con el mismo nombre, namespace y UID, casi siempre un leftover de un reinicio del kubelet. Se limpia a mano con crictl stopp <id> y crictl rmp <id>; el próximo sync del kubelet crea uno nuevo. Y “no runtime for gvisor is configured” es literal: el pod pide un RuntimeClass que ese nodo no tiene instalado. La solución es agregar un scheduling.nodeSelector en el RuntimeClass para que el scheduler nunca mande ese pod a un nodo sin el handler correspondiente. Tema relacionado: automatizar workflows con n8n y Render.
¿Cómo prevenir que un pod vuelva a quedar atascado en ContainerCreating?
Un pod que nunca arranca no dispara ninguna alerta de error rate, porque técnicamente no está fallando: está esperando para siempre. Hay que alertar sobre la capacidad que se agota, no sobre el síntoma. En EKS, aws-node expone su estado de IPAM por Prometheus en el puerto 61678, así que una regla del tipo awscni_total_ip_addresses - awscni_assigned_ip_addresses < 3 sostenida por 10 minutos y etiquetada por nodo te avisa antes de que el primer pod quede colgado.
Si administrás tu propia infraestructura de nodos y redes en Argentina y esto te suena a demasiado mantenimiento manual, un proveedor de cloud e infraestructura como donweb.com te saca buena parte de ese trabajo de encima.
Errores comunes al diagnosticar FailedCreatePodSandBox
- Confundirlo con un problema de imagen de la aplicación. La imagen pause la maneja el runtime, así que nunca vas a ver ImagePullBackOff acá aunque el problema sea justamente que no se puede descargar esa imagen.
- Subir el timeout del CRI en vez de investigar por qué el runtime está lento. Si el nodo está saturado de I/O o en medio de un rollout gigante, tocar el timeout solo pospone el síntoma; frená el rollout con maxSurge y maxUnavailable en su lugar.
- Reiniciar el pod en loop sin mirar el evento completo. Borrar el pod una y otra vez no arregla un warm pool agotado ni un token vencido, solo genera más ruido en los logs del nodo.
- Ignorar la columna NODE al listar los pods pendientes. Sin saber si el problema es de un nodo, una AZ o todo el clúster, terminás aplicando un fix de subred cuando en realidad era un solo DaemonSet caído (y viceversa).
Preguntas Frecuentes
¿Por qué un pod se queda en ContainerCreating?
Un pod queda en ContainerCreating cuando el kubelet ya lo asignó a un nodo pero el runtime todavía no terminó de armar el sandbox (el contenedor pause más el namespace de red) o de descargar la imagen de tu aplicación. Si además ves el evento FailedCreatePodSandBox, el bloqueo está específicamente en el armado del sandbox, antes de que tu contenedor llegue a arrancar.
¿Qué significa FailedCreatePodSandBox en Kubernetes?
Es el evento que registra containerd cuando falla el handshake de dos pasos para crear el entorno del pod: descargar la imagen pause y crear el sandbox, después llamar al plugin CNI para asignarle red. El texto del mensaje que acompaña al evento indica en cuál de esos dos pasos ocurrió el fallo.
¿Cómo soluciono el error failed to setup network for sandbox?
Ese mensaje siempre es un fallo del plugin CNI, no del runtime. El nombre del plugin que aparece en el texto (aws-cni, calico, cilium-cni, flannel) te dice dónde mirar: en EKS suele ser agotamiento de IPs, resuelto con prefix delegation; en Calico o Cilium suele ser un token vencido o el agente del CNI caído, resuelto reiniciando ese pod puntual del DaemonSet.
¿Cómo sé si el problema es del plugin CNI o del runtime del contenedor?
Se distingue por el texto del error: si contiene “failed to setup network for sandbox”, el sandbox ya se creó y el fallo es del CNI en el paso de asignar red. Cualquier otro mensaje (imagen pause, timeout, nombre reservado, RuntimeClass) ocurrió antes de que el CNI fuera siquiera invocado y apunta al runtime o a la configuración del nodo.
¿Qué hago si el pod muestra failed to get sandbox image pause?
Verificá primero qué imagen y qué registry está configurado con grep sandbox_image /etc/containerd/config.toml y probá el pull manual con crictl pull. Si el nodo está detrás de un proxy, configurá HTTPS_PROXY en la unidad systemd de containerd; si es un entorno air-gapped, apuntá sandbox_image a tu mirror interno y reiniciá containerd.
Conclusión
Un pod atascado en containercreating con FailedCreatePodSandBox no es un misterio si sabés leer el mensaje exacto del evento. La lógica es siempre la misma: primero identificar si el fallo es de red (CNI) o de runtime, después determinar el radio de impacto con la columna NODE, y recién ahí aplicar el fix puntual, sea prefix delegation, un reinicio del pod CNI o un ajuste de RuntimeClass.
Lo que cambia entre EKS, Calico y Cilium no es el diagnóstico, es dónde buscás las métricas. El resto del proceso (leer el evento, confirmar el alcance, mirar los logs del nodo con crictl y journalctl) es idéntico en cualquier clúster. Armá la alerta preventiva sobre capacidad de IPs antes de que te toque debuggear esto en producción un viernes a la tarde.