Subida segura de archivos a S3: presigned URL + ClamAV
En pocas palabras: Un pipeline seguro de carga a S3 combina tres capas: presigned URLs para que el cliente suba directo al bucket sin pasar por tu API, validación de magic bytes (no de extensión ni Content-Type) y escaneo con ClamAV dentro de una zona de cuarentena antes de aprobar el archivo.
Pensemos en un caso hipotético: armás un formulario de carga de foto de perfil, probás con un PNG de tu compu y todo joya. Pero un usuario le cambia la extensión a un ejecutable disfrazado de imagen y tu backend lo acepta sin chistar porque confió en el Content-Type que mandó el navegador. Ese es, justamente, el error que un pipeline de subida bien armado evita: separar “el archivo subió” de “el archivo es seguro”. Son dos cosas distintas y conviene no mezclarlas nunca.
La idea general es simple de enunciar y un poco más laboriosa de implementar: recibir el archivo sin que tu API actúe de intermediario, validar el contenido real —no la extensión ni el header que manda el cliente— y escanearlo con un antivirus antes de hacerlo disponible. El esquema combina presigned URLs de Amazon S3, detección de magic bytes y escaneo con ClamAV dentro de un flujo de cuarentena, tal como describe un artículo técnico en dev.to.
En este artículo:
- En 30 segundos
- El problema de confiar en el Content-Type
- Presigned URLs: que el cliente le hable directo a S3
- Magic bytes: la huella digital real del archivo
- Cuarentena y escaneo: nada se publica sin pasar por ahí
- El detalle que se olvida: escanear y aprobar el mismo objeto
- Reglas extra que conviene sumar
- Ejemplo hipotético: pensando el pipeline para una app de CVs
- Errores comunes al armar un pipeline de uploads
- Preguntas frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un presigned URL de S3 deja que el cliente suba directo al bucket, sin que tu API cargue el archivo en memoria ni gaste ancho de banda propio.
- El MIME type y la extensión vienen del cliente y se pueden falsificar; hay que chequear los magic bytes, la firma binaria real del archivo.
- Ningún archivo debería quedar disponible para descarga antes de pasar por una cuarentena con escaneo de ClamAV.
- Un worker en segundo plano (con BullMQ o SQS) hace el trabajo pesado de validar y escanear, para no bloquear al usuario con una request HTTP larga.
- Hay que escanear y aprobar el mismo objeto exacto: si alguien reemplaza el archivo entre el escaneo y la aprobación, el control no sirvió de nada.
El problema de confiar en el Content-Type
El header Content-Type lo genera el navegador del usuario, no tu servidor, y cualquiera puede mandarlo falso con una request armada a mano. Si tu validación es algo tan directo como if (file.mimetype === "image/png"), en realidad no estás validando nada: estás confiando en un dato que controla por completo quien te está subiendo el archivo.
El OWASP File Upload Cheat Sheet lo plantea sin vueltas: el Content-Type no debería usarse para seguridad, a lo sumo sirve para una validación rápida y no vinculante, del estilo “avisale al usuario antes de perder tiempo subiendo algo que no vamos a aceptar”. La validación que importa pasa en otro lado, que es el contenido real del archivo.
Presigned URLs: que el cliente le hable directo a S3
El patrón más habitual —recibir el archivo en el backend y después reenviarlo a S3— funciona, pero convierte a tu API en un cuello de botella innecesario: cada subida consume bandwidth propio y, si bufereás en memoria, también RAM por cada conexión simultánea. Un presigned URL cambia esa lógica de raíz. Le da al cliente permiso temporal para subir un objeto directo al bucket, sin que necesite credenciales de AWS ni tu backend tenga que tocar los bytes del archivo en ningún momento.
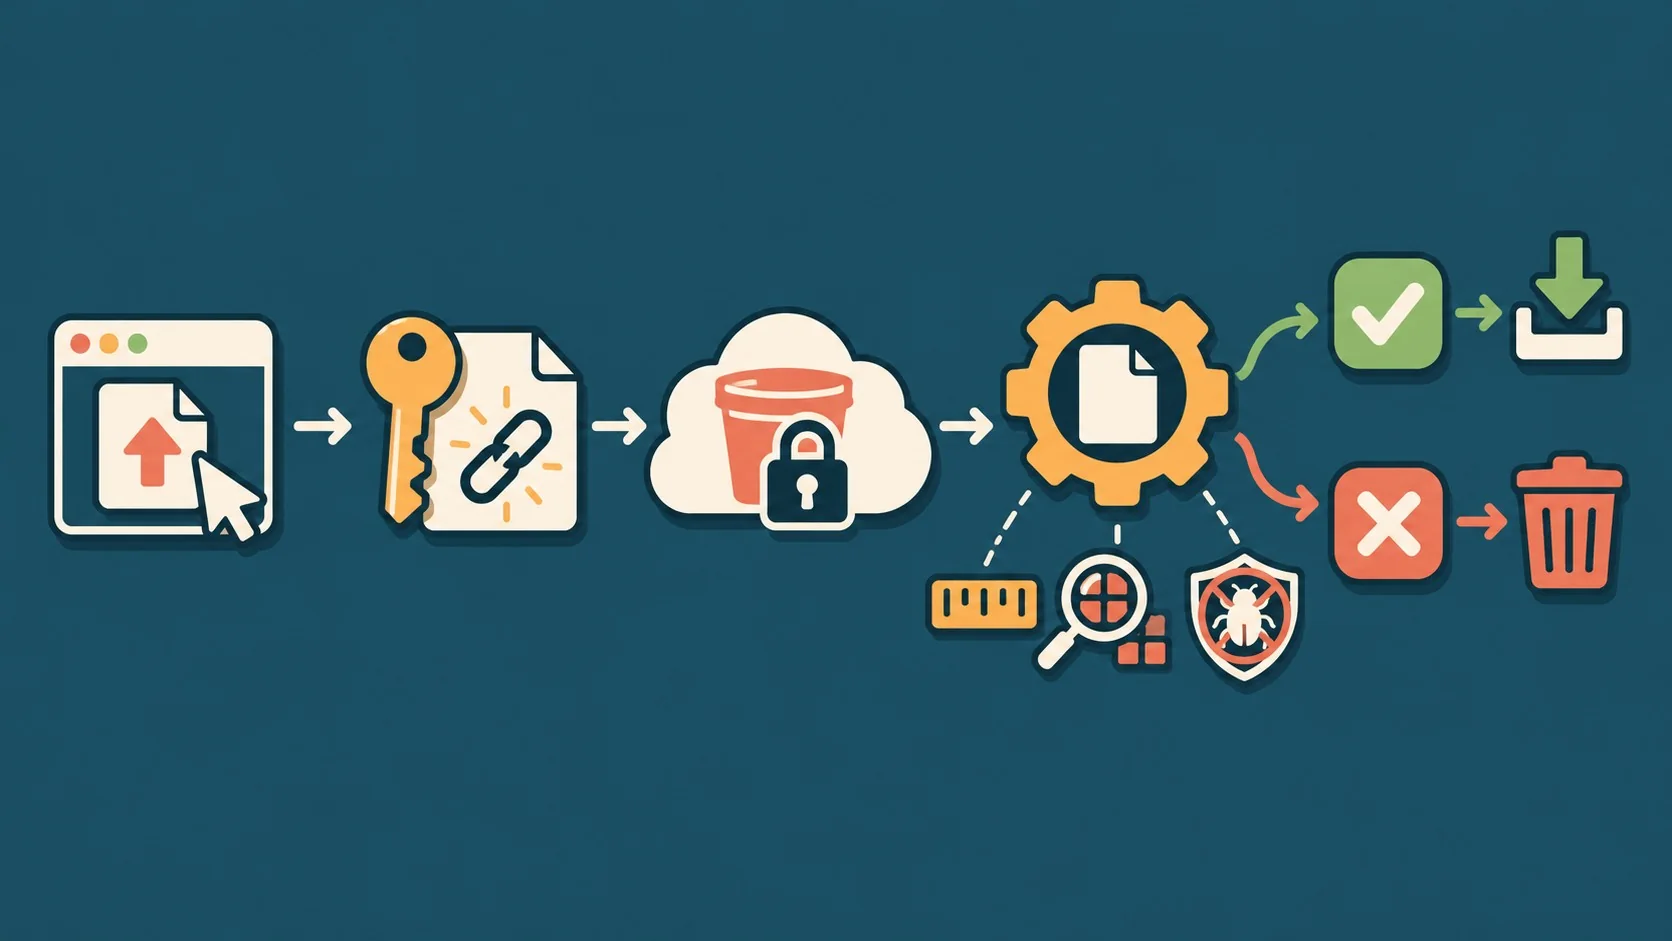
Con createPresignedPost del SDK v3 de AWS el flujo queda así: el cliente pide una URL, tu API chequea permisos y genera una que expira en pocos minutos (300 segundos en el ejemplo de la fuente), y el cliente sube directo a un bucket privado de cuarentena con un límite de tamaño ya fijado en las condiciones del POST. Tu API nunca ve el archivo; solo decide quién puede subir qué.
Según la documentación oficial de AWS, la expiración de un presigned URL puede extenderse hasta 7 días si usás el CLI o los SDKs. Que se pueda, sin embargo, no significa que convenga: para una subida de usuario final tiene mucho más sentido una ventana corta, de minutos, que reduzca la exposición si la URL llega a filtrarse o quedar cacheada en algún lado.
Un criterio simple para decidir la ventana de expiración: si el usuario está completando una acción en vivo (subir una foto, adjuntar un CV en un formulario), alcanza con una ventana de pocos minutos, porque la URL se genera y se usa casi en el mismo instante. Si en cambio es un proceso server-to-server, con un token que rota y un flujo más largo entre la generación y el uso efectivo, puede justificarse estirar un poco el plazo, pero igual conviene mantenerse lejos del máximo técnico que permite el proveedor. Cuanto más corta la ventana, menor la superficie de abuso.
Magic bytes: la huella digital real del archivo
Los magic bytes son una firma binaria al principio de un archivo que identifica su formato real, sin importar cómo lo hayan nombrado. Un PNG arranca siempre con la misma secuencia hexadecimal, pase lo que pase con el nombre o la extensión que le haya puesto quien lo subió.
| Formato | Firma (magic bytes) |
|---|---|
| PNG | 89 50 4E 47 0D 0A 1A 0A |
| JPEG | FF D8 FF |
| 25 50 44 46 2D | |
| ZIP | 50 4B 03 04 |
En Node.js, la librería file-type hace este chequeo con fileTypeFromBuffer, comparando los primeros bytes del archivo contra firmas conocidas. No hace falta descargar el objeto entero de S3 para esto: con un range request alcanza para leer el fragmento inicial que necesita el detector, lo cual también ahorra transferencia si el archivo resulta ser basura.
Ahora, un punto que conviene tener bien claro: validar los magic bytes no significa que el archivo esté limpio. Un PDF o una imagen con firma perfectamente válida puede seguir conteniendo un exploit contra el parser que lo procesa después —el caso típico es un lector de imágenes con una vulnerabilidad conocida—. La firma binaria filtra basura obvia (el ejecutable disfrazado de imagen del ejemplo del principio), pero no reemplaza el escaneo.
Cuarentena y escaneo: nada se publica sin pasar por ahí
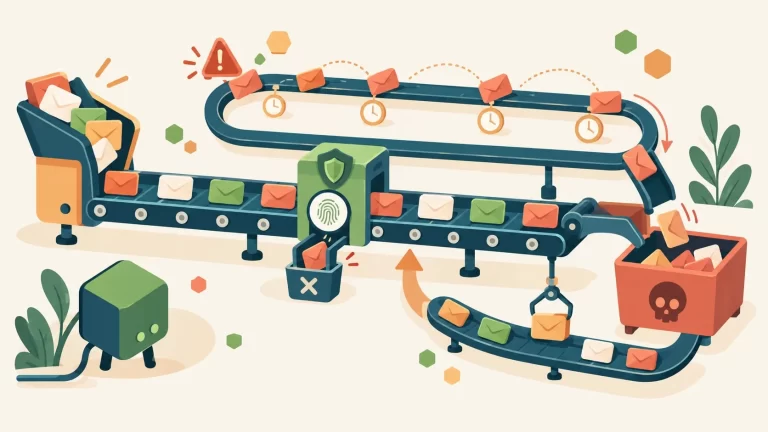
La idea de la cuarentena es retener el archivo en un bucket privado hasta que pasa validación de tamaño, magic bytes y escaneo antivirus, y recién ahí moverlo a un storage “aprobado” accesible para usuarios. El flujo completo, según lo describe la fuente, es: el cliente pide una URL al API, sube directo al bucket de cuarentena, S3 dispara un evento de storage que activa un worker en segundo plano, ese worker corre las tres validaciones, y según el resultado el archivo pasa a aprobado o queda rechazado. Nada llega al usuario final antes de pisar ese último estado. Más contexto sobre este tipo de amenazas en malware oculto en archivos aparentemente inofensivos.
Para el escaneo propiamente dicho, ClamAV es un motor antivirus de código abierto mantenido por Cisco Systems. En Node.js, el paquete clamscan se conecta a un servicio clamd corriendo por separado y expone un método scanStream para analizar el contenido directamente desde un stream, sin necesidad de bajar el archivo entero a disco primero.
El escaneo tarda, y nadie quiere a un usuario esperando adentro de una request HTTP mientras eso pasa. Por eso conviene una cola como BullMQ o AWS SQS: el evento de S3 dispara el job, el worker descarga o streamea el objeto correcto, lo escanea y actualiza el estado en la base de datos. El frontend, mientras tanto, puede mostrar algo tan simple como “procesando tu archivo”.
Hay una regla que no admite excepciones acá: si el escaneo falla, da timeout, o devuelve algo que no es un resultado claro, el archivo se queda en cuarentena. Nunca se aprueba por default solo porque el scanner no respondió a tiempo. Y aunque ClamAV reduce el riesgo de malware de forma real, su propia documentación no promete detectar cada amenaza posible —es una capa más dentro de una defensa en profundidad, no la solución completa.
El detalle que se olvida: escanear y aprobar el mismo objeto
Esto es fácil de pasar por alto y conviene marcarlo aparte. Si alguien sube un archivo limpio, el worker lo escanea, pero antes de que se apruebe otro archivo pisa la misma key en el bucket, el sistema terminaría aprobando contenido que nunca pasó por ClamAV. La forma de evitarlo es generar una key única por subida (con randomUUID() en el momento de crear el presigned URL) y no reutilizarla para nada más, además de apoyarse en versionado de bucket cuando esté disponible. Así, el objeto que se escanea es, siempre, el mismo objeto que se termina aprobando.
Reglas extra que conviene sumar
Más allá de presignear, validar magic bytes y escanear con ClamAV, hay un set de reglas operativas que vale la pena tener presentes desde el diseño inicial, no como parche después de un incidente:
- Límite de tamaño de archivo: no dejes subidas sin tope, definilo en las condiciones del presigned POST.
- Nombres de archivo aleatorios: generá keys con UUID en vez de confiar en el nombre que manda el usuario, así evitás colisiones y path traversal.
- Storage privado por defecto: los archivos aprobados no necesitan URL pública automática; usá descargas autorizadas cuando aplique.
- Rate limits y cuotas: autenticación obligatoria, límites por usuario y por tiempo.
- Protección contra ZIP bombs: limitá tamaño de extracción, cantidad de archivos y nivel de anidamiento dentro de un comprimido.
- Headers correctos al servir archivos: evitá entregar contenido subido por usuarios desde el dominio principal de tu aplicación.
- Monitoreo de rechazos: trackeá fallas de escaneo, errores del scanner y patrones raros de subida.
Un punto que se subestima bastante: nunca expongas tu servicio de ClamAV directo a internet. Dejalo accesible solo para los workers de confianza, adentro de tu red privada. Si parte de tu infraestructura corre en servidores propios en vez de depender exclusivamente de servicios administrados, vale la pena revisar proveedores de hosting cloud locales como donweb.com para alojar esos servicios internos (el worker, la cola, el clamd).
Ejemplo hipotético: pensando el pipeline para una app de CVs
Ejemplo hipotético, con fines ilustrativos: supongamos que una plataforma de búsqueda laboral necesita que los postulantes suban su CV en PDF. Aplicando los criterios de arriba, el diseño podría quedar así:
- Formato aceptado: solo PDF, porque es lo único que pide el negocio. No tiene sentido abrir la puerta a ZIP, DOCX o imágenes si nadie los necesita.
- Límite de tamaño: un CV normal no supera unos pocos megas, así que un tope de 5 MB en las condiciones del presigned POST ya cubre el caso de uso sin ser excesivo.
- Expiración del presigned URL: como la subida ocurre en el mismo momento en que el postulante completa el formulario, una ventana de 5 minutos alcanza de sobra.
- Validación: magic bytes contra la firma de PDF (
25 50 44 46 2D), rechazando cualquier cosa que no matchee, sin importar que el nombre del archivo diga “cv.pdf”. - Cuarentena y escaneo: el archivo entra a una carpeta privada, un worker dispara el escaneo con ClamAV, y recién si pasa limpio se mueve a un storage donde el reclutador puede descargarlo con una URL autorizada, nunca pública directa.
Es un ejemplo armado para mostrar cómo se combinan las piezas, no una implementación probada ni una recomendación cerrada para cualquier caso: cada aplicación real va a tener sus propios matices de volumen, compliance y tipos de archivo que conviene revisar aparte.
Errores comunes al armar un pipeline de uploads
- Validar solo el Content-Type del header: es el error número uno. Agregá siempre una verificación de magic bytes sobre el contenido real.
- Hacer disponible el archivo apenas termina la subida a S3: sin cuarentena, cualquier archivo infectado queda accesible desde el segundo cero.
- Exponer el servicio de ClamAV a internet: dejalo solo para la red interna de workers, nunca con IP pública abierta.
- Presignear URLs sin límite de tamaño ni expiración corta: una URL válida por días y sin tope de MB es una invitación a abusos.
Preguntas frecuentes
¿ClamAV detecta el 100% del malware subido por usuarios?
No. ClamAV reduce el riesgo de malware conocido, pero su propia documentación reconoce que no puede garantizar detección de cada variante, sobre todo en formatos de ejecutables empacados u obfuscados que cambian constantemente.
¿Hace falta una cola como BullMQ o SQS para escanear archivos?
Sí, si querés que el usuario no espere adentro de una request HTTP mientras corre el antivirus. Una cola permite disparar el escaneo como job asincrónico apenas S3 recibe el storage event, y reintentar si el worker falla.
¿Por qué no conviene recibir archivos directo en el backend en vez de usar S3?
Porque tu API se vuelve un intermediario que consume bandwidth y, si buferea en memoria, también RAM por cada subida simultánea. Con presigned URLs, el cliente sube directo a S3 y tu API solo administra permisos, nunca el tráfico del archivo en sí.
¿Por qué hay que escanear y aprobar exactamente el mismo objeto?
Porque si se permite reemplazar el archivo entre el momento del escaneo y el de la aprobación, un atacante podría colar un archivo malicioso en ese hueco. Usar keys únicas por subida y versionado de bucket evita que eso pase.
Conclusión
El punto central de todo este esquema es simple de decir y fácil de saltarse en la práctica: que un archivo suba no significa que sea confiable. Subirlo, validarlo por su contenido real y escanearlo son tres pasos distintos, y mezclarlos —aprobar apenas termina la subida, confiar en el Content-Type, exponer ClamAV sin red privada— es exactamente lo que abre la puerta a un incidente. Si estás armando o revisando un pipeline de uploads hoy, el checklist concreto es: presigná con expiración corta y límite de tamaño ajustado al caso de uso real, validá magic bytes antes de confiar en cualquier extensión, y nunca aprobés un archivo sin pasarlo por cuarentena y escaneo.