Troubleshooting Kubernetes Producción: el lab de JumpToTech
En pocas palabras: JumpToTech publicó el 29 de octubre de 2026 un lab de 3 a 4 horas que simula el incidente INC-2026-1042 en Kubernetes (EKS, kind o minikube): un Deployment sano pero un Service caído, resuelto con comandos read-only sobre la app ficticia Restaurant Company.
El troubleshooting de Kubernetes en producción es el proceso de diagnosticar y resolver fallas en aplicaciones que corren sobre un cluster de Kubernetes sin cortar el servicio a usuarios reales. El lab de JumpToTech, pensado para DevOps Engineers, Cloud Engineers y Site Reliability Engineers, simula ese proceso completo alrededor del ticket INC-2026-1042, “Restaurant Backend Service Unavailable”, prioridad P2, con una app ficticia llamada Restaurant Company: desde crear el Namespace y el Deployment hasta resolver un incidente de Service caído usando comandos read-only.
En este artículo:
- En 30 segundos
- ¿Cómo funciona el flujo completo de despliegue de una app en Kubernetes?
- ¿Qué hacen el Deployment Controller y el ReplicaSet Controller en Kubernetes?
- ¿Cómo se simula un incidente de troubleshooting kubernetes producción en este laboratorio de JumpToTech?
- Criterios de decisión: cómo priorizar los primeros diez minutos de un incidente así
- Ejemplo hipotético: cómo se vería este mismatch en un equipo real
- ¿Qué debe hacer un DevOps Engineer antes de tocar un recurso en producción?
- ¿Qué recursos arma el lab para reproducir el incidente?
- ¿Por qué falla la conexión entre el Service y los Pods en Kubernetes?
- ¿Qué stack de herramientas usa un equipo DevOps para soporte de producción?
- ¿Qué significa este tipo de lab para equipos DevOps en Latinoamérica?
- Errores comunes al hacer troubleshooting en Kubernetes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- JumpToTech publicó un lab hands-on de 3 a 4 horas para practicar troubleshooting kubernetes producción con un incidente simulado.
- El ticket INC-2026-1042 reporta “Restaurant Backend Service Unavailable”, P2, con el Deployment sano pero el Service sin responder.
- El entorno usa nginx:1.27, dos réplicas, namespace jumptotech-lab y un Service ClusterIP en el puerto 80.
- La causa típica del incidente es un mismatch entre las labels del Service y las de los Pods, no una falla del Deployment.
- Más abajo incluimos un criterio de triage y un ejemplo hipotético para aplicar la lógica del lab a un caso concreto.
¿Cómo funciona el flujo completo de despliegue de una app en Kubernetes?
El flujo arranca cuando un developer pushea código a GitHub y termina cuando el Service de Kubernetes actualiza sus endpoints disponibles. En el medio, GitHub Actions corre el pipeline de CI/CD, Docker construye la imagen, Amazon ECR la guarda, y la actualización llega al API Server para que el Deployment Controller, el ReplicaSet Controller y el Scheduler hagan su parte, según describe el lab de JumpToTech.
Subís el código, GitHub Actions corre los tests, Docker empaqueta la imagen, el pipeline la sube a Amazon ECR, el Deployment se actualiza con la versión nueva, el ReplicaSet Controller crea los Pods que faltan, el Scheduler decide en qué Worker Node van a vivir, kubelet arranca los contenedores junto al container runtime, y recién ahí el CNI configura la red para que el readinessProbe empiece a chequear si el Pod puede recibir tráfico.
El punto que más confunde a quien recién arranca con troubleshooting es justamente ese: un Pod puede estar “Running” sin estar “Ready”. Running solo confirma que el contenedor arrancó; Ready confirma que el readinessProbe pasó y que el Service puede mandarle tráfico. Son dos estados distintos, y la diferencia entre ambos es, según este lab, la causa más común de incidentes que parecen graves pero tienen una solución de un solo comando.
¿Qué hacen el Deployment Controller y el ReplicaSet Controller en Kubernetes?
El Deployment Controller administra los ReplicaSets y los rollouts de la aplicación, mientras que el ReplicaSet Controller garantiza que exista la cantidad de Pods declarada en el YAML. Son dos controladores de Kubernetes distintos que trabajan en cascada: uno decide la estrategia de actualización, el otro se asegura de que el número de réplicas nunca baje del valor configurado.
El resto de las piezas que mueve el lab son estas:
- API Server: es la puerta de entrada de la API de Kubernetes. Cuando corrés kubectl apply, kubectl le manda la configuración a él.
- etcd: guarda el estado completo del cluster, incluido el estado deseado de cada recurso.
- Scheduler: elige en qué Worker Node va cada Pod nuevo que todavía no tiene Node asignado.
- kubelet: es el agente que corre en cada Node y mantiene los Pods asignados junto al container runtime, como containerd.
- CNI: configura la red del Pod: interfaces, IPs y rutas, según el plugin que use el cluster.
- CoreDNS: resuelve los nombres DNS de los Services a sus IPs dentro del cluster.
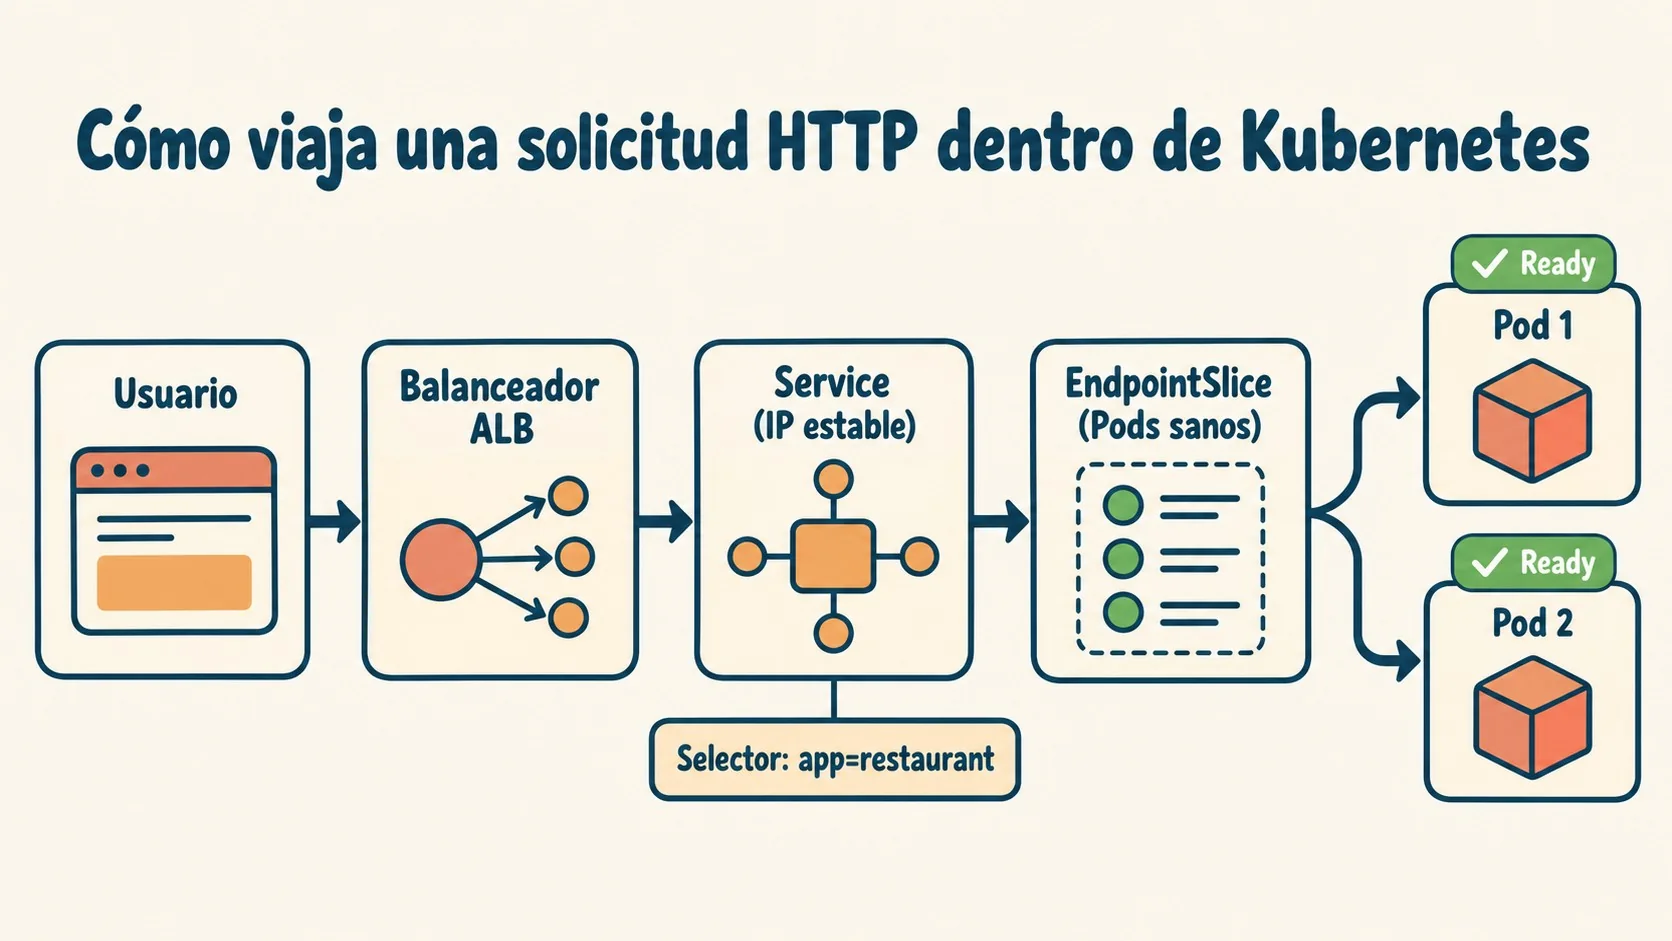
- EndpointSlices: publican qué Pods están disponibles como backend de un Service.
- kube-proxy: en los clusters que lo usan, mira Services y EndpointSlices para programar las reglas de red (en modo iptables, el Netfilter de Linux procesa esos paquetes).
¿Cómo se simula un incidente de troubleshooting kubernetes producción en este laboratorio de JumpToTech?
El lab arranca con el ticket INC-2026-1042, titulado “Restaurant Backend Service Unavailable”, prioridad P2, estado “Open – Investigating”. Los clientes reportan que la app de Restaurant Company no puede traer la info del backend, el monitoreo marca requests fallidos, y lo raro es que el Deployment aparece healthy mientras el Service no responde.
¿Y por qué importa ese detalle? Porque es justo el tipo de incidente que confunde a cualquiera: todo parece estar arriba, pero nada funciona (sí, pasa más seguido de lo que pensás).
El impacto de negocio, según plantea el lab de JumpToTech, es que los clientes no pueden ver la info de los restaurantes ni completar ciertos flujos de la app. La consigna para quien toma el ticket es simple: investigar, encontrar la causa raíz, restaurar el servicio y documentar todo.
Criterios de decisión: cómo priorizar los primeros diez minutos de un incidente así
Más allá de la secuencia de comandos del lab, lo que realmente separa a quien resuelve rápido de quien se pierde es el orden en que descarta hipótesis. Un criterio simple, basado en la lógica que propone el ejercicio, es ir de lo más barato de verificar a lo más costoso de cambiar:
| Síntoma observado | Hipótesis más probable | Primer comando (read-only) |
|---|---|---|
| Pods “Running” pero la app no responde | Running ≠ Ready; falta el readinessProbe o este falla | kubectl get pods -o wide |
| Deployment “healthy” pero Service sin tráfico | Mismatch entre selector del Service y labels del Pod | kubectl get endpointslices |
| EndpointSlices vacíos con Pods Ready | Selector mal escrito o labels distintas en el template | kubectl describe svc + kubectl get pods –show-labels |
| Todo coincide pero sigue sin responder | Problema de red (CNI, kube-proxy, DNS) | kubectl get events –sort-by=.lastTimestamp |
La regla de fondo: cada fila de esta tabla es más barata de descartar que la siguiente. Revisar labels con un describe toma segundos; auditar la capa de red del CNI puede llevar media hora. Por eso el lab insiste en empezar siempre por comandos read-only y de bajo costo antes de tocar nada.
Ejemplo hipotético: cómo se vería este mismatch en un equipo real
Nota: el siguiente escenario es un ejemplo hipotético con fines didácticos, construido sobre la lógica del lab de JumpToTech. No describe un incidente real ni una experiencia propia.
Imaginemos un equipo chico que entrena a un SRE junior corriendo este mismo lab en minikube. Al llegar al paso donde hay que crear el Service, el junior copia el YAML del Deployment para armar el template de Pod, pero comete un error de tipeo: en lugar de dejar la label como app: restaurant, la deja como app: restaurant-app. El Deployment aplica sin errores, los dos Pods quedan Running y Ready, y nada en los logs avisa del problema.
Siguiendo la tabla de criterios, el primer paso no es mirar logs de la aplicación: es correr kubectl get endpointslices -n jumptotech-lab -l kubernetes.io/service-name=restaurant-service. La lista vuelve vacía. Eso descarta un problema de red o de DNS y apunta directo al selector. Un kubectl get pods --show-labels confirma la diferencia entre restaurant y restaurant-app. Corregir la label en el template, reaplicar el Deployment y esperar a que el ReplicaSet reemplace los Pods resuelve el incidente sin necesidad de reiniciar nada más ni de tocar el Service.
El valor de este tipo de ejercicio no es memorizar el comando exacto, sino automatizar el orden en que se descartan hipótesis: primero el selector, después las labels, recién al final la red.
¿Qué debe hacer un DevOps Engineer antes de tocar un recurso en producción?
Antes de ejecutar cualquier comando, hay que reconocer el ticket, identificar la app y el entorno afectado, y revisar si hubo despliegues o cambios de infraestructura recientes. Recién después se arranca con comandos de diagnóstico read-only, y se comunica el estado de la investigación por Slack o Microsoft Teams antes de reiniciar nada.
- Reconocer el ticket: confirmar que estás a cargo de INC-2026-1042 y avisar que arrancaste la investigación.
- Identificar app y entorno: en este lab, Deployment restaurant, namespace jumptotech-lab, Service restaurant-service en el puerto 80 con 2 réplicas.
- Revisar cambios recientes: preguntar si hubo deploys o cambios de infra justo antes de que arrancara el incidente.
- Usar comandos read-only primero: kubectl get, kubectl describe, kubectl get events. Nada de borrar Pods todavía.
- Comunicar el estado: un mensaje tipo “reconocí el INC-2026-1042, estoy revisando Deployment, readiness y endpoints, doy update en 10 minutos” evita que medio equipo te pregunte lo mismo por separado.
Esa secuencia es la base de cualquier troubleshooting kubernetes producción serio. No tocás nada hasta entender qué pasó.
¿Qué recursos arma el lab para reproducir el incidente?
El ejercicio completo parte de crear un Namespace (jumptotech-lab), un Deployment (restaurant, imagen nginx:1.27, 2 réplicas, readinessProbe sobre el puerto 80) y un Service ClusterIP (restaurant-service, selector app: restaurant, port 80, targetPort 80). Cada paso se verifica con kubectl get y kubectl describe antes de avanzar al siguiente, y el incidente se dispara más adelante introduciendo justamente el tipo de desalineación entre selector y labels que describimos en el ejemplo hipotético anterior.
Lo que vale la pena remarcar es que el YAML en sí mismo no es lo interesante: cualquiera lo copia y lo adapta. Lo que el lab fuerza a practicar es la secuencia de verificación entre cada paso —algo que, en un cluster real, es fácil de saltear cuando todo “parece” funcionar a simple vista.
¿Por qué falla la conexión entre el Service y los Pods en Kubernetes?
La causa más común de un Service que no responde pese a tener Pods Running es un mismatch entre el selector del Service y las labels de los Pods. Si el Service busca app: restaurant y el Pod tiene una label distinta, o ninguna, el EndpointSlice Controller no publica ningún backend. Ahí es donde revienta este incidente simulado.
¿Alguien lo chequeó con kubectl get endpointslices? Ese es justo el comando que destapa el problema: si la lista viene vacía, no hay backend conectado, aunque los Pods figuren Ready.
Para confirmarlo sin asumir nada, conviene correr kubectl describe svc restaurant-service -n jumptotech-lab y comparar el selector contra las labels reales de los Pods con kubectl get pods –show-labels. Es un chequeo rápido que evita horas perdidas mirando logs que no tienen nada que ver con el problema real.
¿Qué stack de herramientas usa un equipo DevOps para soporte de producción?
El lab de JumpToTech asume un stack típico de empresa mediana: GitHub y GitHub Actions para código y CI/CD, Docker y Amazon ECR para las imágenes, Amazon EKS y kubectl para la infraestructura, y Prometheus, Grafana y Amazon CloudWatch para monitoreo. La gestión de incidentes corre por Jira o ServiceNow, con la comunicación en Slack o Microsoft Teams.
| Herramienta | Categoría | Para qué se usa |
|---|---|---|
| GitHub | Código fuente | Repositorio de la aplicación |
| GitHub Actions | CI/CD | Automatización de build y tests |
| Docker | Empaquetado | Construcción de imágenes de contenedor |
| Amazon ECR | Registro | Almacenamiento de imágenes de contenedor |
| Amazon EKS | Orquestación | Kubernetes administrado |
| kubectl | Administración | Gestión del cluster |
| Jira / ServiceNow | Incident management | Tickets de incidentes |
| Slack / Microsoft Teams | Comunicación | Coordinación del equipo durante el incidente |
| Prometheus | Observabilidad | Métricas de app e infraestructura |
| Grafana | Observabilidad | Dashboards de monitoreo |
| Amazon CloudWatch | Observabilidad | Monitoreo y logs en AWS |
| CoreDNS | Red | DNS interno del cluster |
| AWS ALB | Red | Ruteo HTTP/HTTPS externo |
Otras empresas combinan piezas distintas (Azure, Google Cloud, Datadog en vez de CloudWatch), pero los conceptos de fondo no cambian.
¿Qué significa este tipo de lab para equipos DevOps en Latinoamérica?
Para un equipo chico en Argentina o la región, este simulacro vale más que la teoría sola: obliga a practicar la secuencia completa de troubleshooting kubernetes producción sin arriesgar un cluster real. El ejercicio se corre gratis con kind o minikube en una notebook, sin necesidad de cuenta de AWS.
Si tu equipo corre esos clusters sobre infraestructura propia en Argentina, donweb.com es una opción local para esa capa de VPS o cloud, aunque el lab en sí no depende de ningún proveedor en particular.
Errores comunes al hacer troubleshooting en Kubernetes
- Asumir que “Pods Running” significa que todo funciona: Running solo dice que el contenedor arrancó, no que el readinessProbe esté pasando ni que el Service tenga endpoints activos.
- Reiniciar Pods antes de investigar: borrar un Pod sin entender la causa puede tapar el síntoma un rato, pero el problema real vuelve en el próximo incidente.
- No verificar el contexto del cluster: correr comandos contra el cluster equivocado, producción en vez de staging, es un error que cualquiera que haya usado kubectl config use-context se topó alguna vez.
- Ignorar las labels al armar el Service: un selector mal escrito o labels inconsistentes entre el Deployment y el Pod template rompen la conexión sin que ningún log lo avise de forma directa, como en el ejemplo hipotético de más arriba.
- No comunicar el avance de la investigación: dejar a developers y al incident commander sin updates genera ruido y gente duplicando el mismo diagnóstico en paralelo.
Preguntas Frecuentes
¿Qué es el troubleshooting de Kubernetes en producción?
Es el proceso de diagnosticar y resolver fallas en aplicaciones que corren en un cluster de Kubernetes sin cortar el servicio a los usuarios. Incluye revisar Pods, Deployments, Services y EndpointSlices con comandos read-only antes de aplicar cualquier cambio, y documentar la causa raíz una vez resuelto el incidente.
¿Cómo diagnosticás errores HTTP en un cluster de Kubernetes?
Primero revisás si los Pods están Running y Ready con kubectl get pods, después chequeás que el Service tenga EndpointSlices activos con kubectl get endpointslices, y recién ahí mirás logs de la app o del Ingress/ALB. Un error HTTP sin backend conectado casi siempre es un problema de selector o de labels, no de la aplicación en sí.
¿Qué incluye el JumpToTech DevOps Bootcamp?
El lab de JumpToTech incluye un ejercicio práctico de 3 a 4 horas donde armás un Namespace, un Deployment y un Service de Kubernetes desde cero, y después resolvés un incidente simulado (INC-2026-1042) de Service backend caído. Corre en Amazon EKS, kind o minikube, y suma preguntas de entrevista técnica sobre cada componente del cluster.
¿Qué es un ReplicaSet y para qué sirve en Kubernetes?
Un ReplicaSet es el recurso de Kubernetes que garantiza que exista la cantidad exacta de réplicas de un Pod declarada en el Deployment. Si un Pod se cae o un Node falla, el ReplicaSet Controller crea uno nuevo automáticamente para mantener el número configurado, en el lab de JumpToTech, dos réplicas.
¿Cómo revisás si un Service está conectado a los Pods correctos?
Corré kubectl get endpointslices -n <namespace> -l kubernetes.io/service-name=<nombre-del-service> y fijate si devuelve IPs de Pods. Si la lista viene vacía, comparás el selector del Service con las labels de los Pods usando kubectl describe svc y kubectl get pods –show-labels para encontrar el mismatch.
Conclusión
El lab de JumpToTech no inventa nada nuevo sobre Kubernetes, pero ordena algo que casi nadie practica con disciplina: la secuencia completa de troubleshooting kubernetes producción, desde el primer mensaje de Slack hasta el comando que confirma la causa raíz. Lo valioso no es el YAML, ese lo copiás de cualquier lado, es forzarte a pasar por un incidente simulado sin la presión de un cluster real roto, aplicando un criterio de triage —de lo más barato de verificar a lo más costoso de cambiar— en lugar de adivinar.
Si tu equipo recién está armando esa disciplina, probar este ejercicio con kind o minikube en una tarde sale gratis y deja mejor preparado al próximo que tome la guardia.