Cómo armar una arquitectura AWS de producción real
En pocas palabras: Una arquitectura AWS de producción combina load balancer, VPC con subredes públicas y privadas, Auto Scaling, RDS, IAM y CloudWatch para eliminar puntos únicos de falla. Sin esa separación, según el desglose técnico de dev.to del 13 de septiembre de 2026, un solo EC2 caído tumba toda la aplicación.
Armás un EC2, instalás la app, todo funciona en el navegador y pensás que ya tenés una arquitectura AWS producción lista. La verdad se descubre el primer día de tráfico real: sin load balancer, sin subredes separadas y sin Auto Scaling, esa misma instancia se convierte en el único punto de falla de todo el sistema, según el desglose técnico publicado en dev.to el 13 de septiembre de 2026.
Una arquitectura AWS de producción es el conjunto de servicios de Amazon Web Services (EC2, S3, RDS, VPC, IAM y CloudWatch) organizados para correr una aplicación segura, escalable y monitoreada, en lugar de usarse cada uno por separado. El objetivo no es sumar servicios por currículum: es que la app soporte picos de tráfico, aísle las capas sensibles y se recupere ante fallas sin que alguien tenga que reiniciar servidores a mano a las tres de la mañana.
En este artículo:
- En 30 segundos
- ¿Por qué no alcanza con aprender los servicios de AWS por separado?
- ¿Cómo viaja una petición del usuario hasta la aplicación?
- ¿Por qué no conviene exponer EC2 directamente a internet?
- ¿Cómo se estructura una VPC con subredes públicas y privadas?
- ¿Cómo controlar el tráfico entre capas con Security Groups?
- ¿Cómo funciona el Auto Scaling en AWS?
- Ejemplo hipotético: qué pasaría con un pico de tráfico un viernes a la noche
- ¿Qué diferencia hay entre S3 y RDS para almacenar datos?
- ¿Cómo aplicar el principio de menor privilegio con IAM?
- ¿Cómo monitorear la salud del sistema y reaccionar ante incidentes?
- ¿Cómo automatizar la infraestructura con Terraform, Docker y CI/CD?
- ¿Cuándo conviene sumar cada capa? Criterios de decisión
- Errores comunes al armar una arquitectura AWS de producción
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El load balancer, no el EC2, debe ser el punto de entrada desde internet.
- Una VPC con subredes públicas y privadas separa lo que se expone de lo que no.
- Auto Scaling puede llevar la capacidad de 2 a 4 y hasta 6 instancias según el tráfico.
- RDS guarda datos estructurados; S3 guarda objetos como imágenes, videos y backups.
- IAM aplica el principio de menor privilegio: cada componente accede solo a lo que necesita.
¿Por qué no alcanza con aprender los servicios de AWS por separado?
Porque en un proyecto real esos servicios no trabajan solos: resuelven un solo problema en conjunto, que es correr una app segura, confiable y escalable. Estudiar EC2 por un lado, S3 por otro y VPC en otro capítulo aparte deja al profesional con piezas sueltas y ninguna idea de cómo encajan entre sí, que es justo el problema que suele aparecer cuando alguien rinde una certificación pero nunca armó un entorno de punta a punta.
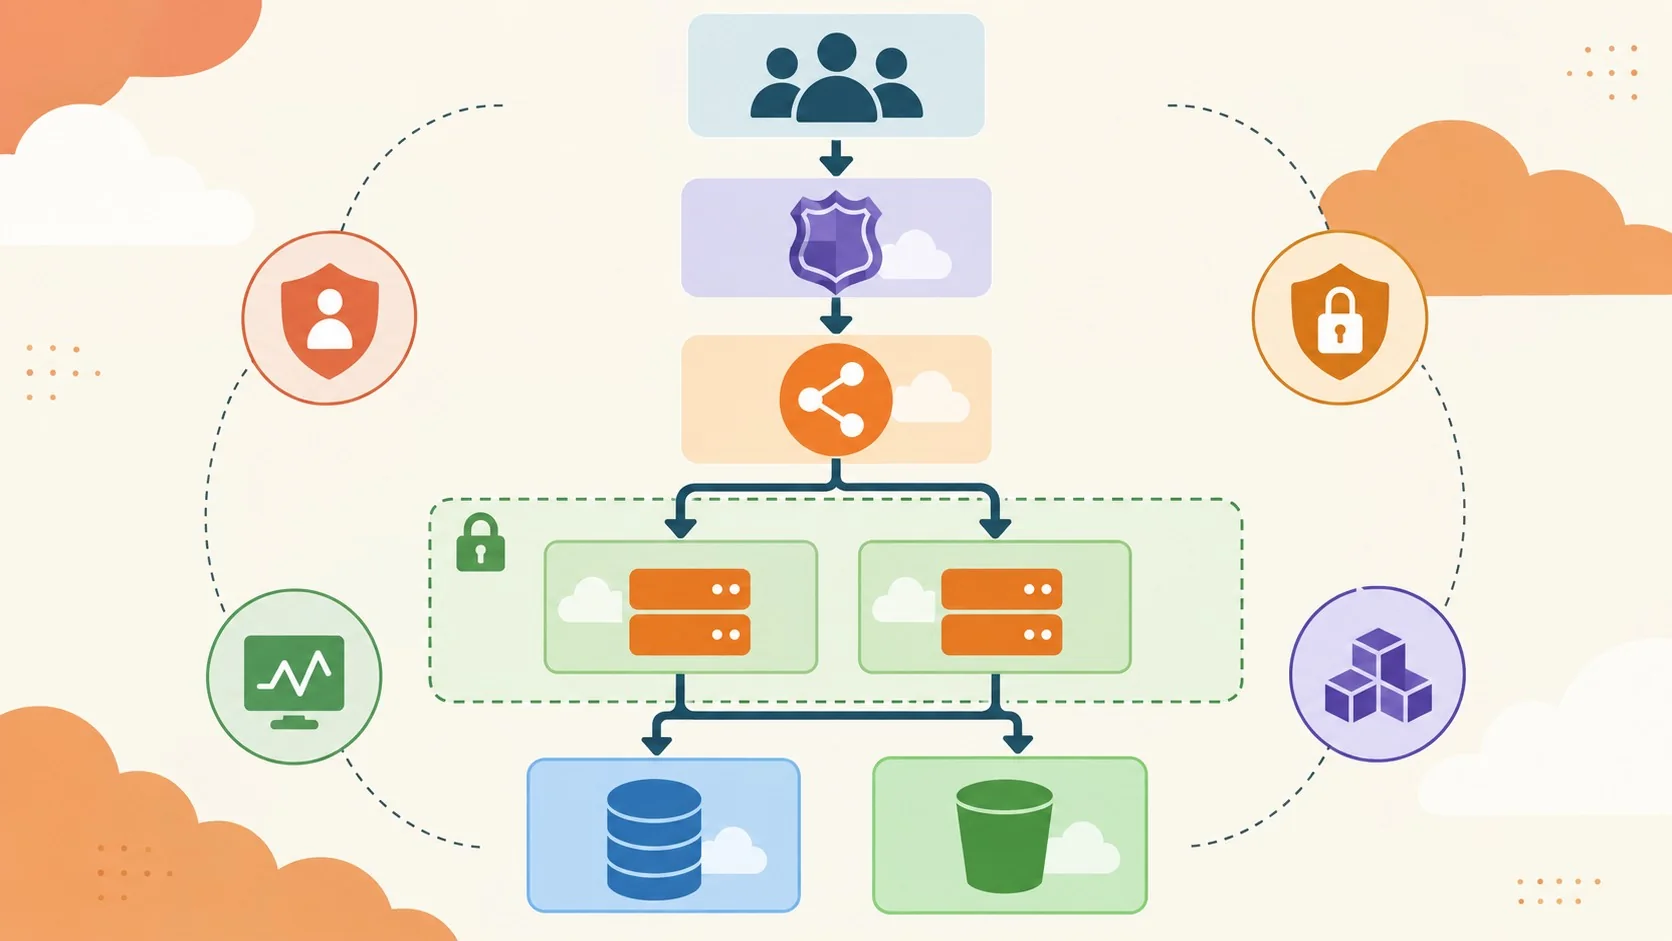
El flujo completo que propone la fuente es: el usuario llega vía DNS, pasa por un load balancer, ese balanceador reparte carga entre servidores de aplicación, y esos servidores hablan con RDS para datos estructurados y con S3 para archivos. Atrás de todo eso corren IAM, VPC, Security Groups, CloudWatch y, si el equipo maduró un poco, Terraform y CI/CD. Ninguna pieza sirve de mucho aislada.
¿Cómo viaja una petición del usuario hasta la aplicación?
La petición arranca cuando alguien tipea myapp.com y termina resuelta por DNS, que traduce ese nombre en la dirección real donde vive la infraestructura de AWS. Ese primer salto (usuario → DNS → infraestructura AWS) parece trivial, pero es el punto donde arranca todo diagnóstico cuando algo anda mal: si te salteás este paso al investigar un incidente, terminás mirando logs de la aplicación cuando el problema estaba tres capas antes.
Ponele que un usuario reporta que el sitio no carga. Lo primero que hay que descartar es si el problema está en DNS antes de sospechar del código. Más contexto en configurar correctamente tus servidores DNS autoritativos.
¿Por qué no conviene exponer EC2 directamente a internet?
Porque convierte a esa instancia en el único punto de contacto con el mundo exterior y, si se cae, la app entera queda offline. El esquema de principiante es Internet → EC2 → Aplicación; funciona en una demo, pero no resiste el primer mantenimiento programado ni el primer pico real.
La alternativa que recomienda la fuente es Internet → Load Balancer → Application Servers. El balanceador se convierte en la puerta de entrada y los servidores de aplicación dejan de recibir tráfico crudo directamente desde internet. Esto no es una preferencia estética: es lo que permite después sumar instancias, sacarlas de servicio para mantenimiento o reemplazarlas sin que el usuario final note nada.
¿Cómo se estructura una VPC con subredes públicas y privadas?
Una VPC es la red virtual aislada donde viven los recursos de AWS, y dentro de ella se crean subredes públicas para lo que necesita ser accesible desde internet (como el load balancer) y subredes privadas para lo que no (aplicación y base de datos). El principio, tomado de la fuente, es simple: exponer solo lo que necesita ser expuesto.
En la práctica, esto significa que el load balancer vive en subred pública, los servidores de aplicación en subred privada, y la base de datos queda todavía más aislada, sin ruta directa hacia internet. Nadie desde afuera puede tocar la base de datos ni los servidores de aplicación de forma directa: todo pasa primero por el balanceador.
¿Cómo controlar el tráfico entre capas con Security Groups?
Los Security Groups definen quién puede hablar con quién, y el modelo recomendado reemplaza “todos hablan con todos” por un camino controlado: origen permitido → destino permitido → puerto permitido. El load balancer acepta tráfico web, la aplicación acepta tráfico solo del load balancer, y la base de datos acepta tráfico solo de la capa de aplicación. Para más detalles técnicos, mirá elegir la herramienta de CI/CD adecuada.
Este esquema en cadena es lo que impide que, si alguien compromete un servidor de aplicación, tenga automáticamente vía libre hacia la base de datos completa. Cada salto necesita su propia regla explícita, y ese “trabajo extra” de configurar reglas puntuales por capa es justamente lo que después te ahorra un incidente de seguridad grande.
¿Cómo funciona el Auto Scaling en AWS?
Auto Scaling ajusta la cantidad de instancias EC2 según reglas de tráfico definidas, típicamente pasando de 2 instancias en tráfico normal a 4 o incluso 6 cuando la demanda sube, según el ejemplo de la fuente. La lógica es directa: menos tráfico, menos capacidad; más tráfico, más capacidad, sin que alguien tenga que estar mirando un dashboard a las 3 AM para lanzar una instancia manualmente.
Antes de llegar a eso, el paso intermedio es tener múltiples instancias detrás del load balancer en lugar de una sola. Si una instancia falla, las otras siguen respondiendo. Recién con esa base tiene sentido automatizar el escalado. ¿Y qué pasa si dependés de una sola instancia sin backup? Exacto: cualquier reinicio de mantenimiento te deja sin servicio.
Ejemplo hipotético: qué pasaría con un pico de tráfico un viernes a la noche
Nota: el siguiente escenario es hipotético, pensado para ilustrar cómo interactúan las capas descriptas arriba. No corresponde a un caso real reportado por la fuente ni por Donweb.
Imaginá una app de e-commerce chica corriendo con la arquitectura que venimos armando: load balancer, dos EC2 en subred privada, RDS y S3. Una campaña en redes sociales un viernes a la noche multiplica el tráfico por cuatro en veinte minutos.
Con Auto Scaling configurado, el escenario se ve así: CloudWatch detecta que el CPU promedio de las dos instancias cruza el umbral definido, dispara la política de escalado, y en pocos minutos la capacidad pasa de 2 a 4 instancias, quizás a 6 si el pico sigue subiendo. El load balancer redistribuye las conexiones nuevas hacia las instancias recién levantadas y, desde afuera, nadie nota nada raro.
Sin Auto Scaling, el mismo pico termina distinto: las dos instancias originales se saturan, el tiempo de respuesta sube, algunos requests empiezan a fallar por timeout, y el equipo se entera por las alertas de CloudWatch (en el mejor caso) o por quejas en redes sociales (en el peor). La diferencia entre un escenario y otro no está en la promoción que generó el pico: está en si la capa de escalado ya estaba lista de antes o si hay que improvisarla en caliente mientras el sitio se cae.
¿Qué diferencia hay entre S3 y RDS para almacenar datos?
RDS es un servicio de base de datos administrada pensado para datos estructurados con necesidades de backups, disponibilidad y performance; S3 es almacenamiento de objetos pensado para archivos como imágenes, videos, documentos y backups. Guardar miles de fotos de perfil directamente en el disco de un EC2, cosa que mucha gente todavía hace en sus primeros proyectos, no es la arquitectura correcta.
| Aspecto | RDS | S3 |
|---|---|---|
| Tipo de dato | Estructurado (tablas, filas) | Objetos (archivos) |
| Caso de uso típico | Usuarios, transacciones, registros de la app | Imágenes, videos, documentos, backups |
| Preocupaciones clave | Backups, disponibilidad, recuperación, performance | Durabilidad, costo por almacenamiento, acceso |
| Acceso desde la app | Consultas SQL vía conexión a base de datos | Lectura/escritura de objetos vía API |
Separar estas dos capas no es un capricho: cada servicio resuelve un problema distinto, y mezclarlas termina generando cuellos de botella difíciles de diagnosticar después. Ya lo cubrimos antes en comparar Jenkins y GitHub Actions antes de decidir.
¿Cómo aplicar el principio de menor privilegio con IAM?
El principio de menor privilegio significa darle a cada componente solo los permisos que necesita para su tarea, nunca acceso completo a la cuenta de AWS. Si tu app solo necesita leer archivos de un bucket S3 específico, ese es el permiso que le das, no acceso total a S3 ni mucho menos a toda la cuenta.
La pregunta que propone la fuente para cualquier ingeniero es directa: “¿este componente realmente necesita este permiso?”. Aplicarla de forma sistemática, cada vez que se crea un rol IAM, evita el escenario clásico donde una credencial filtrada termina comprometiendo mucho más de lo que debería.
¿Cómo monitorear la salud del sistema y reaccionar ante incidentes?
Monitorear significa tener visibilidad sobre CPU, memoria, cantidad de requests, tiempo de respuesta, tasa de errores, logs de la aplicación y performance de la base de datos, típicamente centralizado en CloudWatch. Sin esto, según plantea la fuente, estás operando el sistema a ciegas.
Cuando llega el reporte de “el sitio está lento”, el error común es reiniciar servidores sin investigar. El camino correcto sigue la ruta de la petición: DNS, load balancer, aplicación, base de datos, dependencias externas. En cada tramo hay que preguntarse si el tráfico subió de golpe, si el balanceador está sano, si los servidores están sobrecargados, si la base de datos responde lento o si hubo un deploy reciente. Un incidente de producción no se resuelve memorizando comandos: se resuelve buscando evidencia y encontrando la causa raíz.
¿Cómo automatizar la infraestructura con Terraform, Docker y CI/CD?
Terraform permite representar VPC, subredes, Security Groups, instancias y bases de datos como código versionable, en lugar de crear cada recurso a mano y no poder reproducirlo después. Docker empaqueta la aplicación con sus dependencias y runtime en una imagen consistente que corre igual en desarrollo, testing, staging y producción. CI/CD conecta ambas cosas: un push a Git dispara tests, build de la imagen Docker y deploy automático hacia AWS. Relacionado: implementar hreflang si tu app es multiidioma.
Ojo con Kubernetes acá: la fuente es clara en que no conviene aprenderlo porque está de moda. Tiene sentido cuando ya manejás muchos contenedores y administrarlos a mano se volvió inmanejable, no antes. Meterlo en un proyecto chico solo suma complejidad operativa sin resolver ningún problema real que tengas hoy.
¿Cuándo conviene sumar cada capa? Criterios de decisión
- Load balancer: sumalo apenas tengas más de una instancia, o antes si no podés permitirte downtime durante un mantenimiento.
- Subredes públicas y privadas: armalas desde el día uno del proyecto; no cuesta más hacerlo así de entrada, y migrar recursos en producción después es mucho más trabajo.
- Auto Scaling: tiene sentido cuando el tráfico varía de forma reconocible (franja horaria, día de la semana, campañas puntuales) más que cuando se mantiene parejo todo el tiempo.
- RDS en vez de una alternativa más simple: conviene en cuanto el modelo de datos tiene relaciones entre tablas que necesitás consultar; quedate con algo más simple solo si de verdad no las necesitás.
- Terraform: vale la pena apenas armaste el entorno más de una vez a mano y ya perdiste tiempo tratando de recordar qué habías clickeado la vez anterior.
Errores comunes al armar una arquitectura AWS de producción
- Exponer EC2 directamente a internet. Sin load balancer de por medio, cualquier caída de esa instancia tira abajo toda la aplicación.
- Mezclar subredes públicas y privadas sin criterio. Poner la base de datos en subred pública “porque es más fácil” anula toda la protección de red que da la VPC.
- Dar permisos IAM amplios “para que funcione”. Es más rápido en el momento, pero convierte cualquier filtración de credenciales en un incidente de cuenta completa.
- Guardar archivos en el disco del servidor de aplicación. Escala mal, complica los backups y no sobrevive a un reemplazo de instancia.
- No tener monitoreo hasta que algo se rompe. Configurar CloudWatch después del primer incidente serio es tarde: para entonces ya perdiste la data del momento exacto en que empezó el problema.
Preguntas Frecuentes
¿Qué servicios mínimos necesita una arquitectura AWS de producción?
El mínimo funcional incluye DNS, un load balancer, al menos dos instancias EC2 en subred privada, RDS para datos estructurados, S3 para archivos, una VPC con Security Groups configurados e IAM con permisos acotados. CloudWatch para monitoreo no es opcional si el sistema va a recibir tráfico real.
¿Cuál es la diferencia entre una arquitectura de desarrollo y una de producción en AWS?
En desarrollo suele alcanzar con una sola instancia EC2 sin balanceador ni separación de subredes, porque el objetivo es probar funcionalidad rápido. En producción se agregan load balancer, múltiples instancias, VPC con subredes públicas y privadas, Auto Scaling y monitoreo, porque ahí sí importa la disponibilidad y la seguridad frente a usuarios reales.
¿Por qué separar subredes públicas y privadas en AWS?
Para exponer solo lo que necesita ser accesible desde internet, típicamente el load balancer, y mantener aislados los servidores de aplicación y la base de datos. Esto reduce la superficie de ataque porque nadie desde afuera puede conectarse directo a los recursos que viven en subred privada.
¿Cuándo conviene usar Auto Scaling en lugar de instancias fijas?
Cuando el tráfico de la aplicación varía de forma significativa a lo largo del día o entre picos puntuales, en lugar de mantenerse estable. Auto Scaling ajusta la capacidad, por ejemplo de 2 a 4 o 6 instancias, según demanda, evitando tanto la sobrecarga en picos como el gasto innecesario en horarios de bajo tráfico.
¿Es necesario usar Terraform desde el primer proyecto en AWS?
No es obligatorio para un proyecto de aprendizaje, pero sí conviene apenas la infraestructura empieza a recrearse más de una vez. Terraform permite versionar VPC, redes, seguridad y cómputo como código, evitando que la reconstrucción del entorno dependa de la memoria de una sola persona sobre qué clickeó la vez anterior.
Conclusión
El error más común al aprender AWS es memorizar servicios sueltos en lugar de entender cómo se conectan para resolver un problema concreto. La arquitectura que describe la fuente (DNS, load balancer, EC2 en subred privada con Auto Scaling, RDS, S3, IAM y CloudWatch, con Terraform y CI/CD encima) no es un listado de tecnologías de moda: es la respuesta a preguntas puntuales como qué pasa si una instancia se cae, quién puede acceder a qué, y cómo se recupera el sistema cuando algo falla. Si estás armando tu primer proyecto serio en AWS, la recomendación práctica es construir esa cadena paso a paso, probando cada capa antes de sumar la siguiente, en vez de copiar una plantilla completa sin entender para qué sirve cada pieza.