Health checks degradados en Node.js: la guía
En pocas palabras: Un health check degradado en Node.js debe cachear la validez de la credencial y el tier de la cuenta, devolver ready, degraded o not_ready, y calcular el tiempo de caducidad según un techo de gasto: por ejemplo, cinco segundos si dos nodos admiten 20 unidades por segundo cada uno con un límite de 200 unidades sin verificar.
Un health check degradado en Node.js separa el estado del proceso (liveness) de la capacidad real de facturar uso (readiness), cachea la validez de la credencial y el tier de la cuenta, y usa un techo de gasto para decidir cuándo dejar de aceptar tráfico no verificado. Así lo plantea una nota técnica publicada el 17 de septiembre de 2026 en dev.to, pensada para servicios que cobran por consumo.
¿Por qué te tendría que importar esto si ya tenés un /health que responde 200? Porque “responde 200” no dice nada sobre si tu servicio puede facturar el próximo request sin arriesgarte a un descuadre de facturación. Un health check es un endpoint HTTP que un orquestador consulta para decidir si un proceso recibe tráfico. En una API que mide uso por cliente, ese endpoint no puede limitarse a responder “vivo” o “muerto”: tiene que reportar si la credencial de cuenta sigue siendo válida y si el tier contratado habilita la capacidad que se le va a pedir en el próximo request.
En este artículo:
- En 30 segundos
- ¿Por qué un servicio Node.js puede estar “vivo” pero no listo para recibir tráfico?
- ¿Qué diferencia hay entre los estados ready, degraded y not_ready en los health checks de Node.js?
- ¿Cómo se calcula la ventana de tolerancia a partir del techo de gasto?
- ¿Qué preguntas responder antes de fijar tu propio techo de gasto b?
- ¿Cómo evitar que un timeout tire todos los nodos a not_ready?
- ¿Qué datos no debe exponer nunca un endpoint de salud?
- Errores comunes al implementar health checks degradados
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El endpoint /ready debe reportar el último estado de capacidad verificado, no llamar a la API de cuenta en cada request.
- Los tres estados posibles son ready, degraded y not_ready, cada uno con una decisión de enrutamiento distinta.
- La ventana de tolerancia (staleness) se calcula con la fórmula b/r: unidades de exposición permitidas dividido la tasa de admisión.
- Con 2 nodos a 20 unidades por segundo cada uno y un techo de 200 unidades, la ventana máxima sale en 5 segundos.
- El body de /ready nunca debe incluir token, ID de cuenta ni nombre de tier: solo estado, edad de la evidencia y un motivo acotado.
¿Por qué un servicio Node.js puede estar “vivo” pero no listo para recibir tráfico?
Un proceso Node.js puede tener el event loop respondiendo perfectamente y aun así ser incapaz de medir el siguiente request de forma segura, porque liveness, readiness y refresh de capacidades responden tres preguntas distintas. La nota lo resume en una frase corta: “Alive is not ready” (vivo no es lo mismo que listo).
Liveness contesta si hay que reiniciar el proceso. Readiness contesta si esa instancia debe recibir nuevo tráfico medido. El refresh de capacidades contesta qué permite la cuenta externa en este momento, algo que ninguna de las otras dos señales puede saber por sí sola.
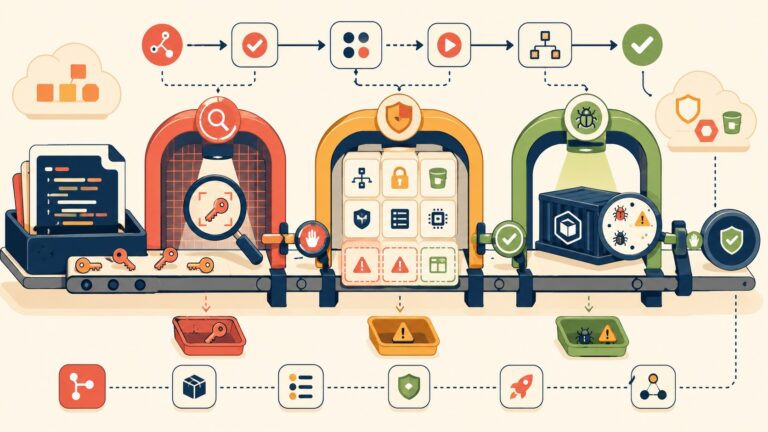
Fusionar las tres en un solo booleano te borra la razón por la que una instancia se retiró y empuja a la automatización a reaccionar de más. Si un pod se reinicia porque el health check devolvió false, pero el problema real era una credencial temporalmente sin refrescar, terminás matando instancias sanas mientras el problema de fondo sigue intacto. Esto se conecta con lo que analizamos en los checks de seguridad en pipelines AWS.
¿Qué diferencia hay entre los estados ready, degraded y not_ready en los health checks de Node.js?
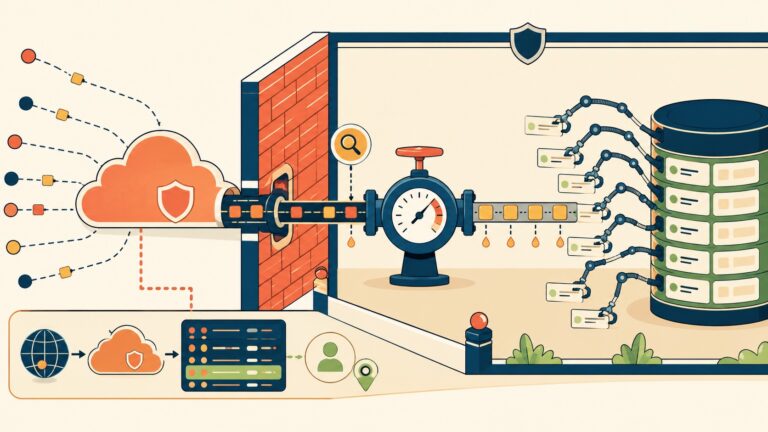
Ready significa que un chequeo reciente confirmó la credencial y la capacidad requerida, así que el nodo acepta tráfico medido sin restricciones. Degraded significa que el refresh falló pero la última evidencia exitosa sigue dentro de la ventana permitida, entonces el nodo sigue aceptando tráfico mientras emite una señal de edad. Not_ready significa que la credencial es inválida, falta la capacidad o la evidencia ya venció, y ahí el nodo rechaza tráfico nuevo.
| Estado | Evidencia | Decisión de enrutamiento |
|---|---|---|
| ready | Chequeo reciente confirmó credencial y capacidad | Acepta tráfico medido |
| degraded | Refresh falló, evidencia anterior sigue joven | Acepta tráfico, emite señal de edad |
| not_ready | Credencial inválida, capacidad ausente o evidencia vieja | Rechaza tráfico nuevo |
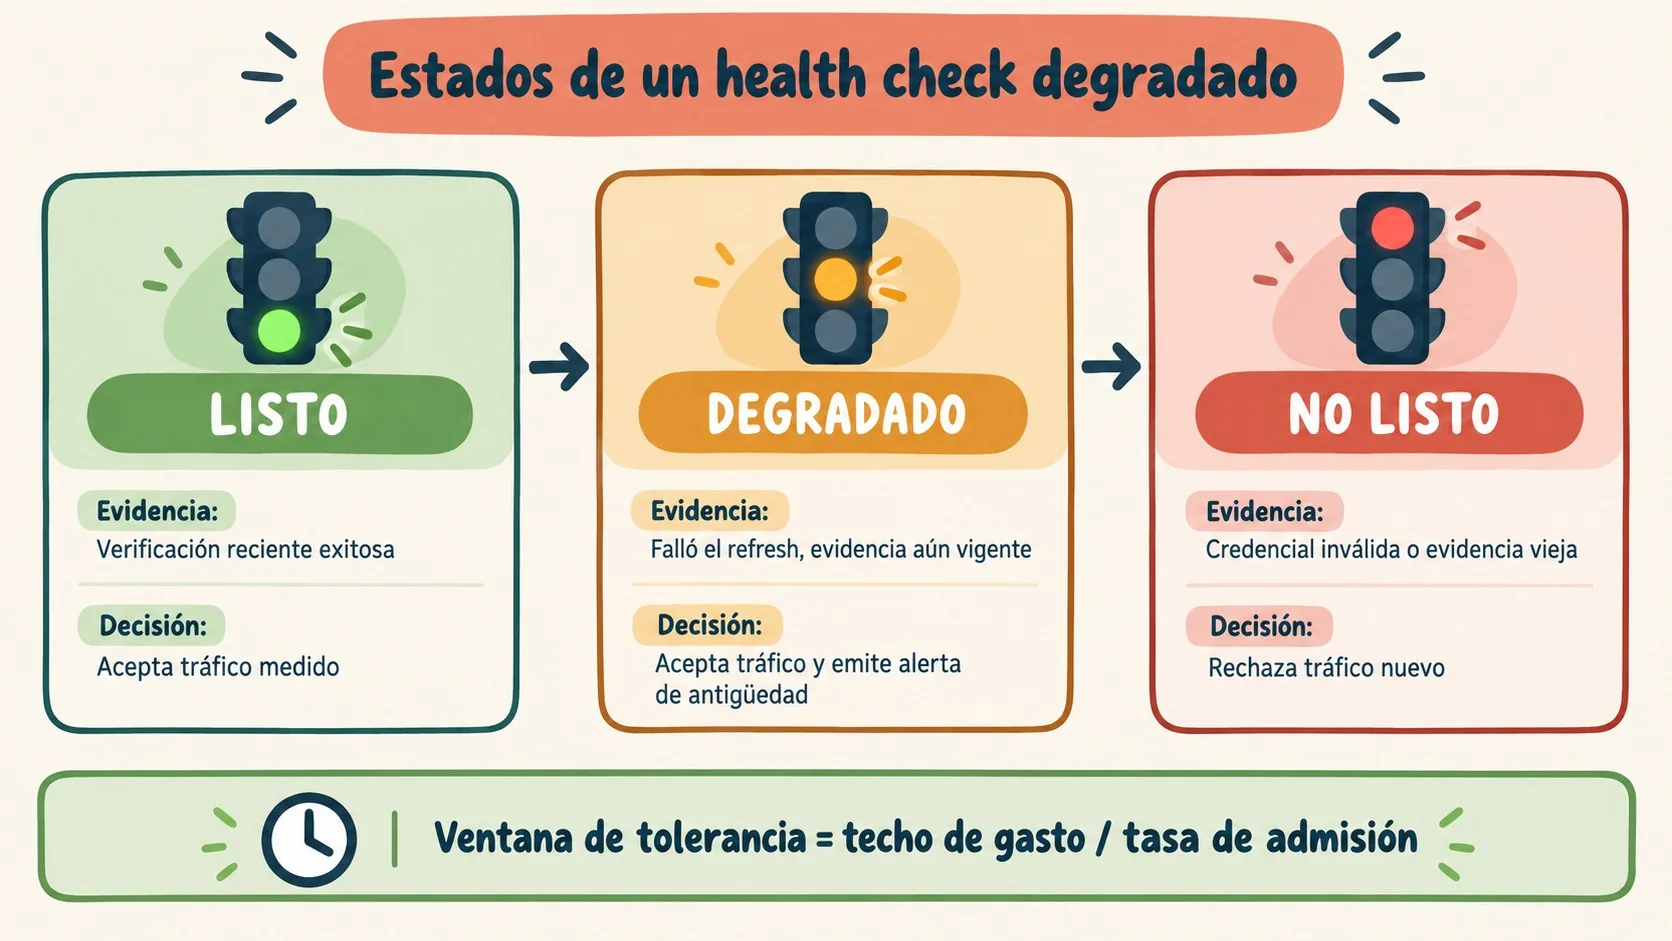
El caso raro, el que te puede complicar un jueves a la tarde, es el timeout. Un timeout no prueba que la credencial sea inválida, pero ignorarlo para siempre tampoco sirve: el sistema puede acumular uso contra un estado de cuenta que nunca verificó. La ventana de staleness es justo la línea entre esos dos riesgos.
¿Cómo se calcula la ventana de tolerancia a partir del techo de gasto?
La ventana de staleness no la elegís porque cinco segundos “parecen seguros”: la derivás del límite de negocio con la fórmula b/r, donde b son las unidades de exposición no verificada que el equipo tolera y r es la tasa máxima de admisión por segundo. Con múltiples nodos admitiendo en paralelo, usá la tasa agregada o repartí el presupuesto entre ellos.
El ejemplo de la nota es concreto: dos nodos que aceptan 20 unidades por segundo cada uno, con un techo de 200 unidades después del último resultado verificado, dan una ventana máxima de 5 segundos (200 dividido 40). Una ventana más corta rechaza tráfico antes; una más larga aumenta la exposición no verificada, así que subirla “un poco más” nunca es gratis. Cubrimos ese tema en detalle en cómo configurar circuit breakers y timeouts.
Ahora seguile el rastro a una falla real: los dos nodos refrescan bien al mediodía, la autoridad externa queda inaccesible, cada nodo sigue admitiendo a su tasa máxima contra evidencia cacheada que todavía es joven, juntos suman 40 unidades por segundo, y a los cinco segundos exactos ya consumieron el presupuesto completo de 200 unidades, momento en el que ambos tienen que retirarse antes de aceptar otro request. Si un nodo es dueño de solo un cuarto del presupuesto total, su corte local tiene que reflejar esa porción, no copiar la duración de toda la flota.
Ejemplo hipotético: qué pasa cuando escalás la flota sin tocar el techo
Este es un ejemplo hipotético con números distintos a los de la fuente, para mostrar un efecto que el artículo original no desarrolla. Imaginá una API de facturación por eventos con 3 nodos, cada uno admitiendo hasta 10 eventos por segundo, y un equipo que decide tolerar como máximo 90 eventos sin verificar. La tasa agregada es 30 eventos por segundo, así que la ventana sale en 90 / 30 = 3 segundos, más ajustada que el ejemplo de dos nodos de la fuente.
Ahora el punto que suele pasar desapercibido: si ese equipo escala a un cuarto nodo con la misma capacidad, pero nadie revisa el techo de 90, la tasa agregada sube a 40 eventos por segundo y la ventana recalculada baja a 90 / 40 = 2,25 segundos. Cada nodo nuevo que sumás sin ajustar el techo de gasto te achica el margen de tolerancia a fallas, no lo agranda. Si el equipo quisiera mantener la ventana original de 3 segundos con cuatro nodos, tendría que subir el techo a 120 eventos (3 × 40), lo que implica aceptar más exposición no verificada como contrapartida de tener más capacidad instalada. Ese es el trade-off real: escalar nodos sin revisar b es una decisión de riesgo silenciosa, aunque el código no cambie una línea.
¿Qué preguntas responder antes de fijar tu propio techo de gasto b?
La fórmula b/r es mecánica; el número b no lo es. Fijar b sin pensarlo es tan arbitrario como elegir cinco segundos porque “suena razonable”. Antes de poner un valor en el código, valen estas preguntas como criterio de decisión:
- ¿Cuánto podés absorber por cliente sin tocar el margen del plan que le vendiste? Ese número, no una sensación, debería marcar el piso de b.
- ¿Tu proceso de facturación permite ajustes retroactivos o el cobro queda firme apenas se emite? Si podés corregir una factura después, tolerás más exposición que si el cobro es irreversible.
- ¿Ese techo sigue siendo razonable si la flota crece? Como muestra el ejemplo anterior, agregar nodos sin revisar b reduce la ventana sin que nadie lo decida explícitamente.
- ¿Quién es dueño de la decisión de subir b? Si la respuesta es “nadie en particular”, probablemente el número actual tampoco lo decidió nadie con criterio de negocio.
¿Cómo evitar que un timeout tire todos los nodos a not_ready?
La clave está en distinguir un fallo indeterminado de un fallo definitivo: un timeout o un error de red no reescribe la última evidencia buena, mientras que un rechazo explícito de la autoridad externa (credencial inválida o capacidad ausente) sí la reemplaza de inmediato.
¿Y qué pasa si ese timeout se repite en varios nodos al mismo tiempo, por ejemplo porque la dependencia compartida tuvo un bache de latencia? Ahí entra la ventana de tolerancia: mientras la última evidencia buena siga joven, el nodo pasa a degraded, no a not_ready, y sigue sirviendo tráfico con la señal de edad prendida.
Ventanas muy chicas amplifican esto, porque generan más carga de refresh y más chance de fallo correlacionado entre nodos. La nota propone agendar los refrescos fuera del camino de la request con un intervalo aleatorio (en el ejemplo, entre 1,5 y 2,5 segundos), justamente para evitar que todos los nodos consulten a la autoridad externa en el mismo instante. Tema relacionado: armar un pipeline CI/CD para Node.js.
¿Qué datos no debe exponer nunca un endpoint de salud?
El body de /ready solo debe devolver tres cosas: el estado, la edad de la evidencia en segundos y un motivo de baja cardinalidad. Nada más, y eso no es un detalle menor cuando ese endpoint puede quedar expuesto a orquestadores, balanceadores o incluso a herramientas de monitoreo de terceros.
- Token o secreto de la API: jamás va en la respuesta del health check, ni siquiera parcial.
- Fingerprint de la credencial: identificar de forma indirecta qué credencial está en uso es información que un atacante puede correlacionar.
- ID de cuenta o nombre de tier: son datos de negocio que no aportan nada a un orquestador y sí exponen estructura interna.
- Body de error remoto: reenviar el mensaje crudo de la autoridad externa puede filtrar detalles de infraestructura que no le corresponden al consumidor del /ready.
La nota remite a la guía OWASP de gestión de secretos para todo lo que tiene que ver con almacenamiento, rotación y auditoría de credenciales, algo que va más allá del alcance del health check pero que conviene tener resuelto antes de escribir el primer endpoint.
Un dato de arquitectura que suele pasar desapercibido: el ejemplo de la fuente implementa el “sentinel” (el componente que cachea el resultado y expone /ready) como un servicio FastAPI en Python separado, que el worker Node.js consulta por localhost o por un boundary de servicio privado, no como código embebido en el mismo proceso Node. Separar el sentinel del servicio principal de esta forma facilita desplegarlos en instancias distintas dentro de la misma infraestructura, sin acoplar el ciclo de vida de uno al del otro.
Errores comunes al implementar health checks degradados
- Llamar a la API de cuenta en cada request: acopla la latencia remota a la disponibilidad local del servicio y convierte cualquier hipo del proveedor en una caída propia.
- Tratar todo timeout como credencial inválida: un fallo indeterminado no prueba nada sobre el estado de la cuenta, y sobrescribirlo así puede drenar toda la flota durante un problema temporal de red.
- Usar la misma ventana de staleness para todos los nodos sin dividir el presupuesto de exposición: si cada nodo copia la duración calculada para la flota completa, el sistema termina tolerando mucho más gasto no verificado del que el negocio autorizó.
- Compartir un caché entre nodos sin necesidad real: agrega otra dependencia al camino de admisión y hace que el presupuesto de gasto dependa del modelo de consistencia de ese caché compartido.
- Escalar la cantidad de nodos sin revisar el techo b: como en el ejemplo hipotético de arriba, sumar capacidad sin tocar el presupuesto de exposición achica la ventana de tolerancia sin que nadie lo haya decidido a propósito.
Lo que la fuente muestra es el mecanismo y un ejemplo numérico con dos nodos. Lo que no muestra es tu propia tasa de admisión ni tu propio techo de exposición tolerable: esos dos números los tenés que definir vos, con las preguntas de la sección anterior, antes de copiar la fórmula. Un criterio práctico para arrancar: corré el cálculo b/r con tus cifras reales de facturación, no con las del ejemplo, y compará el resultado contra la duración que ya usás en producción antes de tocar código.
Preguntas Frecuentes
¿Qué diferencia hay entre liveness y readiness en Node.js?
Liveness responde si el proceso tiene que reiniciarse, mientras que readiness responde si esa instancia debe recibir nuevo tráfico medido. Un proceso puede estar vivo (event loop respondiendo) y no estar listo, por ejemplo si su credencial de cuenta quedó sin verificar dentro de la ventana permitida. Relacionado: un enfoque similar para monitorear APIs Django.
¿Cómo se implementa un health check degradado en Node.js?
Se implementa cacheando el último resultado exitoso de validación de credencial y tier fuera del camino de la request, devolviendo ready, degraded o not_ready según la edad de esa evidencia, y usando un techo de gasto derivado de la tasa de admisión para decidir cuándo esa evidencia se considera demasiado vieja.
¿Por qué un readiness probe no debería llamar a la API de cuenta en cada request?
Porque acopla la latencia y la disponibilidad de un sistema remoto a la disponibilidad local del servicio, según plantea la nota de dev.to. Si la API de cuenta se pone lenta, cada probe se pone lento con ella, y eso puede hacer caer nodos que en realidad están perfectamente sanos.
¿Cuánto tiempo debe durar el caché de un health check de credenciales?
No hay un número universal: la duración se calcula con b/r, donde b es la exposición no verificada que tolerás y r es la tasa de admisión. En el ejemplo de la fuente, con 200 unidades de techo y 40 unidades por segundo entre dos nodos, la ventana máxima sale en 5 segundos. Ese número baja si sumás nodos sin revisar b, como muestra el ejemplo hipotético de este artículo.
¿Qué datos no debe devolver un endpoint /ready?
Un endpoint /ready nunca debe devolver el token de la API, un fingerprint de la credencial, el ID de cuenta, el nombre del tier ni el body crudo de un error remoto. Solo debe exponer el estado, la edad de la evidencia y un motivo de baja cardinalidad.
Conclusión
El aporte real de esta nota no es el código de ejemplo, es el orden de las decisiones: primero definís cuánta exposición no verificada tolera tu negocio, después calculás la ventana de staleness a partir de ese número, y recién ahí escribís el endpoint. Hacerlo al revés (elegir un cache de cinco segundos porque “suena razonable” y después justificarlo) es lo que termina generando incidentes de facturación que nadie puede explicar seis meses después.
Si tu servicio Node.js mide uso por cliente y todavía usa un booleano simple para readiness, el próximo paso lógico es separar liveness de readiness, sumar el estado degraded y calcular tu propia ventana con tus números reales de tasa de admisión y techo de gasto, no con los del ejemplo. Y si vas a escalar la flota, volvé a correr la cuenta: como vimos arriba, más nodos con el mismo techo significa menos margen, no más.